


50行Python代码实现高考志愿信息抓取与Excel导出

本文介绍如何使用仅50行Python代码批量抓取高考志愿信息。通过结合requests-html解析网页与openpyxl处理Excel,实现从URL列表读取、网页内容提取到数据写入的全流程。文中详细讲解了处理非结构化HTML、正则表达式分割学校名称及表格切片等关键技术点,并提供了完整的错误处理与代码示例,帮助开发者快速完成数据自动化任务。
Python抓取高考志愿信息实战
近期接到一个任务,需要将高考志愿信息整理为Excel表格。在获得包含目标网址的列表后,我独立完成了开发。尽管此前学习过Python爬虫技术,但因时间久远已生疏,经过一天的摸索与调试,最终成功完成任务。事实证明,利用Python处理此类任务相当便捷,最终代码仅50行便实现了全部功能。
准备工作与环境配置
准备工作
首先明确任务目标:从给定的网址列表中读取大量URL,依次访问每个页面以获取学校相关信息,最后将这些信息写入新的Excel文件中。为此,我们需要引入网页解析库和Excel处理库来辅助完成工作。
第一步是安装必要的依赖库。requests-html是一款优秀的HTML解析库,非常适合用于编写简洁优雅的爬虫程序;而openpyxl则是处理Excel文件的常用库,能够方便地创建和操作Excel数据。
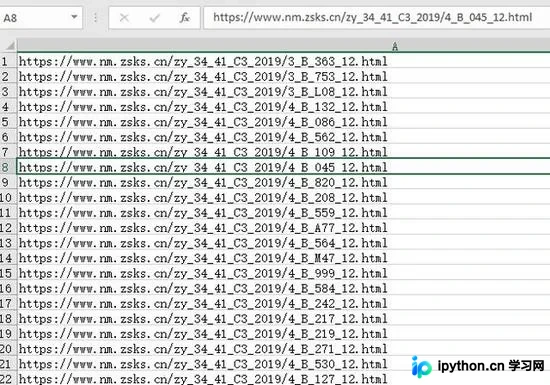
pip install requests-html openpyxl 接下来是处理输入的网址表格,其格式大致如下,包含约一千七百多条数据。其中存在少量无效网址,访问时会返回404错误,因此在编写代码时必须加入相应的错误处理机制。
任务分析与数据提取策略
任务分析
任务的核心在于分析并提取网页内容。首先,在浏览器中打开一个示例网址,观察页面上的数据结构。
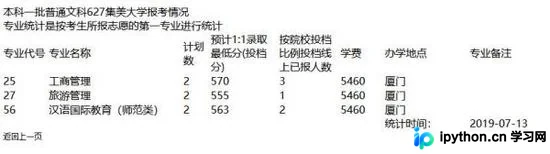
可以看到,该网页的格式较为混乱,学校名称等信息混杂在一起,缺乏统一规范,这增加了数据提取的难度。但经过仔细分析,问题并非不可解决。
首先提取学校名称。观察发现,学校名称与其他文字混合,例如“本科一批普通文科627集美大学报考情况”。起初尝试使用正则表达式提取,但发现难度较大。随后访问多个网页发现,学校代码多为数字,若有字母则通常位于首位。基于此规律,我采用了以下算法:首先按数字位置分割字符串,取右侧部分,该部分包含学校名称及“报考情况”字样,删除“报考情况”后即得学校名称。该算法的唯一潜在缺陷是若出现中间含字母的代号则无法正确提取,但实际运行中并未遇到此类情况。
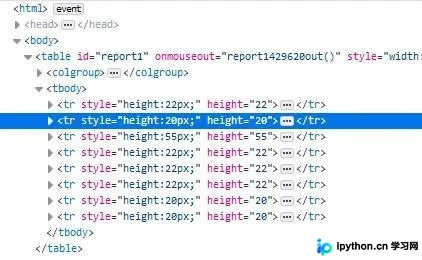
接下来提取专业信息。在网页源代码中,这部分数据通过tr和td标签呈现。起初尝试使用tr配合选择器提取,但由于网页生成时每个tr标签的样式随内容多少而变化,导致写死的选择器无法完美获取所有行。后来发现整个网页内容实际上是一个表格,除去表头和末尾几个固定行,剩余部分恰好是需要提取的数据行,因此直接获取所有tr标签并切片去除首尾即可。
网页结构分析基本完成,下面开始编写代码。
核心代码实现与逻辑解析
编写代码
总代码量约50行,已添加详细注释,相信读者可以轻松理解。
代码第一部分负责从网址表格读取所有URL。由于初始编写时表格中的URL由公式生成,因此在加载工作簿时需设置data_only=True以读取公式计算结果,否则只能获取到公式本身。
第二部分负责创建输出文件并编写表头。为方便调试,代码会检测目标文件是否已存在,若存在则先删除再重新创建。
第三部分是代码的核心逻辑。Python代码结构可能略显特殊,但结合前述分析应易于理解。需注意文件保存操作应放在最后,若中途代码出现异常,之前的工作将前功尽弃。鉴于一千七百多条网址无法保证全部正常运行,我将核心逻辑包裹在try-except块中,若出错仅打印出错的网址。由于输出格式要求为“学校名+专业信息”,在获取学校名称后,需将其插入到每行专业信息之前。
import os
from requests_html import HTMLSession
from openpyxl import Workbook, load_workbook
# 从网址表格获取urls
def get_urls():
 input_file = 'source.xlsx'
 wb = load_workbook(input_file, data_only=True)
 ws = wb.active
 urls = [row[0] for row in ws.values]
 wb.close()
 return urls
# 输出Excel文件,如果已存在则删除已有的
out_file = 'data.xlsx'
if os.path.exists(out_file):
 os.remove(out_file)
wb = Workbook()
ws = wb.active
# 编写第一行表头
ws['a1'] = '学校'
ws['b1'] = '专业代号'
ws['c1'] = '专业名称'
ws['d1'] = '计划数'
ws['e1'] = '预计1:1录取最低分(投档分)'
ws['f1'] = '按院校投档比例投档线上已报人数'
ws['g1'] = '学费'
ws['h1'] = '办学地点'
ws['i1'] = '专业备注'
# 发起网络请求,解析网页信息,并写入文件
session = HTMLSession()
urls = get_urls()
for url in urls:
 import re
 page = session.get(url)
 page.html.encoding = 'gb2312'
 try:
 college_info = page.html.xpath('//td[@class="report1_1_1"]/text()', first=True)
 college = re.split('\d+', college_info)[1].replace('报考情况', '')
 rows = page.html.xpath('//tr')[3:-2]
 for r in rows:
 info = [x.text for x in r.xpath('//td')]
 info.insert(0, college)
 ws.append(info)
 print(info)
 except:
 print(url)

# 保存文件
wb.save(out_file)
运行结果与总结
运行结果
经过大半天的努力,代码编写完成。现在运行代码查看结果。整个程序运行耗时约7-8分钟,最终生成一个500多KB的Excel文件。
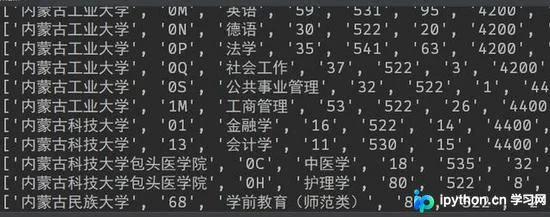
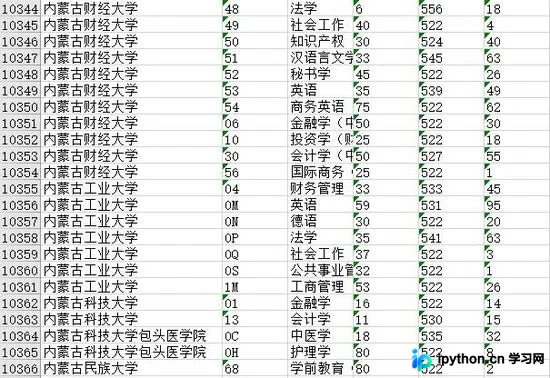
打开生成的文件,可以看到内容充实,最终共获取约一万多条数据,任务圆满完成。
总结
以上介绍了使用50行Python代码获取高考志愿信息的实现方法,希望对大家有所帮助。如有疑问请留言,小编会及时回复。感谢大家对本站的支持! 若本文对您有帮助,欢迎转载,请注明出处,谢谢!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















