


Python使用re.match()提取网页数据实战详解

本文详解Python中re模块的match()函数,通过百度视频网页源码实例,演示如何编写正则表达式提取电影名称与链接。涵盖文件读取、逐行匹配、分组提取及代码封装,帮助开发者掌握基础爬虫数据抓取技巧。
Python正则表达式match()函数基础
本文主要介绍Python中re模块下match()函数的具体用法,以及如何利用正则表达式从文本中提取特定数据。在深入使用re模块相关函数之前,建议先熟悉正则表达式中特殊字符的含义与规则。
准备测试数据与文件读取
首先,需要准备一个用于爬取数据的文本文档作为测试源。
具体做法是从任意网页直接复制部分源代码,将其粘贴到一个txt文件中,以便后续进行学习与实验。
操作十分简单:例如打开百度视频的热门电影页面,右键点击“查看网页源代码”,将复制的代码内容粘贴至txt文件中,并保存至当前工作目录下。
该文本文件通常包含4000多行代码,数据量较大。
re.match(pattern, string, flags=0)在调用match()函数时,主要涉及两个核心参数:pattern代表正则表达式模式,string代表被检测的目标字符串。
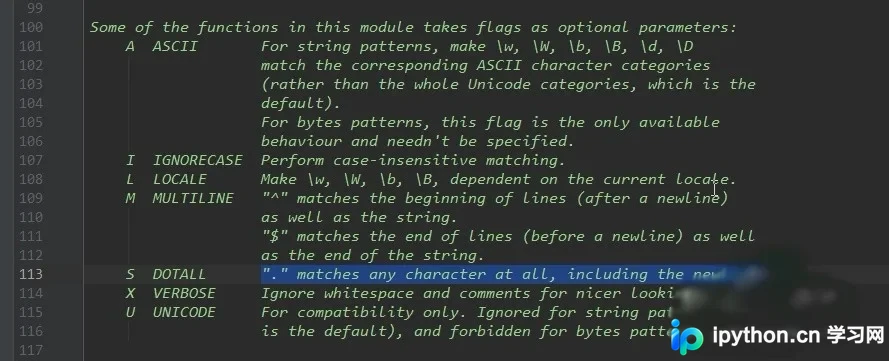
flags是可选参数,用于对pattern进行补充说明。例如设置re.S标志,可使正则表达式中的点号(.)匹配换行符\n。具体可用的标记值可查阅官方帮助文档或参考相关图片说明。
match()函数从左至右扫描string,若成功匹配正则表达式,则返回一个匹配对象;若未匹配,则返回None。
需要注意的是,re.match()仅匹配字符串的起始位置,而不会逐行匹配每行的开始处。
因此,为了利用match函数对每一行数据单独操作,我们需要将网页源码的每一行存入列表中。
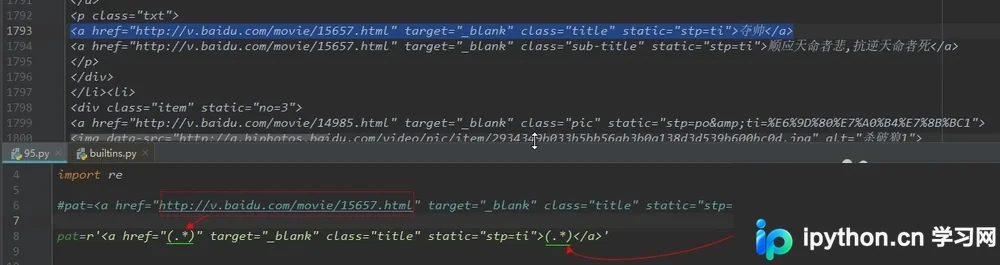
假设我们的目标是从文档中提取出电影的网址和电影名称。
第一步,复制包含目标信息的源代码行作为正则表达式的模板。
第二步,将模板中需要提取的网址和电影名部分替换为(.*),这仅是临时方案,后续可根据实际代码结构进行调整。
接下来开始读取文本文件。
使用with open()语句以只读模式打开文件;
调用readlines()方法一次性读取所有内容,该方法返回一个列表,列表中的每个元素对应文本的一行。
正则匹配与数据提取实现
with open('aa.txt','r',encoding='utf-8') as f:
  lines=f.readlines()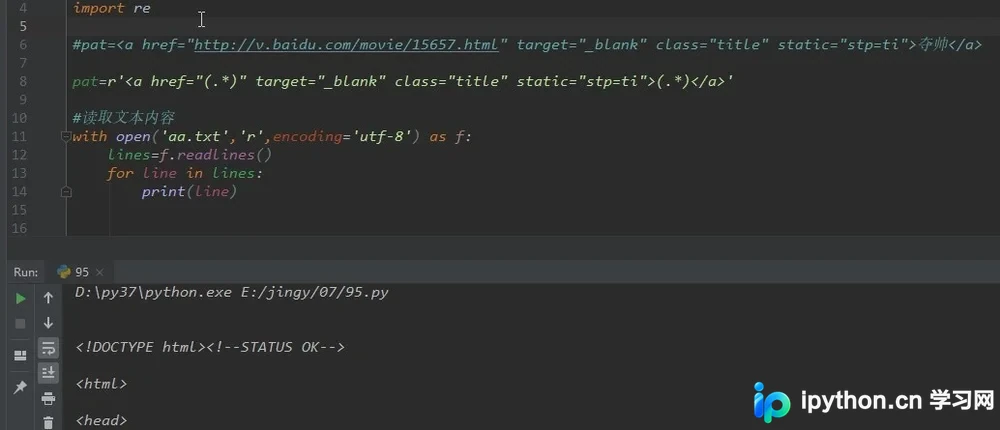
遍历列表时,判断每一行是否返回了有效的匹配对象;
接收该匹配对象,并利用groups()方法提取正则表达式中括号内捕获的内容;
数据过滤与结果封装
for line in lines:
  if re.match(pat,line):   #判断过滤掉返回None的行,
    ret=re.match(pat,line) #接收匹配对象
    print(ret.groups())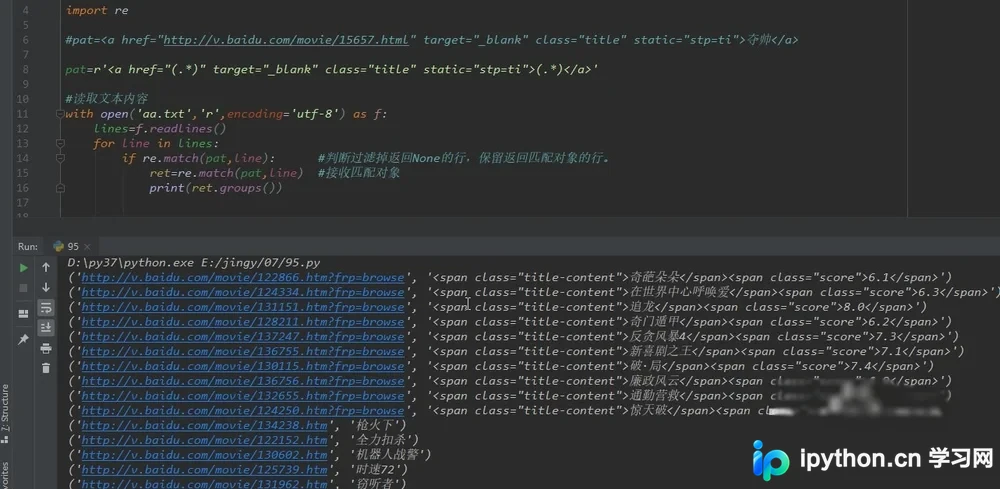
如果发现某些行不符合预期格式,需稍作修改以过滤掉这些无效行:
由于不符合条件的行通常包含空格或其他无关字符,可以将第二个子组中的点号(.)替换为非空格字符匹配模式[^ ],即表示匹配任意非空格字符,从而排除包含空格的无效行。
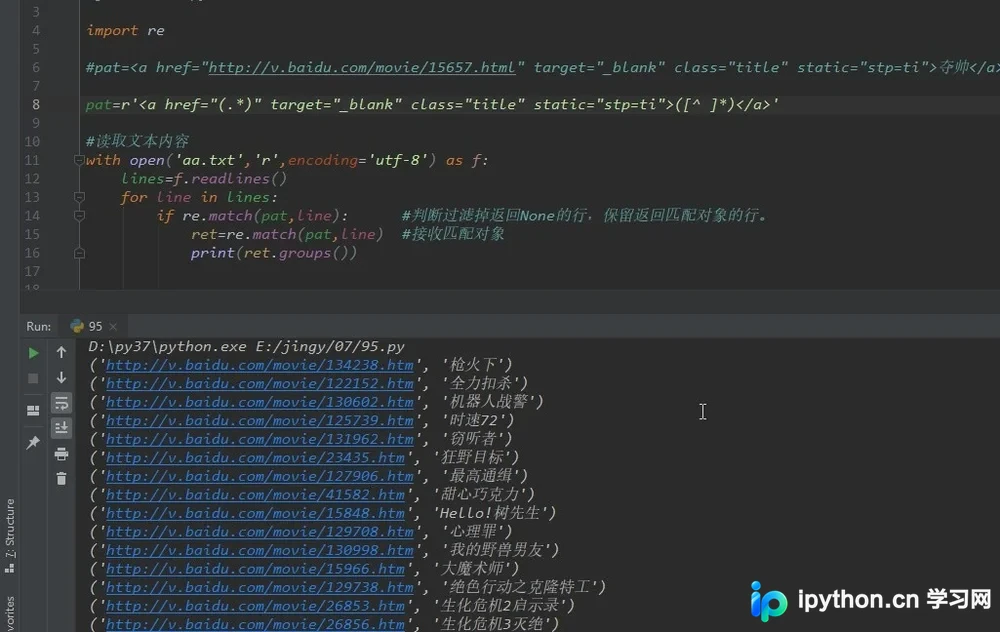
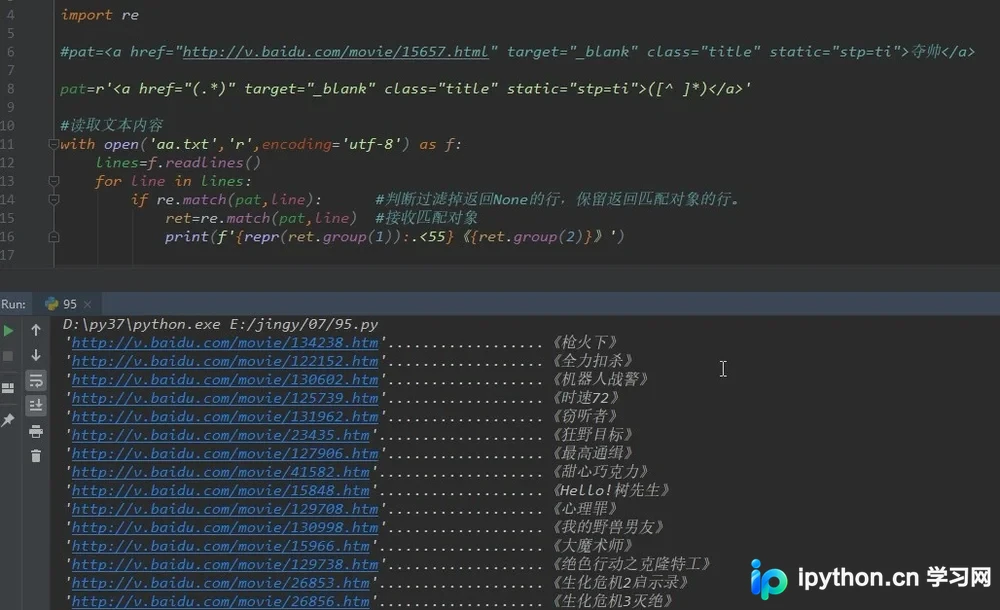
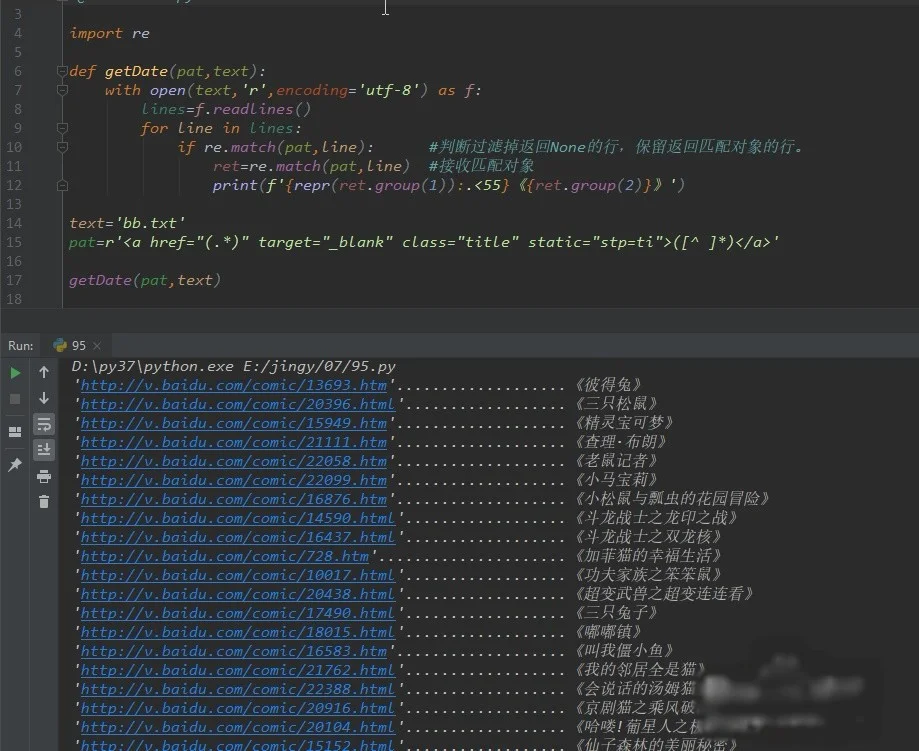
使用f-string格式化字符串对输出结果进行美化,通过group(1)和group(2)分别获取电影名和网址;
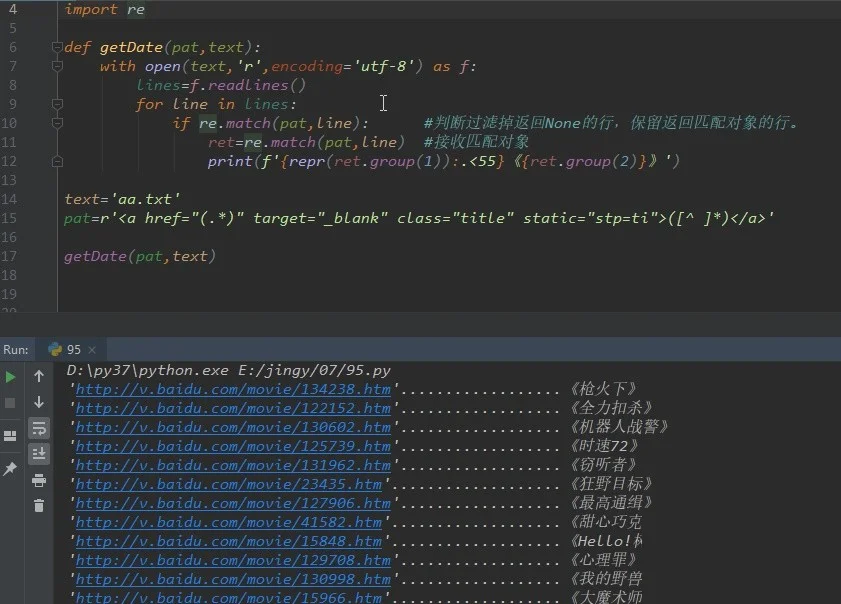
可以将上述逻辑封装为一个独立的函数,以便复用并爬取百度视频的其他栏目。
多栏目通用爬取测试
测试阶段:尝试爬取百度视频的电影、电视剧和动漫等栏目,由于这些栏目的网页格式基本一致,可直接套用上述封装好的函数。
具体操作中,打开百度视频的动漫页面,复制源代码并保存为bb.txt文件。
执行代码后,同样可以成功爬取到对应的网址和视频名称。
以上示例仅作为练习match()函数的案例。
以上就是关于Python如何使用match()函数爬取数据的全部内容,感谢大家的阅读和对本站的支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















