



在 Go 里处理网络协议、二进制文件或设备通信时,字节序是一个很容易被忽略、但一出错就很难排查的问题。很多时候数据本身没有错,真正出问题的是“这些字节应该按什么顺序解释”。下面就从大端、小端的基本概念讲起,再看 Go 标准库 `encoding/binary` 如何完成整数和结构体之间的字节序转换,帮助你判断什么时候该显式指定字节序。
什么是字节序
字节序,指的是一个多字节数据在计算机中存放时,以及输入、输出时各个字节的排列顺序。
常见的字节序主要分为两种:大端字节序和小端字节序。
小端字节序
小端字节序指一个数据单元在计算机中存放时,按照低位在低地址、高位在高地址的方式排列。
大端字节序
大端字节序指一个数据单元在计算机中存放时,按照低位在高地址、高位在低地址的方式排列。
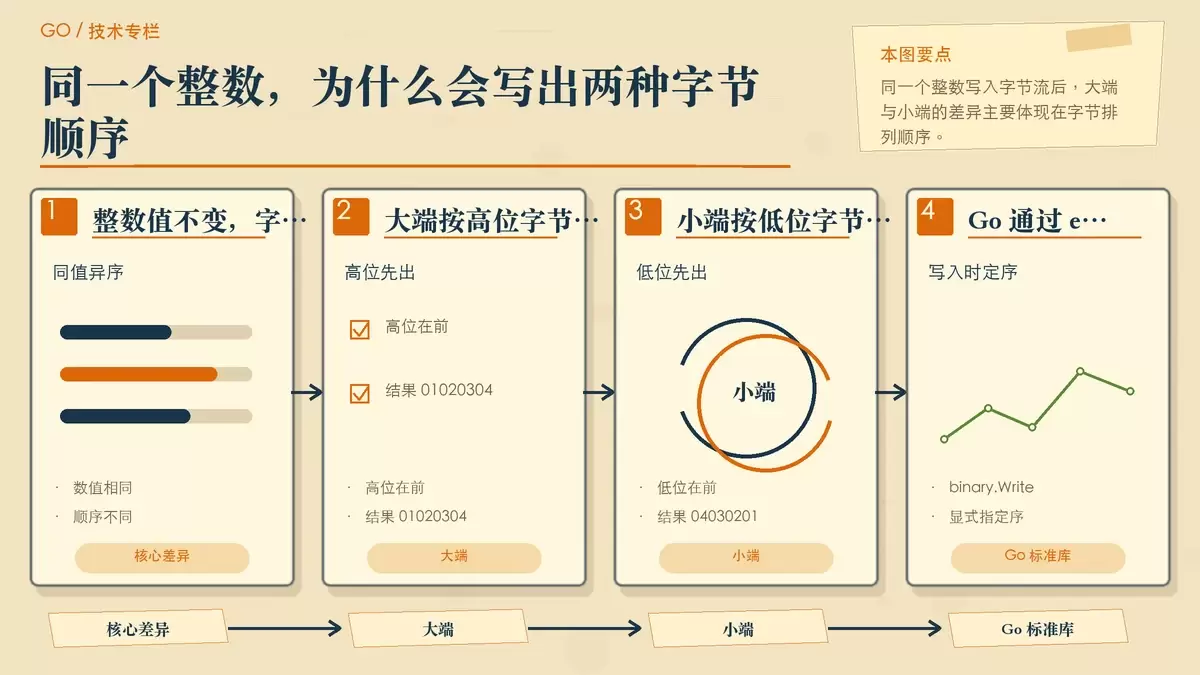
如果只看定义,这两个概念往往比较抽象。更实用的理解方式是:同一个整数写成字节流后,大端通常按“高位字节在前”,小端则按“低位字节在前”。这也是二进制协议里最常见的差异来源。
Go 里用什么处理字节序
Go 语言中,字节序转换主要通过标准库 encoding/binary 完成。这个包适合处理固定长度的二进制数据,常见场景包括整数编码、结构体写入和从字节流中还原数据。
最常用的两种字节序实现分别是:
binary.BigEndianbinary.LittleEndian
实际使用时,只要在读写时明确指定其中一种,就能保证编码和解码遵循同一套规则。
整数在大端和小端下的表现
先看一个整数转换的例子。这里使用 int32 类型的 0x01020304,分别按大端和小端写入缓冲区:
    var i int32 = 0x01020304  // 十六进制表示

    buffer := new(bytes.Buffer)
    binary.Write(buffer, binary.BigEndian, i) // 大端字节序

    fmt.Printf("BigEndian: %x n", buffer.Bytes()) // 01020304

    buffer = new(bytes.Buffer)
    binary.Write(buffer, binary.LittleEndian, i) // 小端字节序

    fmt.Printf("BigEndian: %x n", buffer.Bytes()) // 04030201
这个例子说明了同一个数值在不同字节序下,会生成不同的字节排列结果:
- 大端输出:
01020304 - 小端输出:
04030201
也就是说,数值本身没有变,变化的是它被拆成多个字节后在字节流中的顺序。
这类差异在网络传输、跨语言通信、读取二进制文件时尤其关键。只要发送端和接收端对字节顺序的理解不一致,读出来的数据就会完全不同。
结构体也可以批量转换
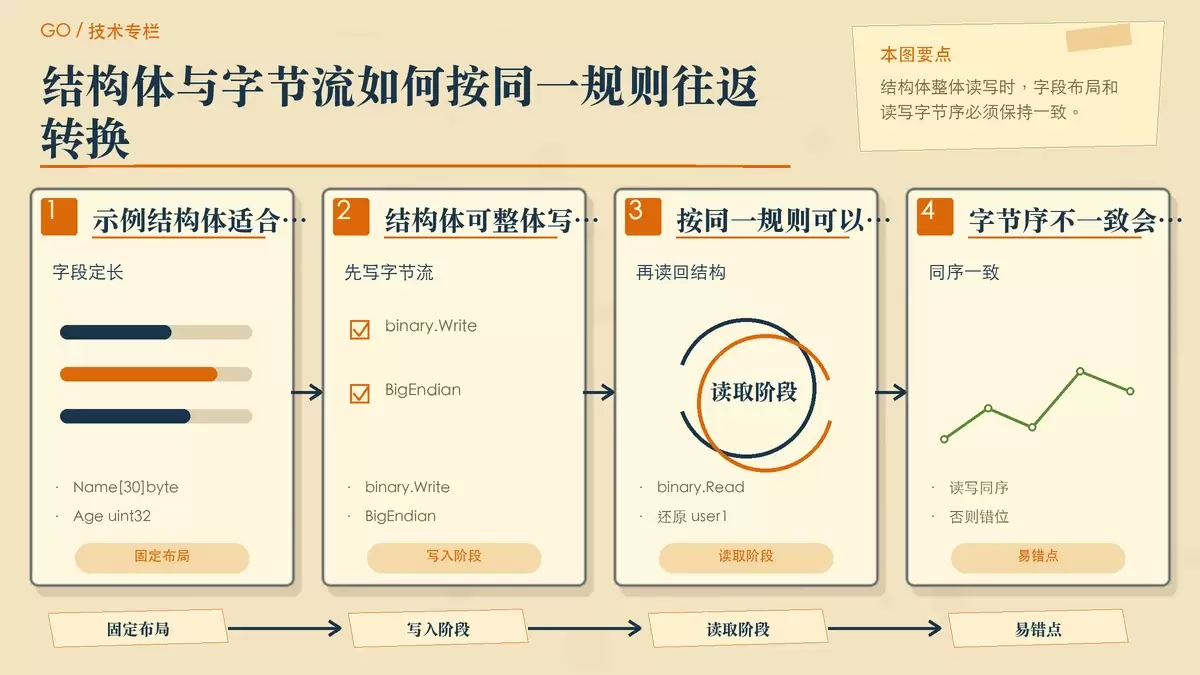
除了基本整数,encoding/binary 也支持把结构体整体写入字节流,或者从字节流中按指定字节序读回结构体。
示例代码如下:
    type User struct {
        Name [30]byte
        Age  uint32
    }

    user := User{}
    copy(user.Name[:], "John Wilson")
    user.Age = 30

    buffer := new(bytes.Buffer)
    binary.Write(buffer, binary.BigEndian, &user) // 批量转为大端字节序

    var user1 User
    binary.Read(buffer, binary.BigEndian, &user1) // 批量转回结构体
这段代码展示了两个常见操作:
- 通过
binary.Write将结构体按指定字节序写入缓冲区 - 通过
binary.Read按同样的字节序从缓冲区恢复结构体
这里的关键点不是“结构体能不能转”,而是读和写必须使用同一种字节序。如果写入时使用 binary.BigEndian,读取时却改成 binary.LittleEndian,得到的数据就会出现错误。
另外,这种方式更适合固定布局的数据结构。像示例里的 Name [30]byte 和 Age uint32 都是长度明确、布局稳定的字段,因此很适合直接做二进制读写。
什么时候必须关心字节序
在日常 Go 开发中,并不是所有场景都要手动处理字节序。但只要碰到下面这些情况,就应该明确检查:
- 和网络协议打交道时,协议通常会规定使用大端或小端
- 读写二进制文件格式时,格式文档一般会写明字节顺序
- 与其他语言、其他系统或硬件设备通信时,双方必须统一解释方式
- 把结构体直接编码成字节流时,需要确认字段类型和读写顺序一致
如果只是处理普通字符串、JSON 或常规业务对象,通常不需要自己考虑字节序;但一旦进入二进制层,字节序就不是细节,而是协议的一部分。















