


Python Pandas中cumsum函数实现按用户累计安装次数统计

发布时间:2026-10-13 |
4人浏览过
本文介绍如何利用Python Pandas库中的cumsum函数,结合groupby操作,实现按用户ID分组统计历史累计安装次数。通过具体数据集示例,演示从数据分组到计算累加值的全过程,帮助开发者快速掌握累计统计技巧。
cumsum函数应用场景与数据说明
本文主要介绍Pandas库中cumsum函数的具体应用方法。为了更清晰地展示其使用场景,下文将结合一个具体的数据集进行说明。
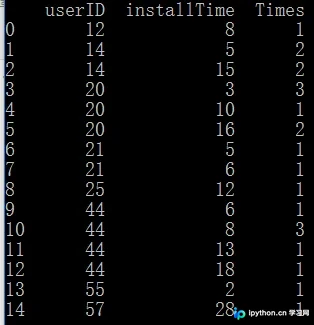
该数据集包含三列信息:第一列为userID(用户ID),第二列为安装时间,第三列为每次的安装次数。
我们的目标是统计每位用户在特定日期之前的累计安装总次数。
例如,针对userID为20的用户,查询其在16天前的累计安装次数,结果应为4次。使用Python实现这一需求非常简便。
再比如,对于userID为44的用户,其在19天前的累计安装次数为1+3+1+1=6次。
Python代码实现步骤
具体实现代码如下(假设数据集变量名为data):
由于计算需要针对每个userID分别进行,因此首先需要对数据进行分组处理(关于组内排序的方法,可参考之前的相关文章)。
因此,我们需要执行以下分组操作:
groupby(['userID'])分组完成后,针对需要统计的Times列进行操作,代码如下:
data['Times'].groupby(['userID'])最后,为了获取累加结果,我们调用cumsum()函数。
data['sum_Times']=data['Times'].groupby(['userID']).cumsum()将计算得到的结果赋值给新的一列。
最终生成的结果如下所示:
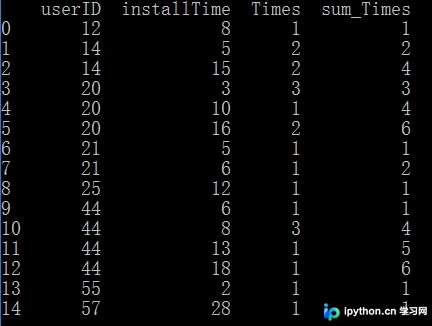
观察sum_Times这一列可以发现,每个值都是对应当前userID在前一行基础上的累加结果。
以上内容即为本文的全部介绍,希望能对读者的学习有所帮助,也欢迎大家继续支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















