


Python实战:利用jieba与pyecharts解析《红楼梦》人物关系图谱

本文介绍如何使用Python对《红楼梦》文本进行数据处理与可视化。通过jieba库进行自定义词典分词,清洗文本并统计人物出场频率;利用共现算法构建人物关系网络,最后借助pyecharts生成直观的人物关系图谱,展示主要角色间的互动强度。
引言与背景
前言
今天,一起用 Python 来理一理红楼梦里的那些关系
不必追问为何选择《红楼梦》而非《水浒传》《三国演义》或《西游记》,因为笔者坚信,《红楼梦》是中国古典小说中无可争议的巅峰之作,此观点不容反驳。这部作品也是笔者反复研读、情感最为深厚的少数小说之一。
闲话少说,直接进入正题。
数据准备与词典构建
数据准备
需要准备一份《红楼梦》的 TXT 格式文本文件。
同时,整理一份包含“金陵十二钗”及贾宝玉的人物名称列表。
具体的人物列表内容如下:
自定义人名词典示例
宝玉 nr
黛玉 nr
宝钗 nr
湘云 nr
凤姐 nr
李纨 nr
元春 nr
迎春 nr
探春 nr
惜春 nr
妙玉 nr
巧姐 nr
秦氏 nr
该列表同时作为分词时的自定义词典使用,其中“nr”代表人名(Person Name)。
文本读取与分词处理
数据处理
读取数据并加载自定义词典。
数据加载代码实现
  with open("红楼梦.txt", encoding='gb18030') as f:
    honglou = f.readlines()
  jieba.load_userdict("renwu_forcut")
  renwu_data = pd.read_csv("renwu_forcut", header=-1)
  mylist = [k[0].split(" ")[0] for k in renwu_data.values.tolist()]
执行上述代码后,《红楼梦》的内容被读取至 honglou 变量中,并通过 load_userdict 方法将自定义词典加载至 jieba 库,确保分词时能准确识别特定人名。
对文本进行分词处理并提取关键信息。
分词与统计逻辑
tmpNames = []
  names = {}
  relationships = {}
  for h in honglou:
    h.replace("贾妃", "元春")
    h.replace("李宫裁", "李纨")
    poss = pseg.cut(h)
    tmpNames.append([])
    for w in poss:
      if w.flag != 'nr' or len(w.word) != 2 or w.word not in mylist:
        continue
      tmpNames[-1].append(w.word)
      if names.get(w.word) is None:
        names[w.word] = 0
      relationships[w.word] = {}
names[w.word] += 1- 首先,针对文中“贾妃”与“元春”、“李宫裁”与“李纨”混用的情况,直接进行字符串替换处理以统一名称。
- 随后,调用 jieba 库提供的 pseg 工具进行分词,该工具会返回每个分词及其对应的词性。
- 接着进行过滤判断,仅保留词性符合且存在于预设字典列表中的分词。
- 统计每个人物出现的次数,数值累加,以便后续绘制关系图时根据频率确定人物节点(node)的大小。
- 将存在于自定义词典中的人名保存至临时变量 tmpNames 中,供后续关系分析使用。
处理人物关系
人物关系网络构建
  for name in tmpNames:
    for name1 in name:
      for name2 in name:
        if name1 == name2:
          continue
        if relationships[name1].get(name2) is None:
          relationships[name1][name2] = 1
        else:
          relationships[name1][name2] += 1
逻辑设定为:若多个人物出现在同一段落中,则判定他们关系紧密。每同时出现一次,两者之间的关系权重增加1。
保存处理结果至文件。
关系数据导出
  with open("relationship.csv", "w", encoding='utf-8') as f:
    f.write("Source,Target,Weight\n")
    for name, edges in relationships.items():
      for v, w in edges.items():
        f.write(name + "," + v + "," + str(w) + "\n")

  with open("NameNode.csv", "w", encoding='utf-8') as f:
    f.write("ID,Label,Weight\n")
    for name, times in names.items():
f.write(name + "," + name + "," + str(times) + "\n")- 生成文件1:人物关系表,包含起始人物、目标人物以及共同出现的次数。
- 生成文件2:人物比重表,包含该人物的总出场次数,出场频率越高,代表其在文本中的比重越大。
可视化图表生成
制作关系图表
使用 pyecharts 库进行可视化绘图。
pyecharts绘图代码
def deal_graph():
  relationship_data = pd.read_csv('relationship.csv')
  namenode_data = pd.read_csv('NameNode.csv')
  relationship_data_list = relationship_data.values.tolist()
  namenode_data_list = namenode_data.values.tolist()

  nodes = []
  for node in namenode_data_list:
    if node[0] == "宝玉":
      node[2] = node[2]/3
    nodes.append({"name": node[0], "symbolSize": node[2]/30})
  links = []
  for link in relationship_data_list:
    links.append({"source": link[0], "target": link[1], "value": link[2]})

  g = (
    Graph()
    .add("", nodes, links, repulsion=8000)
    .set_global_opts(title_opts=opts.TitleOpts(title="红楼人物关系"))
  )
  return g
首先,将前述两个CSV文件读取为列表形式以便处理。
针对“宝玉”这一角色,由于其出场占比过大,若直接统一缩放会导致其他人物节点过小、展示效果不佳。因此,代码中对宝玉的相关数据进行了特定的缩放处理(除以3)。
最终生成的关系图展示了人物间的连接与权重。
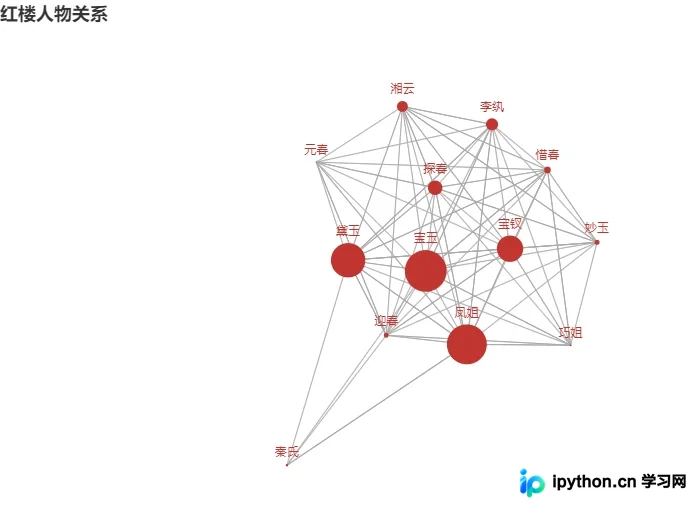
所有相关代码已上传至 Github 仓库。
此外,笔者还准备了一份更为全面的红楼人物字典“renwu_total”,存放于代码仓库中。感兴趣的用户可以尝试使用该字典,制作涵盖所有人物的完整关系图。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















