


Python爬虫实战:利用Requests模块解析豆瓣电影Ajax接口

发布时间:2026-10-13 |
5人浏览过
本文详解如何使用Python的Requests模块发起Ajax GET请求以爬取豆瓣电影分类排行榜数据。通过抓包工具定位异步加载的接口,解析返回的JSON字符串,并调整start和limit参数获取不同范围的电影详情,实现高效的数据抓取。
基于Requests模块发起Ajax的GET请求
基于Requests模块发起Ajax的GET请求
豆瓣电影数据爬取需求
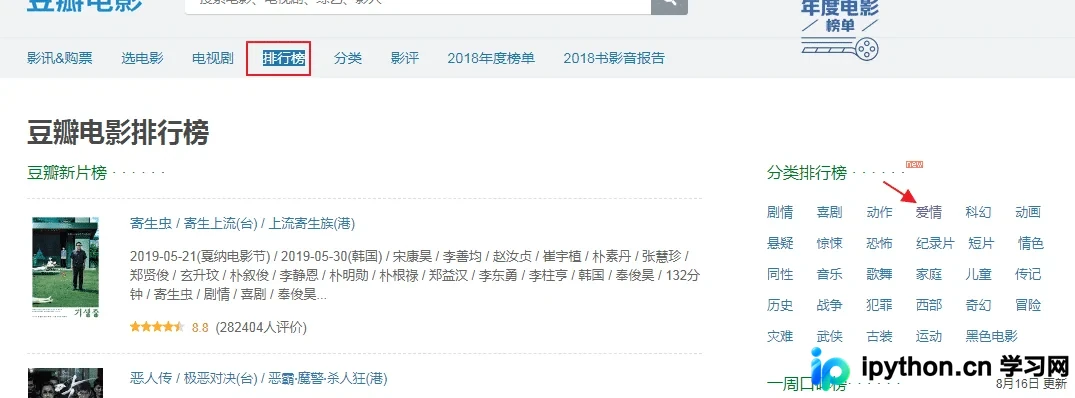
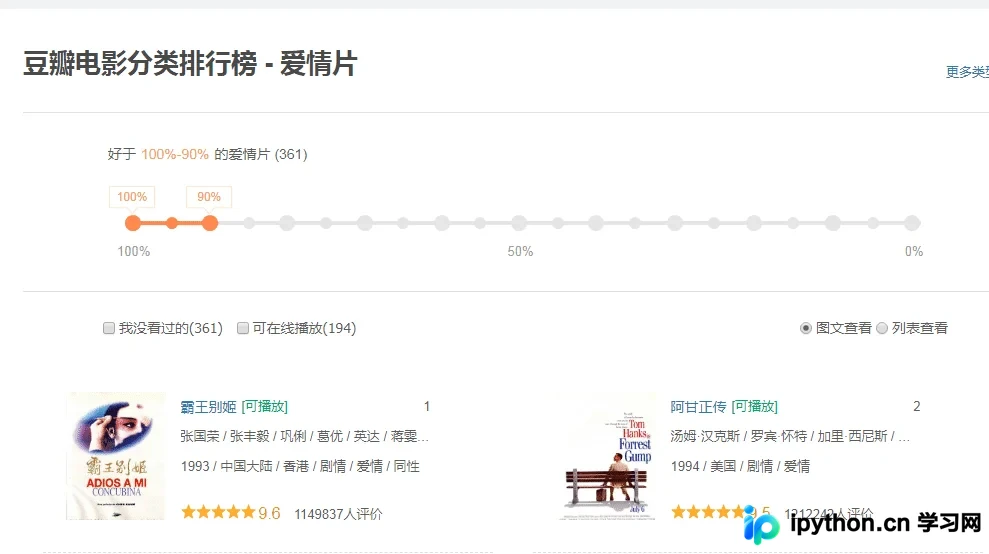
目标需求:爬取豆瓣电影分类排行榜(https://movie.douban.com/)中的电影详情数据。
抓包工具定位Ajax请求
首先,使用抓包工具捕获页面加载过程中由Ajax触发的网络请求。
滚动加载与局部刷新机制
当鼠标向下滚动滚轮时,页面会加载更多电影信息。这种局部刷新机制是由当前页面发起的Ajax请求实现的。
捕获底部刷新请求
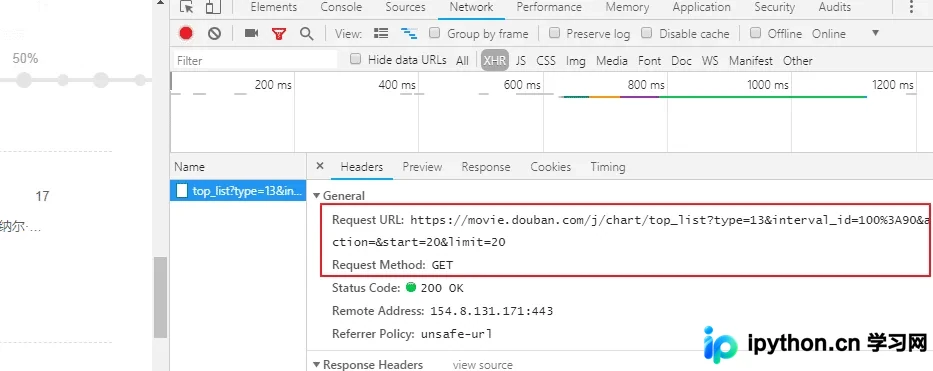
利用抓包工具捕捉页面刷新时的Ajax GET请求,重点捕获当滚轮拖动至底部时发起的网络请求。
确定请求URL
该GET请求的URL即为本次需要发起请求的目标地址。
解析请求参数
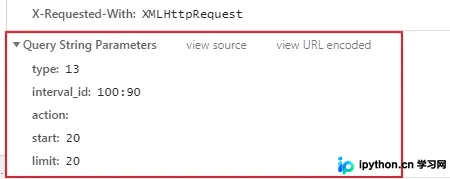
分析Ajax GET请求所携带的具体参数。
响应内容与JSON数据解析
获取的响应内容不再是完整的HTML页面数据,而是JSON格式的字符串,其中包含了通过异步请求获取的电影详情信息。
关键参数start与limit的作用
需要注意的是start和limit参数,修改这两个参数将获取到不同的电影详情列表。
代码实现:发起请求与数据提取
import requests
import json
# 指定ajax-get请求的url(通过抓包进行获取)
url = 'https://movie.douban.com/j/chart/top_list?'
# 封装ajax的get请求携带的参数(从抓包工具中获取) 封装到字典
param = {
  'type': '13',
  'interval_id': '100:90',
  'action': '',
  'start': '20', # 从第20个电影开始获取详情
  'limit': '20', # 获取多少个电影详情
  # 改变这两个参数获取的电影详情不一样
}
# 定制请求头信息,相关的头信息必须封装在字典结构中
headers = {
  'User-Agent': 'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/66.0.3359.181 Safari/537.36',
}
# 发起ajax的get请求还是用get方法
response = requests.get(url=url,params=param,headers=headers)

# 获取响应内容:响应内容为json字符串
data = response.text
data = json.loads(data)
for data_dict in data:
  print(data_dict["rank"],data_dict["title"])

'''
芙蓉镇
沉静如海
淘金记
马戏团
情迷意乱
士兵之歌
战争与和平
怦然心动
大话西游之月光宝盒
罗马假日
音乐之声
一一
雨中曲
我爱你
莫娣
卡比利亚之夜
婚姻生活
本杰明·巴顿奇事
情书
春光乍泄
'''
参数配置示例
例如,设置从第21部电影开始获取信息,总共获取20部电影的详情数据。
总结
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















