


Python实现朴素贝叶斯的学习与分类过程解析

本文深入解析朴素贝叶斯算法原理,基于贝叶斯定理并通过条件独立性假设简化计算。文章详细推导了从特征向量到类别概率的转换过程,并提供Python完整实现代码,涵盖模型训练与分类预测,适合希望理解并应用该算法的开发者参考。
朴素贝叶斯算法原理概述
概念简介
朴素贝叶斯算法的核心基础是贝叶斯定理。其“朴素”之处在于假设输入随机变量的各个特征值之间是条件独立的。为了便于理解,我们先简要回顾贝叶斯定理的基本形式:
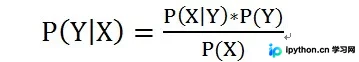
乍看之下,该公式似乎要求计算一个目标概率,同时需要先获取另外三个概率值,这是否具备实际价值?事实上,这个简洁的公式高度契合人类的推理逻辑,即通过已观测的数据来推断未直接观测的信息。例如,身处办公室时虽无法直接知晓室外天气,但若观察到同事携带雨伞,便可推断外面大概率正在下雨。
在分类任务中,设X为输入的随机变量,Y为目标输出类别。对X进行分类的目标,即求解使后验概率P(Y|X)达到最大的Y值。若X由n维特征变量组成,表示为X = {A1, A2, …..An},而输出类别集合为Y = {C1, C2, …. Cm},则需基于这些特征进行类别判定。
确定X所属的最可能类别y的公式为 y = argmax P(Y|X)。具体的数学推导过程如下:
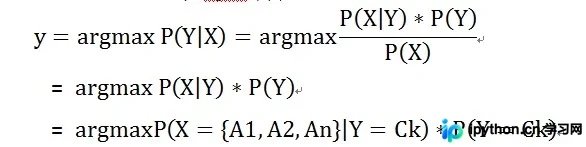
模型训练与分类实现
朴素贝叶斯的学习过程
根据上述公式,要得出分类结果,必须掌握以下关键变量:
各个类别的先验条件概率
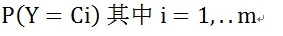
输入随机变量各特征值的条件概率
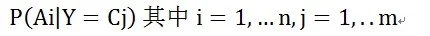
示例代码
import copy

class native_bayes_t:

  def __init__(self, character_vec_, class_vec_):
    """
    构造的时候需要传入特征向量的值,以数组方式传入
    参数1 character_vec_ 格式为 [("character_name",["","",""])]
    参数2 为包含所有类别的数组 格式为["class_X", "class_Y"]
    """
    self.class_set = {}
    # 记录该类别下各个特征值的条件概率
    character_condition_per = {}
    for character_name in character_vec_:
      character_condition_per[character_name[0]] = {}
      for character_value in character_name[1]:
        character_condition_per[character_name[0]][character_value] = {
          'num'      : 0, # 记录该类别下该特征值在训练样本中的数量,
          'condition_per' : 0.0 # 记录该类别下各个特征值的条件概率
        }
    for class_name in class_vec:
      self.class_set[class_name] = {
        'num'           : 0, # 记录该类别在训练样本中的数量,
        'class_per'        : 0.0, # 记录该类别在训练样本中的先验概率,
        'character_condition_per' : copy.deepcopy(character_condition_per),
      }

    #print("init", character_vec_, self.class_set) #for debug

  def learn(self, sample_):
    """
    learn 参数为训练的样本,格式为
    [
      {
        'character' : {'character_A':'A1'}, #特征向量
        'class_name' : 'class_X'       #类别名称
      }
    ]
    """
    for each_sample in sample:
      character_vec = each_sample['character']
      class_name   = each_sample['class_name']

      data_for_class = self.class_set[class_name]
      data_for_class['num'] += 1

      # 各个特质值数量加1
      for character_name in character_vec:
        character_value = character_vec[character_name]
        data_for_character = data_for_class['character_condition_per'][character_name][character_value]

        data_for_character['num'] += 1

    # 数量计算完毕, 计算最终的概率值
    sample_num = len(sample)
    for each_sample in sample:
      character_vec = each_sample['character']
      class_name  = each_sample['class_name']

      data_for_class = self.class_set[class_name]
      # 计算类别的先验概率
      data_for_class['class_per'] = float(data_for_class['num']) / sample_num

      # 各个特质值的条件概率
      for character_name in character_vec:
        character_value = character_vec[character_name]

        data_for_character = data_for_class['character_condition_per'][character_name][character_value]

        data_for_character['condition_per'] = float(data_for_character['num']) / data_for_class['num']

    from pprint import pprint
    pprint(self.class_set) #for debug

  def classify(self, input_):
    """
      对输入进行分类,输入input的格式为
    {
      "character_A":"A1",
      "character_B":"B3",
    }
    """
    best_class = ''
    max_per  = 0.0
    for class_name in self.class_set:
      class_data = self.class_set[class_name]
      per = class_data['class_per']
      # 计算各个特征值条件概率的乘积
      for character_name in input_:
        character_per_data = class_data['character_condition_per'][character_name]
        per = per * character_per_data[input_[character_name]]['condition_per']
      print(class_name, per)
      if per >= max_per:
        best_class = class_name

    return best_class

character_vec = [("character_A",["A1","A2","A3"]), ("character_B",["B1","B2","B3"])]
class_vec   = ["class_X", "class_Y"]
bayes = native_bayes_t(character_vec, class_vec)


sample = [
      {
        'character' : {'character_A':'A1', 'character_B':'B1'}, #特征向量
        'class_name' : 'class_X'       #类别名称
      },
      {
        'character' : {'character_A':'A3', 'character_B':'B1'}, #特征向量
        'class_name' : 'class_X'       #类别名称
      },
      {
        'character' : {'character_A':'A3', 'character_B':'B3'}, #特征向量
        'class_name' : 'class_X'       #类别名称
      },
      {
        'character' : {'character_A':'A2', 'character_B':'B2'}, #特征向量
        'class_name' : 'class_X'       #类别名称
      },
      {
        'character' : {'character_A':'A2', 'character_B':'B2'}, #特征向量
        'class_name' : 'class_Y'       #类别名称
      },
      {
        'character' : {'character_A':'A3', 'character_B':'B1'}, #特征向量
        'class_name' : 'class_Y'       #类别名称
      },
      {
        'character' : {'character_A':'A1', 'character_B':'B3'}, #特征向量
        'class_name' : 'class_Y'       #类别名称
      },
      {
        'character' : {'character_A':'A1', 'character_B':'B3'}, #特征向量
        'class_name' : 'class_Y'       #类别名称
      },

    ]

input_data ={
  "character_A":"A1",
  "character_B":"B3",
}

bayes.learn(sample)
print(bayes.classify(input_data))
总结
朴素贝叶斯分类器的实现相对简单,且具有较高的预测效率。
需要注意的是,朴素贝叶斯成立的前提假设是特征向量中的各个属性条件独立。因此,在建模过程中需特别注意这一假设是否符合实际数据分布。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















