


Ubuntu下Python使用Tesseract进行OCR文字识别的完整指南

发布时间:2026-10-13 |
5人浏览过
本文详细介绍在Ubuntu系统中配置Python环境以实现基于Tesseract的OCR文字识别功能。涵盖tesseract-ocr、pytesseract及Pillow库的安装步骤,提供完整的Python识别代码示例。针对中文识别缺失训练包的问题,给出chi_sim训练数据的安装方法,并说明中英文识别效果的差异。
Ubuntu下Python Tesseract OCR配置与代码示例
本文主要演示如何在Python中利用Tesseract引擎实现文字识别功能,通过详细的代码示例帮助读者掌握相关技术,适用于学习与实际工作场景。
本文基于Ubuntu操作系统环境进行说明。
Tesseract引擎安装
首先需完成Tesseract OCR引擎的安装。
sudo apt-get install tesseract-ocrPython库依赖安装
接着安装Python绑定的pytesseract库。
sudo pip install pytesseract随后安装图像处理库Pillow以支持图片读取。
sudo pip install pillow识别代码实现与问题排查
完成依赖安装后,即可编写识别代码。
from PIL import Image
from pytesseract import pytesseract
image = Image.open('test.png')
code = pytesseract.image_to_string(image,lang='chi_sim')
print(code)
运行代码时可能会遇到报错情况。

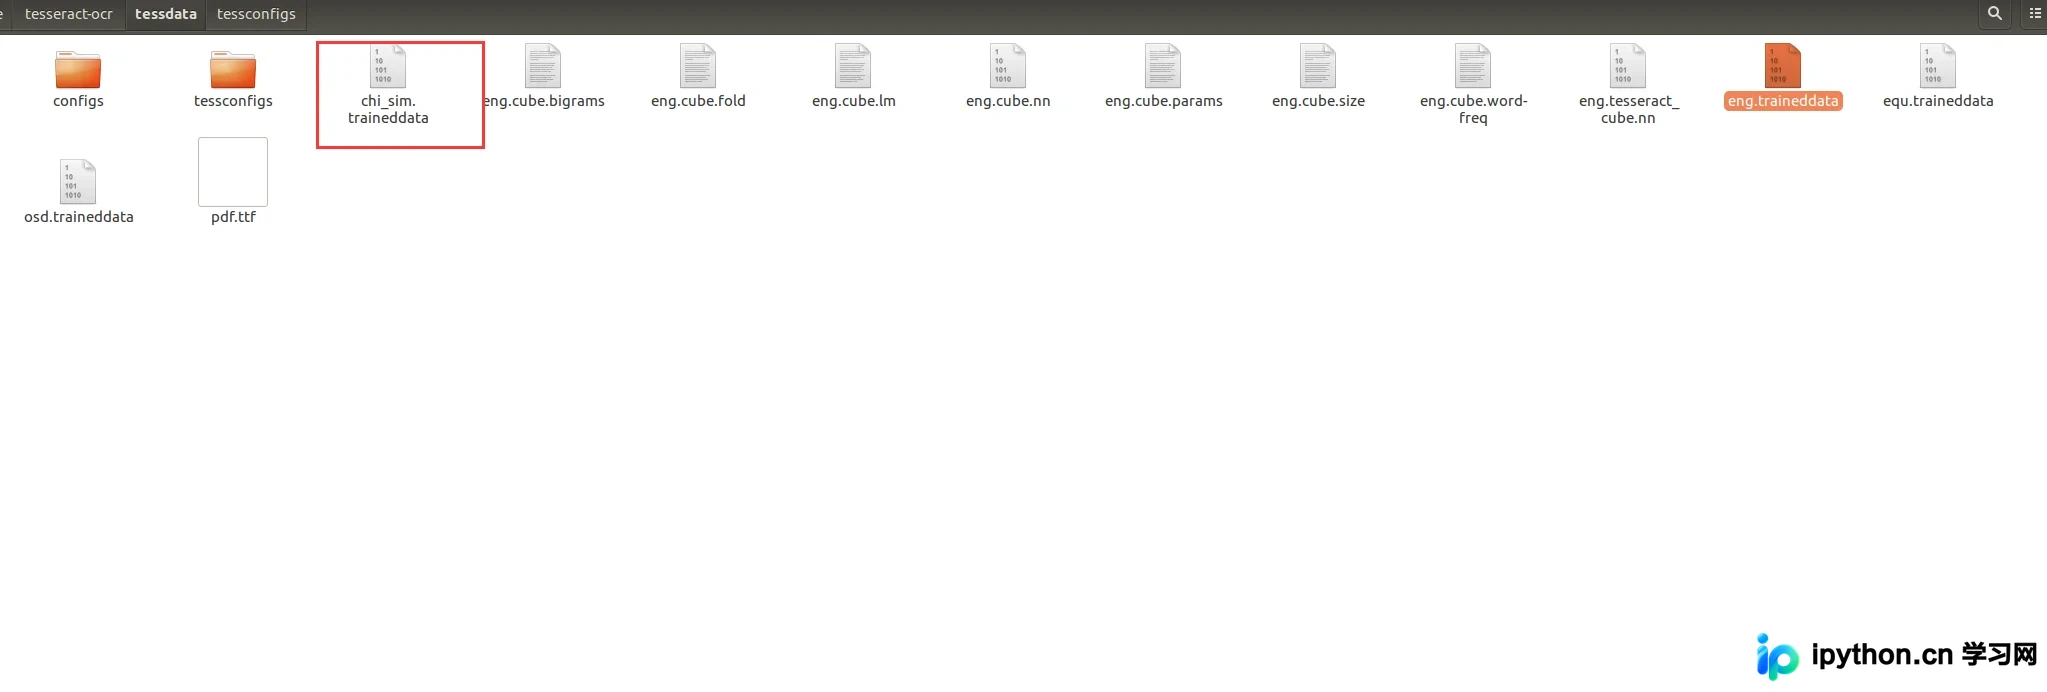
检查系统路径后发现缺少chi_sim.traineddata中文训练数据包。
# 安装训练数据(equ为数学公式包)
sudo apt-get install tesseract-ocr-eng tesseract-ocr-chi-sim tesseract-ocr-equ
补充安装该训练包后,程序即可正常运行。
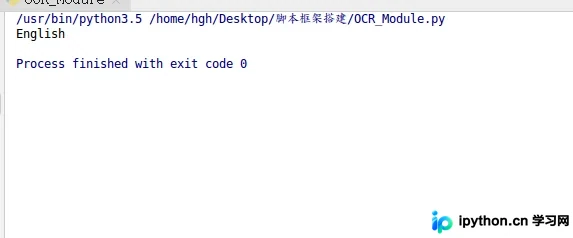
实际测试表明,英文识别准确率较高,而中文识别效果相对有限。
以上内容为本文全部介绍,希望能为读者的学习与工作提供有益参考,欢迎继续支持本站获取更多技术资讯。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















