


PyCharm搭建Spark开发环境的实现步骤

本文详细介绍在Windows系统下使用PyCharm搭建Spark开发环境的完整步骤。内容涵盖JDK安装与变量配置、Hadoop及winutils组件部署、Spark环境变量设置,以及Anaconda集成。重点讲解如何在PyCharm中通过Edit Configurations和Project Structure配置SPARK_HOME与PYTHONPATH,并附带测试代码验证环境是否成功运行,解决常见版本兼容警告。
安装JDK并配置环境变量
第一步,确保计算机已正确安装JDK。
下载并安装jdk-12.0.1_windows-x64_bin.exe安装包。安装完成后,需进行环境变量配置:
- 新建系统变量JAVA_HOME,其值设置为Java的实际安装路径。
- 新建系统变量CLASSPATH,其值设置为 .;%JAVA_HOME%\lib\dt.jar;%JAVA_HOME%\lib\tools.jar;(请注意字符串最前面的圆点符号不可省略)。
- 在系统变量PATH中添加 %JAVA_HOME%bin;%JAVA_HOME%jrebin,确保可执行文件路径被识别。
打开CMD命令行窗口,输入java或java -version命令。若系统未提示“不是内部或外部命令”等错误信息,则表明JDK安装成功。
安装Hadoop及winutils组件
第二步,安装Hadoop软件并配置相关环境变量。
从官方镜像站点下载Hadoop压缩包:https://www.apache.org/dyn/closer.cgi/hadoop/common/hadoop-2.7.7/hadoop-2.7.7.tar.gz
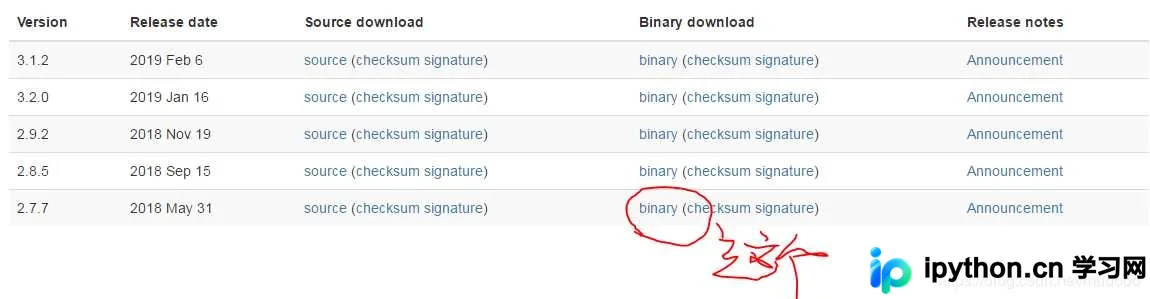
- 将hadoop-2.7.7.tar.gz解压至指定目录,例如D:\adasoftware\hadoop。
- 新建系统变量HADOOP_HOME,其值指向Hadoop的安装目录,如D:\adasoftware\hadoop。
- 在系统变量PATH中添加Hadoop的bin目录路径:D:\adasoftware\hadoop\bin。
- 安装winutils组件:下载对应Hadoop版本的winutils工具,将其中的bin文件夹内容替换到你自己Hadoop安装目录下的bin文件夹中,以解决Windows下Hadoop运行的权限问题。
配置Spark环境变量
第三步,配置Spark的环境变量。
Spark运行依赖Hadoop的相关库文件。若未正确配置Hadoop运行环境,Spark启动时可能会提示相关错误信息,尽管这通常不影响Spark本身的运行,但建议保持环境一致。
- 访问Spark官网下载页面http://spark.apache.org/downloads.html,下载与已安装Hadoop版本对应的Spark安装包。
- 将Spark文件解压到指定路径,例如D:\adasoftware\spark-2.4.3-bin-hadoop2.7。
- 在系统变量PATH中添加Spark的bin目录路径:D:\adasoftware\spark-2.4.3-bin-hadoop2.7\bin;。
- 新建系统变量SPARK_HOME,其值指向Spark的安装目录,即D:\adasoftware\spark-2.4.3-bin-hadoop2.7;。
安装Anaconda集成环境
第四步,下载安装Anaconda。
Anaconda集成了Python解释器及大多数常用的Python库。安装Anaconda后,无需再单独安装Python、pandas、numpy等组件。获取下载地址后,完成安装,并将Python路径添加到系统path环境变量中。
验证Spark基础运行环境
第五步,在CMD命令行中运行pyspark命令。若界面显示类似启动成功的截图信息,则说明基础环境配置正常。
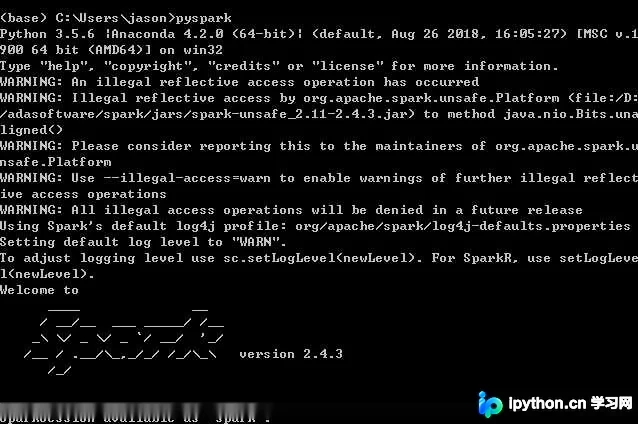
若出现Warning警告,通常是因为JDK版本为12,版本较高导致的提示,但这并不影响Spark的实际运行。
在PyCharm中配置Spark路径
第六步,在PyCharm中完成Spark环境的最终配置。
启动PyCharm并创建一个新的Project。随后选择“Run”菜单下的“Edit Configurations”,点击“+”号创建一个新的Python Configuration。
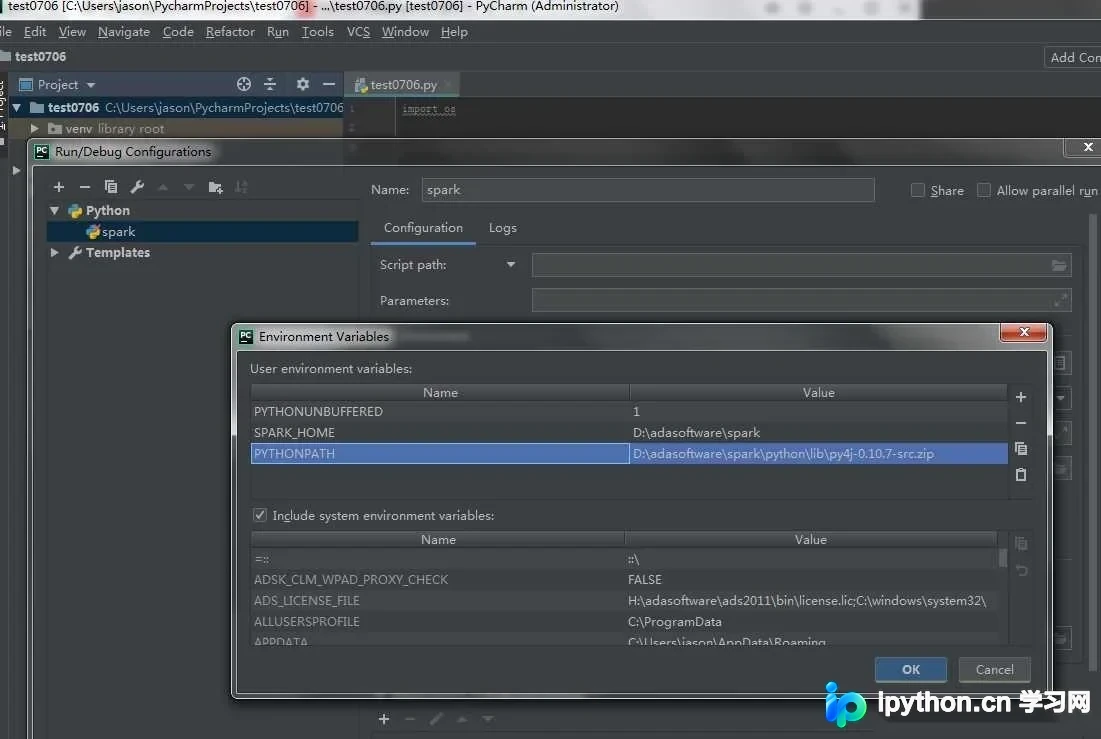
在配置界面中选择“Environment variables”选项,添加SPARK_HOME目录与PYTHONPATH目录。
- 设置SPARK_HOME变量值为Spark的安装目录。
- 设置PYTHONPATH变量值为Spark安装目录下的Python子目录。
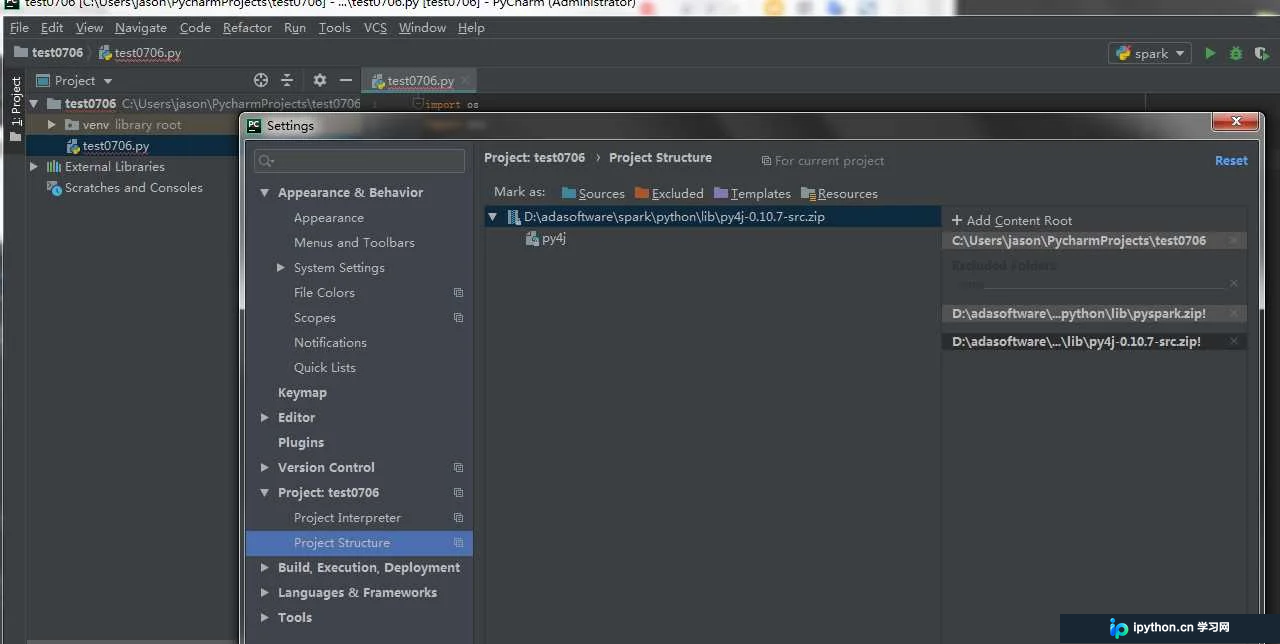
接着,选择File菜单下的Settings,进入你的Project设置,点击“Project Structure”。
在右上角点击“Add content root”,添加py4j-some-version.zip和pyspark.zip文件的路径(这两个文件均位于Spark安装目录下的python文件夹中)。
确认所有设置无误后保存即可。
测试Spark环境是否成功
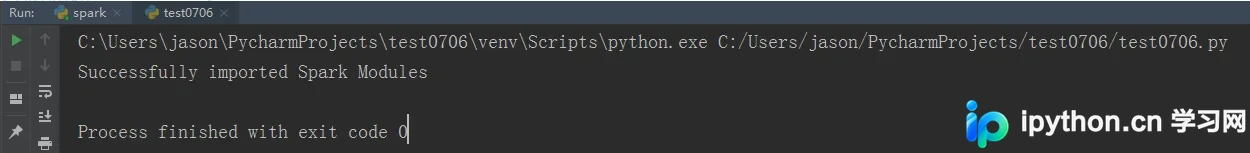
第七步,测试配置是否成功。编写如下Python程序代码,并将其放入新建的Python文件中运行:
import os
import sys

# Path for spark source folder
os.environ['SPARK_HOME'] = "D:\adasoftware\spark"

# Append pyspark to Python Path
sys.path.append("D:\adasoftware\spark\python")

try:
 from pyspark import SparkContext
 from pyspark import SparkConf

 print("Successfully imported Spark Modules")
except ImportError as e:
 print("Can not import Spark Modules", e)
 sys.exit(1)
若程序正常输出“Successfully imported Spark Modules”,则说明Spark环境已配置成功并可正常执行。
以上即为PyCharm搭建Spark开发环境的完整内容,希望对本篇内容的学习有所帮助,也欢迎大家继续支持本站获取更多技术资讯。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















