


Python3通过URL获取文件大小:urllib模块与Content-Length头处理

发布时间:2026-10-13 |
6人浏览过
本文介绍在Python3中如何使用urllib模块获取远程URL的文件大小。重点解决urllib2迁移至urllib.request后的代码适配问题,并指出服务器返回的Content-Length头字段大小写敏感导致的获取失败现象,提供修正后的完整示例代码。
Python3中urllib模块的使用与文件获取原理
在Python3环境中,原有的urllib2模块已不再使用,取而代之的是urllib.request模块。因此,在编写相关脚本时,需要在文件头部引入相应的库,具体操作为导入urllib.request并重命名为urllib2以便兼容旧代码风格或简化调用。
import urllib.request as urllib2
def getRemoteFileSize(url, proxy=None):
 """ 通过content-length头获取远程文件大小
  url - 目标文件URL
  proxy - 代理 """
 opener = urllib2.build_opener()
 if proxy:
  if url.lower().startswith('https://'):
   opener.add_handler(urllib2.ProxyHandler({'https' : proxy}))
  else:
   opener.add_handler(urllib2.ProxyHandler({'http' : proxy}))
 try:
  request = urllib2.Request(url)
  request.get_method = lambda: 'HEAD'
  response = opener.open(request)
  response.read()
 except Exception:
  return 0
 else:
  print(response.headers)
  fileSize = dict(response.headers).get('content-length', 0)
  return int(fileSize)
使用上述初始代码进行测试时,发现返回的文件大小值为0。经分析,这通常是因为未能正确解析到content-length字段。通过打印response.headers查看响应头信息后发现,部分服务器返回的字段名为Content-Length(首字母大写),而代码中获取时使用的是小写的content-length,导致匹配失败。修正字段名后,程序即可正常获取文件大小。
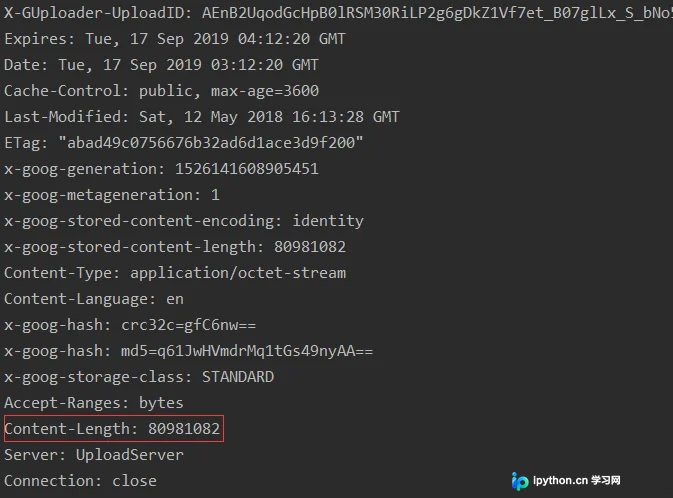
修正Content-Length字段大小写问题
def getRemoteFileSize(url, proxy=None):
 """ 通过content-length头获取远程文件大小
  url - 目标文件URL
  proxy - 代理 """
 opener = urllib2.build_opener()
 if proxy:
  if url.lower().startswith('https://'):
   opener.add_handler(urllib2.ProxyHandler({'https' : proxy}))
  else:
   opener.add_handler(urllib2.ProxyHandler({'http' : proxy}))
 try:
  request = urllib2.Request(url)
  request.get_method = lambda: 'HEAD'
  response = opener.open(request)
  response.read()
 except Exception:
  return 0
 else:
  print(response.headers)
  fileSize = dict(response.headers).get('Content-Length', 0)
  return int(fileSize)
综上所述,本文提供了Python3环境下通过URL获取文件大小的示例代码。核心在于正确处理HTTP响应头中的Content-Length字段,注意大小写敏感性。
以上介绍的是Python3获取URL文件大小的示例代码,希望能对读者有所帮助。如有任何疑问,欢迎留言讨论,小编会及时回复。感谢大家对本站的支持!如果您觉得本文对您有帮助,欢迎转载,请注明出处,谢谢。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















