



训练 PyTorch 模型时,最常见也最容易误判的问题之一,就是 CPU 占用一路拉满,而 GPU 利用率始终起不来。表面上看像是 CUDA 没跑起来,实际上多数情况出在数据加载与预处理链路:num_workers 开太大、子进程线程失控、内存传输没有异步化,都会让 GPU 长时间等数据。下面按“为什么会慢、该怎么配、怎么确认瓶颈”的顺序梳理,帮助你更快判断问题到底卡在哪一层。
为什么 num_workers 越大,训练反而可能越慢?
很多人第一反应是:CPU 核心多,就把 num_workers 设高一点,数据应该喂得更快。但在 PyTorch 里,这个思路经常会适得其反。
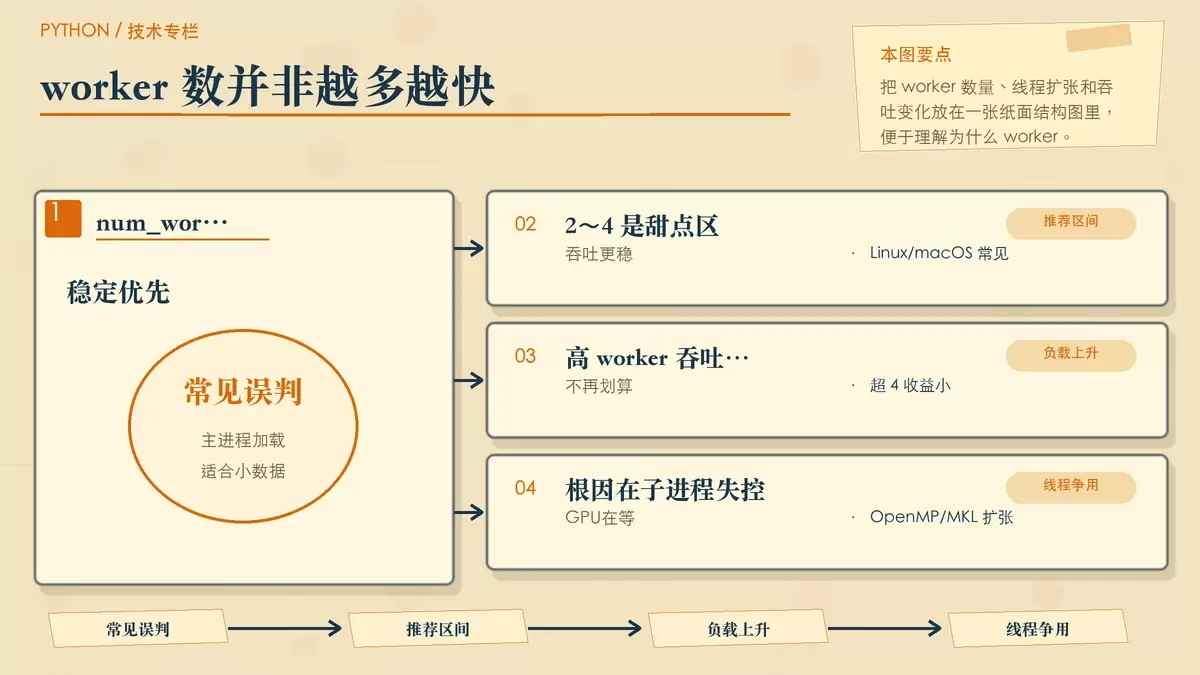
问题的核心不在模型,也不在 CUDA,而在 DataLoader 子进程。每个 worker 启动后,往往会默认调用全部 CPU 核心去跑 OpenMP 或 MKL 相关计算。像 cv2.imread、torch.mm 这类操作,都可能在后台继续开线程;再叠加 multiprocessing 带来的 pickle 序列化开销,CPU 很容易被调度和线程竞争吃满。
如果数据集本身不大、磁盘 IO 也不紧张,那么高 num_workers 带来的并不是更高吞吐,而是更多空转。结果就是 CPU 忙着抢资源,GPU 却一直在等下一批数据送达。
num_workers=0最稳,数据由主进程加载,适合调试、Windows,或者数据量本身不大的场景- 在 Linux/macOS 下,
num_workers=2~4往往是更现实的甜点区 - 很多实测里,超过
4之后吞吐几乎不再增长,但 CPU 负载会继续线性上升 - 不要按 CPU 核数机械设置,比如 16 核机器就把
num_workers设成 12,这正是常见误判来源
如果你当前现象是“CPU 很忙、GPU 很闲”,第一步通常不是继续加 worker,而是先把 num_workers 降下来,观察吞吐、显存占用和 GPU 利用率是否反而更稳定。
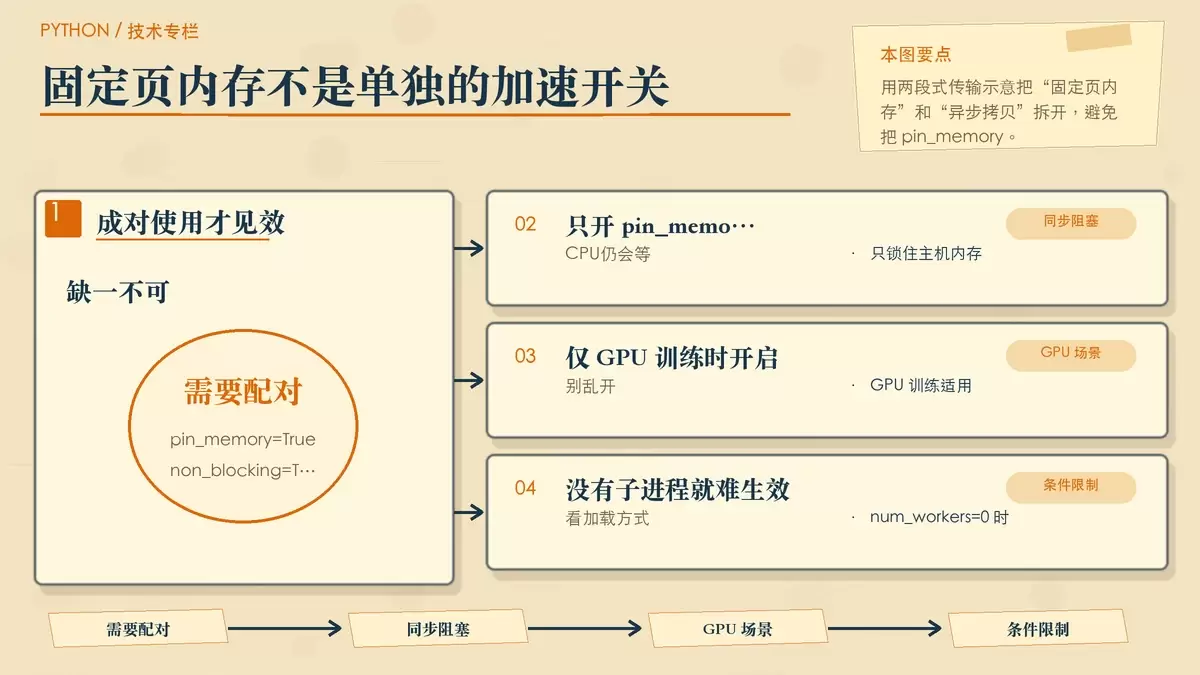
只开 pin_memory=True 不够,关键还要配 non_blocking=True
另一个常见误区,是只在 DataLoader 里加了 pin_memory=True,却发现训练几乎没有提速,于是误以为这个参数没用。
实际上,pin_memory=True 的作用只是把主机内存固定住,让 CPU 到 GPU 的数据传输具备更好的条件;真正决定是否异步拷贝的,是把张量送入设备时有没有写成 .to(device, non_blocking=True)。如果这一步没开,数据依旧会同步传输,CPU 仍然会卡在等待拷贝完成,GPU 也拿不到下一批数据。
- 想看到效果,必须成对使用:
pin_memory=True加上tensor.to(device, non_blocking=True) - 只有在 GPU 训练时才建议开启
pin_memory - 如果是纯 CPU 训练,打开它通常只会多一次内存处理开销
- 当
num_workers=0时,pin_memory也没有实际意义,因为没有子进程数据搬运这一步
loader = DataLoader(
    dataset,
    batch_size=...,
    shuffle=True,
    num_workers=2,
    pin_memory=True,
)

for x, y in loader:
    x = x.to(device, non_blocking=True)
    y = y.to(device, non_blocking=True)
如果你已经把 worker 数量降到合理范围,但 GPU 利用率仍然断断续续,下一步就该检查这两个参数是否真的成对使用,而不是只开了一半。
真正吃光 CPU 的,可能是 OpenCV 或 Albumentations 的后台线程
不少人已经尝试过调小 num_workers,也加了 torch.set_num_threads(1),但 CPU 占用还是很高。问题往往出在这里:你限制住的只是 PyTorch 自己的部分算子,并没有限制住 OpenCV 或图像增强库内部的线程行为。
例如 cv2.imread、albumentations.Compose 这类预处理过程,底层常常会调 OpenCV 的多线程实现。它们默认可能直接占满所有核,而这些线程又运行在 DataLoader 的多个子进程里,最终形成“每个 worker 都开一套线程”的叠加效果。
这也是为什么只写 torch.set_num_threads(1) 经常不够,因为它只约束 PyTorch 算子,比如 torch.mm,并不能接管整个数据预处理栈。
更稳妥的做法,是在训练脚本最开头就通过环境变量做全局限制:
import os

os.environ["OMP_NUM_THREADS"] = "1"
os.environ["MKL_NUM_THREADS"] = "1"
如果你在 Windows 上训练,还要额外注意 multiprocessing 的启动方式:
mp.set_start_method("spawn")
这样做的目的,是避免沿用不合适的进程启动方式后,CUDA 上下文与多进程之间出现死锁或异常继承问题。
这里最重要的一点是:限制子进程线程数,要靠 OMP_NUM_THREADS、MKL_NUM_THREADS 这类环境变量,而不是只依赖 torch.set_num_threads()。
别靠猜,先确认瓶颈到底在计算、IO 还是线程争用
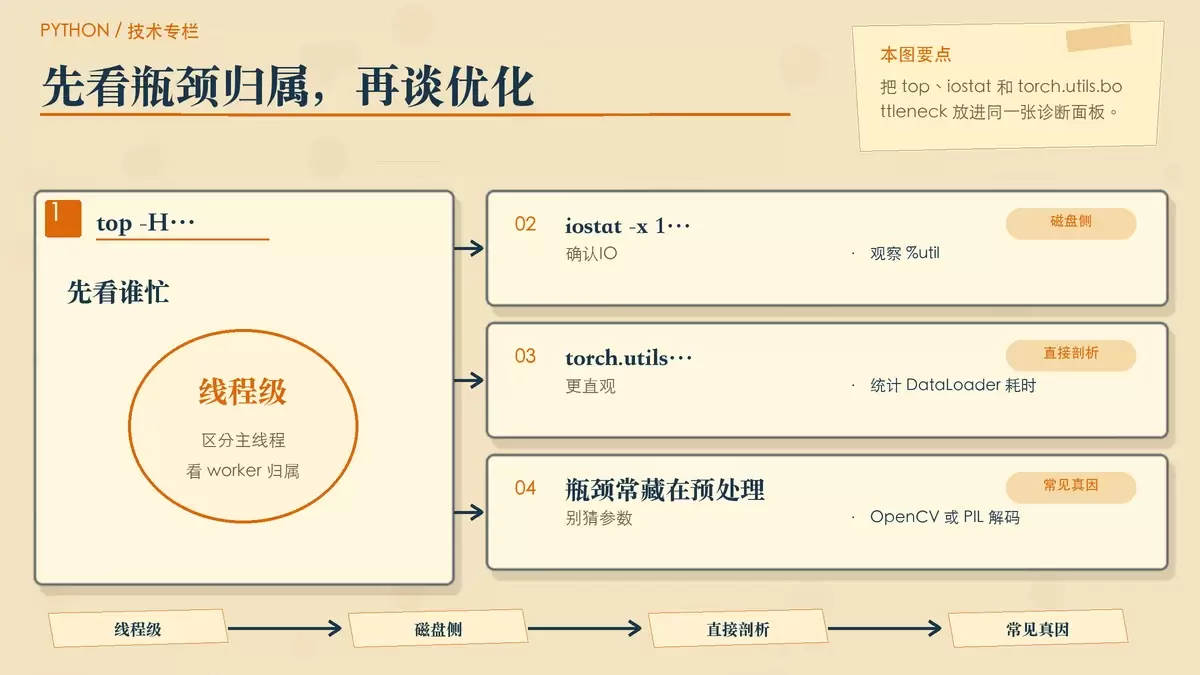
“CPU 高、GPU 低”只是表象,真正的瓶颈可能完全不同。有时候是 DataLoader worker 过多,有时候是图像解码线程失控,也有时候是磁盘读文件已经打满。要少走弯路,关键是先看线程归属,而不是盲调参数。
先看是谁在占 CPU
可以先用下面的命令观察线程级别的占用情况:
top -H它能帮助你区分现在吃 CPU 的到底是 Python 主线程、DataLoader worker,还是 OpenCV、PIL 之类的后台线程。
再看是不是磁盘 IO 卡住了
如果怀疑数据读取慢,可以继续看磁盘利用率:
iostat -x 1当 %util 接近 100% 时,通常说明瓶颈更偏向文件读取,而不是算力不足。
最后用 PyTorch 自带工具做一次剖析
如果还不能确定,可以直接跑一遍:
python -m torch.utils.bottleneck train.py --epochs 1这个命令可以直接给出 DataLoader 耗时占比,以及训练过程中是否存在明显的同步阻塞,是定位问题最快的一类手段。
实际排查时,建议先跑一次 top -H。很多案例最后证明,问题根本不在模型,也不在“多线程没开够”,而是 OpenCV 或 PIL 解码在某个环节占住了核心资源,甚至卡在单核循环里。
一套更稳妥的调参顺序
如果你想尽快把训练链路调到可用状态,可以按下面的顺序处理:
- 先把
num_workers降到0、2、4这些小范围内测试,不要直接按 CPU 核数设置 - 确认 GPU 训练时是否成对使用
pin_memory=True和non_blocking=True - 在脚本最前面设置
OMP_NUM_THREADS与MKL_NUM_THREADS,限制子进程里的底层线程数量 - 用
top -H、iostat -x 1、python -m torch.utils.bottleneck train.py --epochs 1做实际定位,再决定后续优化方向
多数情况下,CPU 打满而 GPU 利用率低,并不是“显卡不行”,而是数据输入路径比模型本身更先失衡。把 worker 数、内存传输方式和底层线程控制好,往往比继续堆更多并行参数更有效。















