



很多人第一次测 Python 代码耗时,都会直接在前后套一层 time.perf_counter()。这个办法并非不能用,但只要目标是比较短代码、微小差异或不同写法之间的速度,单次计时很容易被垃圾回收、调度抖动和缓存状态带偏。下面从 timeit 的工作方式、常见误用和结果解读三个角度,说明它为什么通常比手写计时更可靠,以及什么情况下你的测试结果其实已经失真。
为什么 timeit 往往比手写 perf_counter() 更准
timeit 的关键不在于“帮你计时”,而在于它把计时过程变成了一次更受控的实验。
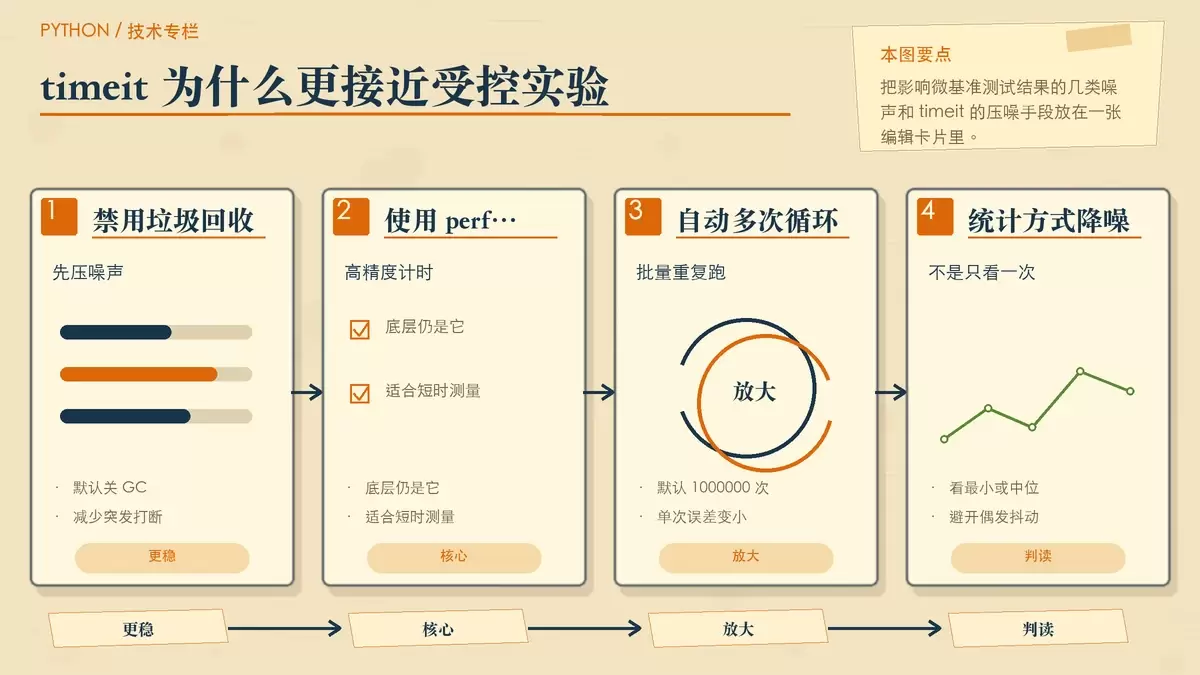
和直接写两行 time.perf_counter() 相比,timeit 默认会做几件重要的事:禁用垃圾回收、使用 time.perf_counter() 作为底层计时器、自动执行大量循环,并通过最小值或中位数这类统计方式压低偶发噪声的影响。默认循环次数是 number=1000000,这意味着它不是看某一次执行恰好花了多久,而是把信号放大,让单次误差相对变小。
这类噪声在 Python 里很常见。比如 GC 可能在第 999 次突然介入,后台进程可能临时抢占 CPU,CPU 频率也可能因为负载变化而波动。如果只测一次,或者只是自己手写一个短循环,这些干扰都可能直接落到结果上。于是你看到的就不一定是“代码本身快不快”,而更像是“那一刻机器状态如何”。
因此,timeit 更准确,并不是它比 perf_counter() 更高级,而是它围绕 perf_counter() 额外搭了一层基准测试规范,让测试环境更接近可重复比较的状态。
为什么漏写 setup 或作用域处理不当会报错或失真
很多人开始用 timeit 时,最先遇到的问题不是结果不准,而是代码直接报错。
一个典型例子是:
data = list(range(1000))
timeit.timeit('sorted(data)', number=100000)
# NameError: name 'data' is not defined
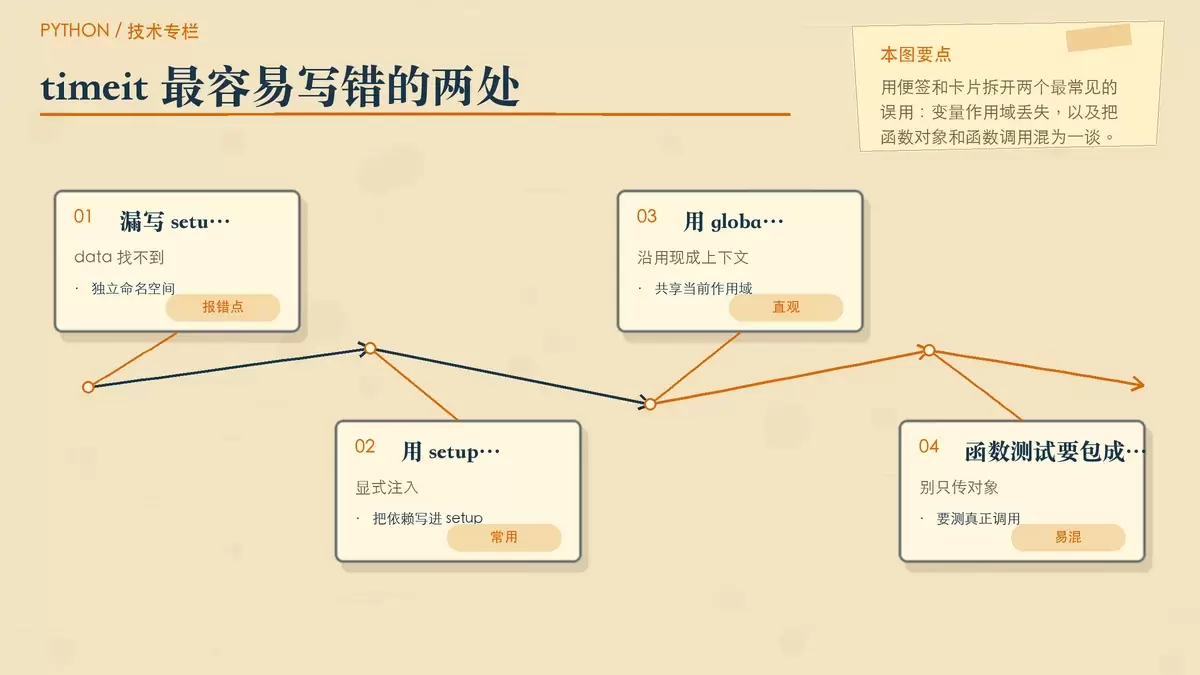
原因在于,timeit 执行传入的 stmt 时,使用的是独立命名空间。外部变量默认并不会自动带进去,所以你在当前作用域里定义了 data,不代表 timeit 那边也能看见。
常见的正确写法有两种。
方式一:通过 setup 明确注入依赖
timeit.timeit('sorted(data)', setup='data = list(range(1000))', number=100000)
这种方式的优点是测试环境清晰,语句和依赖拆分明确,适合比较独立的小段表达式。
方式二:用 globals=locals() 共享当前作用域
timeit.timeit('sorted(data)', globals=locals(), number=100000)
这通常更直观,尤其是上下文已经在当前函数或脚本里准备好的时候,不需要再把依赖重新写成字符串。不过要注意,别把这种调用方式放进高频循环里反复执行,否则你测到的就不只是目标代码,还有额外的组织成本。
这里还有一个容易被忽略的点:即便 setup 本身不计入最终耗时,如果它包含加载大文件、建立连接、构造大对象这类初始化动作,依然会真实占用系统资源。它可能改变缓存状态、内存压力和后续执行环境,进而间接影响结果。也就是说,setup 不进表,不等于它没有副作用。
测函数调用时,为什么一定要让 timeit 真正执行调用
另一个高频误区,是把“函数对象”当成了“函数调用”。
很多人会写成这样:
timeit.timeit(my_func, number=100000)
这种写法并不能正确表达“执行 my_func() 一次要多久”。问题在于,你必须确保 timeit 计到的是调用动作本身,而不是别的间接开销。实践里,更稳妥的写法是显式包一层可调用对象,让目标函数在每轮测试里被真正触发。
常见写法如下:
timeit.timeit(lambda: my_func(), number=100000)
from functools import partial
timeit.timeit(partial(my_func), number=100000)
如果函数需要参数,也应把调用写完整:
timeit.timeit(lambda: my_func(arg1, arg2), number=100000)
这一步的重点不是语法形式,而是避免“你以为在测执行,实际上只是在测包装方式”。
闭包参数为什么可能让结果看起来对、实际却不对
用 lambda 时,还要留意闭包捕获的是变量引用,而不是当下数值。如果 arg1 在外层循环里不断变化,最后所有 lambda 可能都会拿到同一个最终值。这样一来,测试虽然跑通了,但它测的根本不是你原本想测的那组输入。
这种场景下,需要用默认参数把值固化,避免“最后一轮覆盖全部”的问题。对于基准测试来说,输入是否稳定,和计时器本身一样重要。
`repeat()` 的结果该怎么看,为什么不能只盯着 min()
timeit.repeat(repeat=5, number=100000) 会返回一个列表,里面是多次重复测试得到的总耗时。很多教程会直接建议对结果取 min(result),但这个习惯并不总是安全。
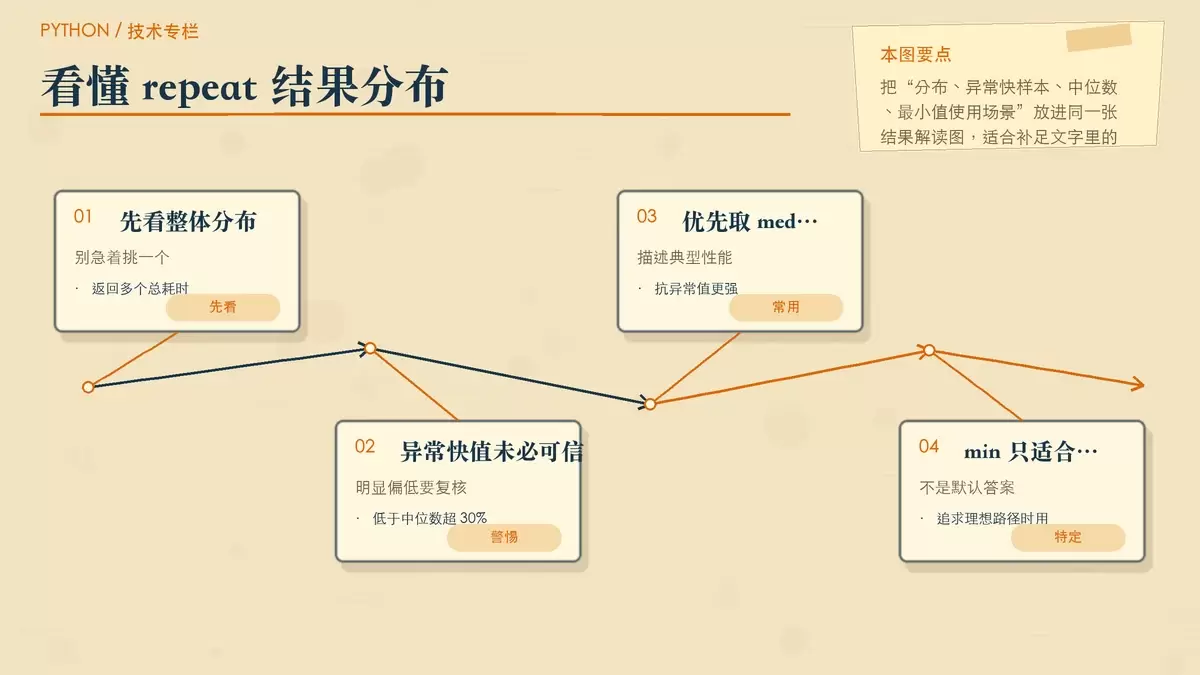
最小值有时对应的只是某一次特别顺的运行:恰好没被 GC 打断、恰好缓存命中更充分,或者恰好系统调度更安静。这样的结果能说明“理论上这段代码可以跑到多快”,却不一定代表日常表现。
因此,读取 repeat() 结果时,更合理的顺序通常是:
- 先看分布,判断几次结果是否稳定。
- 如果某个值明显偏低,比如比中位数低超过 30%,要先怀疑它是否属于异常快样本。
- 描述典型性能时,优先使用
median(result),因为它对异常值更稳。 - 只有在你明确追求“最理想路径性能”时,才优先考虑
min(),并且最好配合不同number值重复验证稳定性。
换句话说,repeat() 给你的不只是一个答案,而是一组证据。真正有价值的判断,不是挑一个最小数字贴出来,而是看这组数字是否一致、是否能支撑你的结论。
实际做 Python 微基准测试时,可以记住的判断原则
如果你只是粗略估算一段较长任务的总耗时,手写 time.perf_counter() 当然够用;但只要你要比较小代码片段、函数不同写法,或者差异已经小到容易受环境影响,timeit 通常是更稳妥的起点。
它更准确的核心原因并不神秘:默认禁用 GC、使用高精度计时器、自动跑大量循环,并通过统计方法压低偶发噪声。这些机制组合起来,能让结果更接近“代码本身的性能”而不是“单次运行时的环境状态”。
同时,别忽视几个会直接破坏测试有效性的细节:字符串语句缺少 setup 或 globals 会导致作用域错误;函数测试如果没有明确写成调用,结果就可能测偏;repeat() 返回的多个数字,也不该只凭一个 min() 下结论。
基准测试的难点从来不只是会不会用工具,而是能不能判断这组数字是否值得相信。把这几个环节处理好,timeit 才能真正发挥作用。















