


Python Pandas怎么用str.contains模糊匹配列名

在数据分析与清洗过程中,处理包含数十甚至上百列的宽表格是常见任务。当我们只需要提取包含某些关键词(如“sales”、“date”或“user”)的列时,直接对 df.columns 使用 .str.contains() 生成布尔掩码,并借助 df.loc[:, mask] 进行列切片,是最直接且高效的做法。本文将详细拆解具体操作步骤、关键参数配置、复杂正则多条件匹配以及常见报错排查。
一、核心操作步骤与基础用法
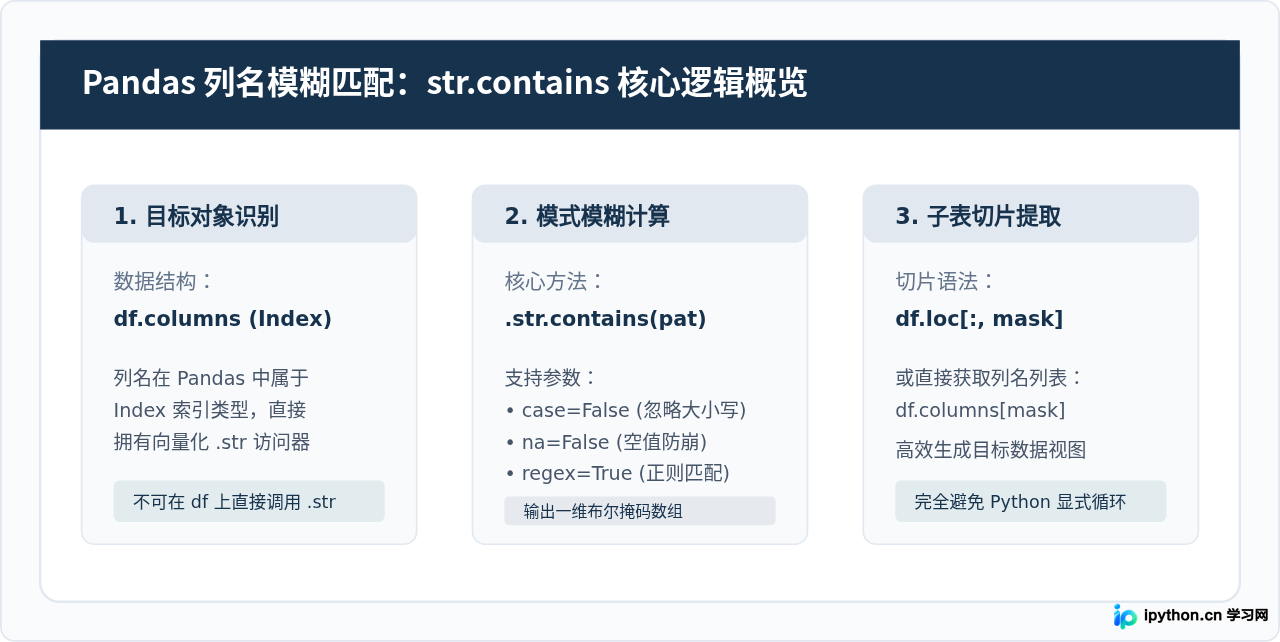
许多初学者容易产生一个误区:试图直接在 DataFrame 对象上执行 df.str.contains()。然而在 Pandas 中,DataFrame 自身并没有 .str 属性。正确的目标是 df.columns,它是一个 pd.Index 类型的对象,同样封装了完整的向量化字符串方法。
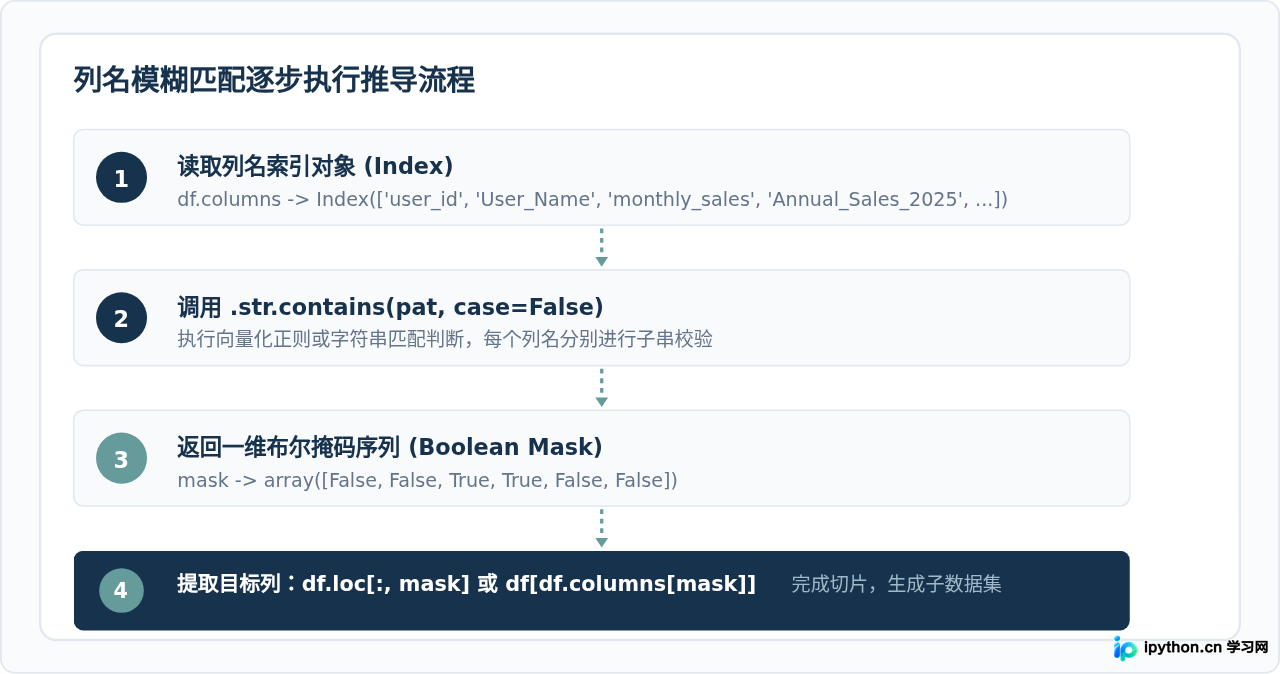
完成一次列名模糊匹配的标准操作流程分为四步:构建测试表、提取列名索引、使用 str.contains 生成布尔掩码、最后完成数据筛选。
import pandas as pd

# 示例数据:包含不同命名规范与大小写的宽表
data = {
    'user_id': [101, 102],
    'User_Name': ['Alice', 'Bob'],
    'monthly_sales': [5000, 7200],
    'Annual_Sales_2025': [60000, 86400],
    'cost_budget': [3000, 4500],
    'user_city': ['Beijing', 'Shanghai']
}
df = pd.DataFrame(data)

# 第一步:基于列名进行包含匹配(默认区分大小写)
# 生成布尔掩码数组:True 表示列名包含目标字符串
mask = df.columns.str.contains('sales')

# 第二步:使用 df.loc[:, mask] 提取匹配的列
filtered_df = df.loc[:, mask]

print("匹配的列名:", df.columns[mask].tolist())
print(filtered_df)
执行上述代码后的示例输出如下:
匹配的列名: ['monthly_sales']
   monthly_sales
0           5000
1           7200
可以看到,由于默认区分大小写,只成功匹配到了小写的 monthly_sales,而大写的 Annual_Sales_2025 被排除了。为了解决这种大小写混杂的问题,我们需要调整核心参数。
二、关键参数配置详解
Series.str.contains 与 Index.str.contains 提供了若干控制匹配行为的参数。掌握这些参数是编写健壮数据脚本的基础:
| 参数名称 | 类型与默认值 | 实际作用与业务影响 |
|---|---|---|
pat |
字符串 (str) | 需要搜索的字符片段、关键词或正则表达式模式。 |
case |
布尔值 (默认 True) | 是否区分大小写。设为 False 可进行大小写不敏感的模糊匹配。 |
flags |
整数 (默认 0) | 传递给 Python re 模块的标准标志位,例如 re.IGNORECASE。 |
na |
标量值 (默认 NaN) | 遇到空值/缺失值列名时的填充结果。建议始终设为 False 以防索引抛错。 |
regex |
布尔值 (默认 True) | 是否将 pat 视为正则表达式。若匹配包含 $、(、+ 等特殊字符,应设为 False。 |
na=False 时可能返回含有 NaN 的布尔序列,直接作为 .loc 索引条件会抛出 ValueError: Cannot mask with non-boolean array containing NA / NaN values。因此在生产代码中,养成显式指定 na=False 的习惯至关重要。
# 忽略大小写并规避空值列名的标准写法
target_mask = df.columns.str.contains('sales', case=False, na=False)
result_df = df.loc[:, target_mask]

# 输出将同时包含 'monthly_sales' 和 'Annual_Sales_2025'
print(result_df.columns.tolist())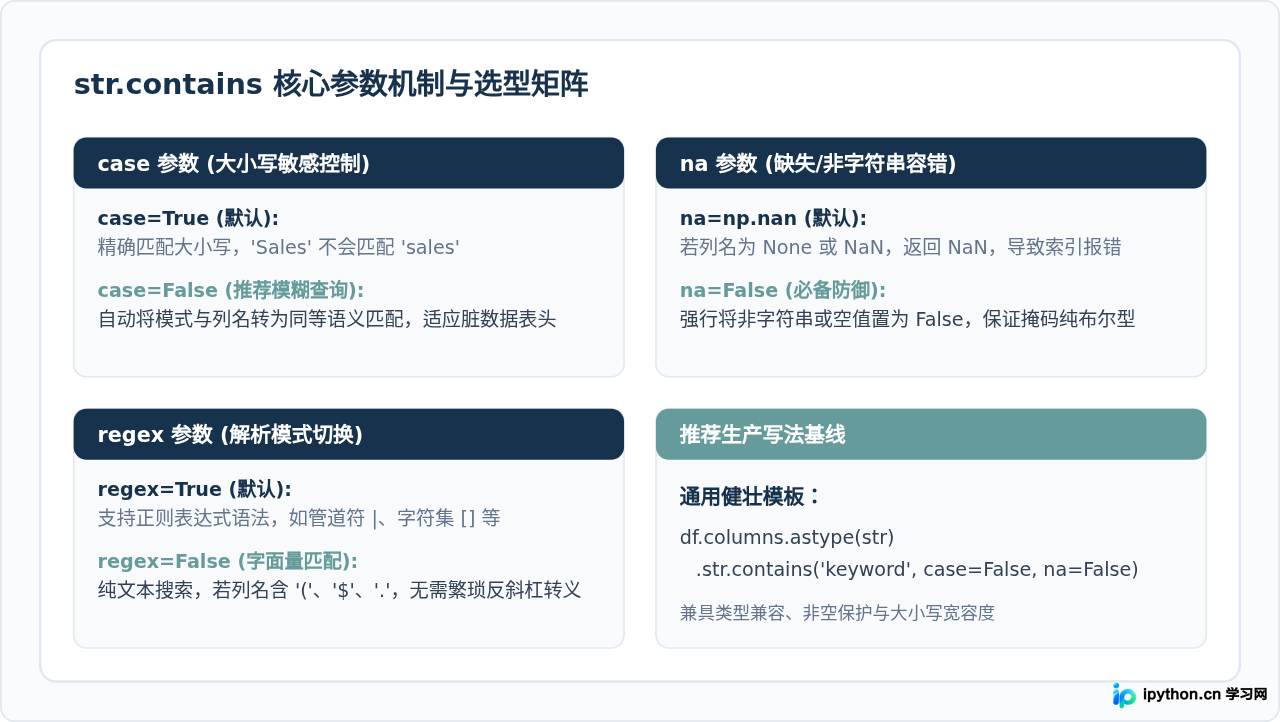
三、高级与复杂匹配场景
在实际业务中,我们往往面临更多样化的模糊匹配需求,例如同时匹配多个备选关键词、排除包含特定标记的列,或者对列名的开头/结尾进行位置限定。
1. 多个关键词联合匹配(逻辑或)
由于 str.contains 默认开启正则解析(regex=True),可以直接在字符串中使用正则表达式的管道符 | 实现“满足任意一个关键词即可匹配”:
# 匹配包含 "user" 或 "sales" 的所有列(不区分大小写)
multi_mask = df.columns.str.contains('user|sales', case=False, na=False)
sub_df = df.loc[:, multi_mask]
print("命中列名:", df.columns[multi_mask].tolist())
# 输出: ['user_id', 'User_Name', 'monthly_sales', 'Annual_Sales_2025', 'user_city']
2. 反向模糊匹配(排除特定列)
若需要提取“不包含某个关键词”的所有列,只需在生成的布尔掩码前加上 Python 位取反操作符 ~:
# 排除所有名称中带有 "sales" 的列
exclude_mask = ~df.columns.str.contains('sales', case=False, na=False)
non_sales_df = df.loc[:, exclude_mask]
print("保留列名:", df.columns[exclude_mask].tolist())
# 输出: ['user_id', 'User_Name', 'cost_budget', 'user_city']
3. 前缀与后缀位置锚定
虽然可以直接使用 df.columns.str.startswith() 或 endswith(),但在复合查询中,通过正则锚点 ^(行首)和 $(行尾)可以在单一表达式中完成复杂的匹配任务:
# 匹配以 'user_' 开头,或者以 '_budget' 结尾的列名
pattern = r'^user_|_budget$'
pos_mask = df.columns.str.contains(pattern, case=False, na=False)
print("位置匹配列名:", df.columns[pos_mask].tolist())
# 输出: ['user_id', 'cost_budget', 'user_city']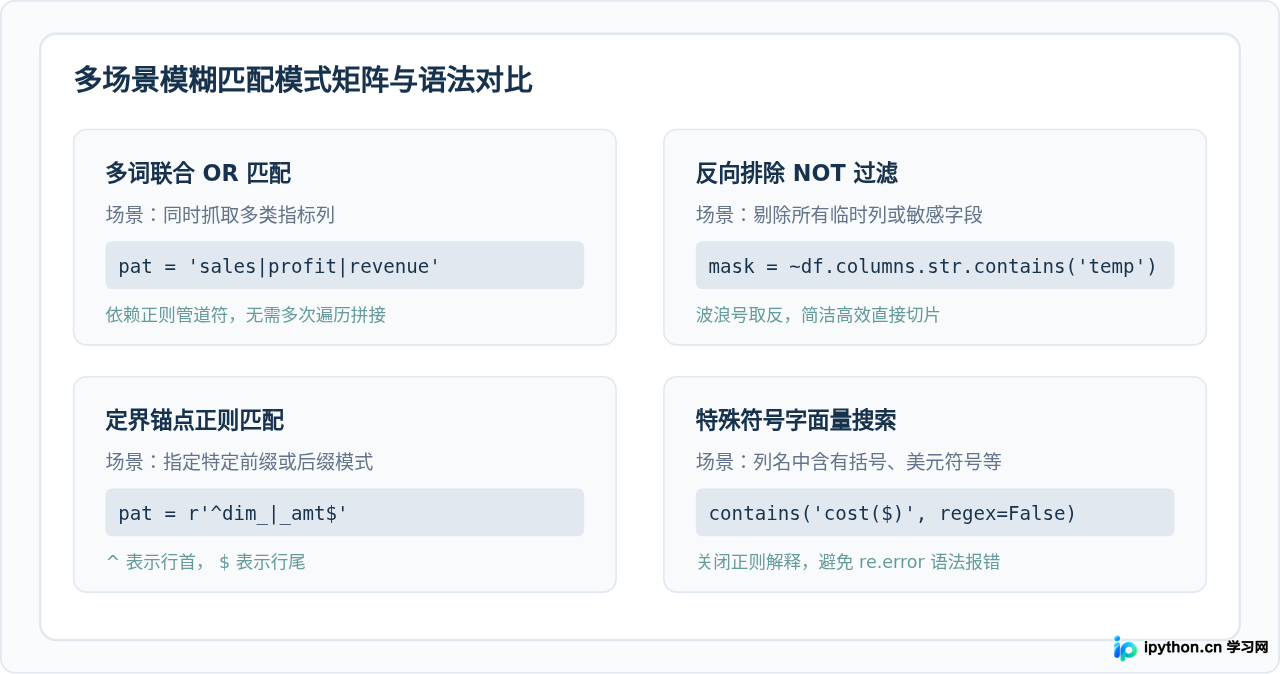
四、常见问题排查与避坑指南
在日常使用 str.contains 处理列名时,有三个高频报错或意外行为需要特别注意:
1. 报错:AttributeError: 'DataFrame' object has no attribute 'str'
原因分析:开发者习惯了 df['col'].str.contains() 对单列的处理方式,直接在 DataFrame 上调用了 df.str.contains()。
解决方案:务必通过 df.columns 获取索引对象后再调用 .str,即 df.columns.str.contains(...)。
2. 列名中包含正则表达式特殊字符导致报错或匹配失败
原因分析:当列名包含如 price(USD)、weight[kg] 或 total$ 时,由于 regex=True,Pandas 会尝试将括号、中括号和美元符号解析为捕获组、字符集或行尾,导致正则表达式语法错误或未预期的空结果。
解决方案:如果只是做纯字面量子串匹配,直接加上 regex=False;如果必须混合使用正则,使用 re.escape('price(USD)') 显式转义。
# 字面量匹配示例
literal_mask = df.columns.str.contains('price(USD)', regex=False)
3. 多层索引(MultiIndex)列名的模糊匹配
如果数据表具有多级列名(MultiIndex),直接在 df.columns 上调用 .str.contains 可能会提示错误或无法直接切片。此时可以使用 get_level_values() 指定层级,或者通过列表推导式配合字符串操作:
# 假设有多层索引,针对第0层进行模糊匹配
level0_mask = df.columns.get_level_values(0).str.contains('sales', case=False)
result_multi = df.loc[:, level0_mask]
五、工程封装与总结
为了在复杂项目或日常数据分析管道中提升代码复用率,建议将列名模糊匹配逻辑封装为一个简洁的通用辅助函数:
def filter_columns_by_keyword(dataframe, pattern, case=False, regex=True):
    """
    根据关键字或正则模式模糊筛选 DataFrame 的列

    参数:
        dataframe: 输入的 pd.DataFrame
        pattern: 匹配模式或子字符串
        case: 是否区分大小写,默认 False
        regex: 是否启用正则,默认 True

    返回:
        筛选后的子 DataFrame
    """
    # 统一确保列名为字符串类型并生成安全布尔掩码
    col_str = dataframe.columns.astype(str)
    mask = col_str.str.contains(pattern, case=case, na=False, regex=regex)
    return dataframe.loc[:, mask]

# 便捷调用示例:
# filtered = filter_columns_by_keyword(df, 'sales|user')
总结来说,利用 df.columns.str.contains() 能够以原生向量化的底层性能快速完成列名的模糊查找与子表提取。在实际编码中,牢记对 df.columns 执行操作、善用 case=False 与 na=False,并根据列名内容谨慎选择 regex 开关,便能轻松应对各种复杂表格的列名匹配需求。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















