


Python3实现zip分卷压缩过程解析

Python标准库zipfile明确不支持创建分卷ZIP文件。本文通过逆向分析ZIP格式规范,利用WinHex对比二进制差异,手动添加\x50\x4b\x07\x08文件头并拆分数据流,实现了不依赖外部程序的纯Python分卷压缩方案。文章同时探讨了ByteIO和管道流在实现中的局限性及内存、IO性能问题,提供了完整的代码实现与优缺点分析。
Python zipfile库的限制
使用zipfile库
查看 官方中文文档
在Python中处理ZIP文件时,开发者通常会首选内置的zipfile库。然而,查阅其官方文档可以发现,该模块明确标注当前无法处理分卷ZIP文件的创建,这给需要分卷压缩的需求带来了阻碍。
手动实现分卷压缩的思路
折腾经过
在尝试通过Google、CSDN和Stackoverflow等平台寻找现成解决方案未果后,目前最稳妥的做法通常是调用外部解压程序来完成分卷压缩。但如果希望完全摆脱对外部程序的依赖,仅依靠Python自身实现这一功能,则需要深入底层处理。
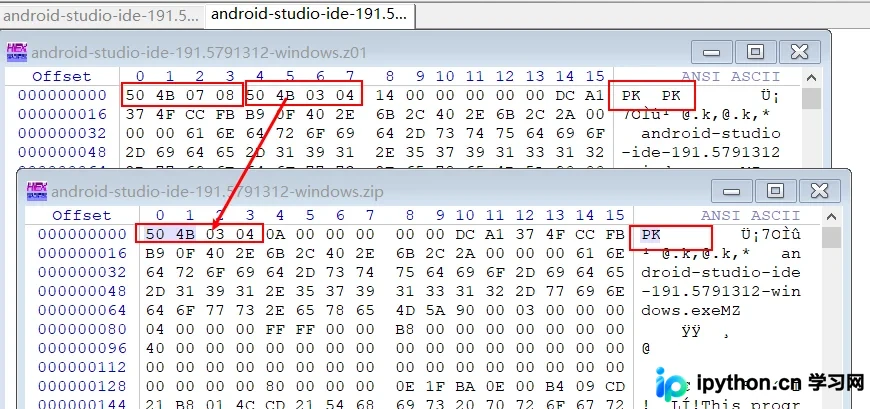
既然没有现成方案,只能自行开发相关功能。面对ZIP格式开发商发布的《ZIP File Format Specification》文档,理解起来颇具难度。为此,通过WinHex工具对WinRAR生成的分卷压缩文件与单个ZIP文件进行逐字节的16进制对比,最终成功找出了差异所在并实现了功能。
分卷压缩的具体实现步骤
目标是将单个大文件test.zip拆分为分卷文件test.z01、test.z02以及最终的test.zip。
具体实现步骤如下:首先,在生成的第一个分卷文件test.z01的数据流头部添加\x50\x4b\x07\x08标记,该标记占用4个字节。虽然普通ZIP文件本身已包含此标记,但分卷压缩要求前几个分卷必须包含此双标记结构。随后,从原始大文件test.zip中读取“分卷大小减去4字节”的数据写入test.z01;接着读取一个完整分卷大小的数据写入test.z02,依此类推,直至最后一个分卷,其文件名恢复为test.zip。
Python3代码实现
Python3的代码实现
import os
import zipfile


def zip_by_volume(file_path, block_size):
  """zip文件分卷压缩"""
  file_size = os.path.getsize(file_path) # 文件字节数
  path, file_name = os.path.split(file_path) # 除去文件名以外的path,文件名
  suffix = file_name.split('.')[-1] # 文件后缀名
  # 添加到临时压缩文件
  zip_file = file_path + '.zip'
  with zipfile.ZipFile(zip_file, 'w') as zf:
    zf.write(file_path, arcname=file_name)
  # 小于分卷尺寸则直接返回压缩文件路径
  if file_size <= block_size:
    return zip_file
  else:
    fp = open(zip_file, 'rb')
    count = file_size // block_size + 1
    # 创建分卷压缩文件的保存路径
    save_dir = path + os.sep + file_name + '_split'
    if os.path.exists(save_dir):
      from shutil import rmtree
      rmtree(save_dir)
    os.mkdir(save_dir)
    # 拆分压缩包为分卷文件
    for i in range(1, count + 1):
      _suffix = 'z{:0>2}'.format(i) if i != count else 'zip'
      name = save_dir + os.sep + file_name.replace(str(suffix), _suffix)
      f = open(name, 'wb+')
      if i == 1:
        f.write(b'\x50\x4b\x07\x08') # 添加分卷压缩header(4字节)
        f.write(fp.read(block_size - 4))
      else:
        f.write(fp.read(block_size))
    fp.close()
    os.remove(zip_file)   # 删除临时的 zip 文件
    return save_dir

if __name__ == '__main__':
  file = r"D:\Downloads\1.mp4"    # 原始文件
  volume_size = 1024 * 1024 * 100 # 分卷大小 100MB
  path = zip_by_volume(file, volume_size)
  print(path)   # 输出分卷压缩文件的路径
方案存在的缺点与局限
缺点
该方法在创建分卷压缩文件时,必须先在磁盘上生成一个完整的临时压缩包,然后再将其拆分为多个分卷文件。这意味着数据会在磁盘上被写入两次,从而增加了I/O操作时间,降低了效率。
此外,尝试使用ByteIO进行内存中的字节流压缩并不可行。这种方式要求先将整个文件加载到内存中,对于体积庞大的文件而言,这会导致内存溢出,因此不具备实际操作性。
另一种尝试是使用io.pipe管道流进行处理。然而,zipfile库要求提供的文件对象必须实现seek()和tell()方法以定位并写入文件头信息,而管道流不支持随机访问(seek)。虽然参考了Python zipfile + os.pipe()探索记并屏蔽了这两个函数,但在分卷拆分过程中需要精确指定读取的字节数,这又依赖于seek和tell功能。这也解释了为什么zipfile库原生不支持创建分卷文件。
看来该库的作者也为此耗费了不少精力。目前,只能采用上述折中方案进行使用。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















