


Python使用sklearn实现KNN分类算法详解

发布时间:2026-10-13 |
5人浏览过
本文详细介绍如何使用Python的sklearn库实现KNN(K-Nearest Neighbors)分类算法。内容涵盖算法原理、核心步骤、距离计算方式及参数设置,并通过鸢尾花数据集的代码示例演示训练与预测过程,帮助读者快速掌握该基础分类模型的应用。
KNN算法原理与步骤
KNN(K-Nearest-Neighbours Classiflication)分类算法,供大家参考,具体内容如下
这是一种最基础的分类算法,其逻辑直观且易于理解和代码实现。
核心实现步骤为:选取与待分类点距离最近的k个样本,统计这k个样本中各类别的数量,将待分类点归入数量最多的那一类。
注意事项
- 该算法在预测时需要保存整个训练集的观测数据,以便根据距离判定待分类数据的归属类别。
- 参数k需要用户自定义设置,通常建议选取k<30的值。
- 距离计算通常采用欧氏距离,即
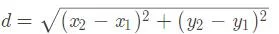
sklearn代码实现与结果
接下来通过sklearn库对数据进行KNN算法分类操作。
具体实现代码如下:
## 导入鸢尾花数据集
iris = datasets.load_iris()
data = iris.data[:, :2]
target = iris.target

## 区分训练集和测试集,75%的训练集和25%的测试集
train_data, test_data = train_test_split(np.c_[data, target])
## 训练并预测,其中选取k=15
clf = neighbors.KNeighborsClassifier(15, 'distance')
clf.fit(train_data[:, :2], train_data[:, 2])
Z = clf.predict(test_data[:, :2])
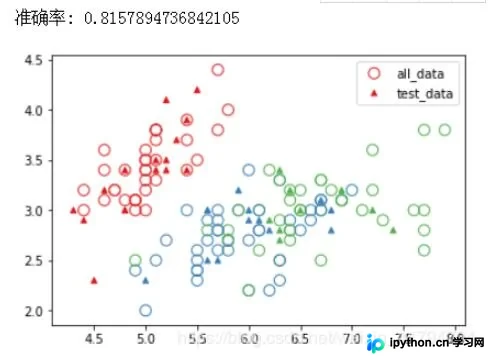
print '准确率:' ,clf.score(test_data[:, :2], test_data[:, 2])

colormap = dict(zip(np.unique(target), sns.color_palette()[:3]))
plt.scatter(train_data[:, 0], train_data[:, 1], edgecolors=[colormap[x] for x in train_data[:, 2]],c='', s=80, label='all_data')
plt.scatter(test_data[:, 0], test_data[:, 1], marker='^', color=[colormap[x] for x in Z], s=20, label='test_data')
plt.legend()
plt.show()
运行结果如下:
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















