


详解Python在使用JSON时需要注意的编码问题

本文深入解析Python中json.dumps处理中文时的编码机制。重点讲解ensure_ascii参数对非ASCII字符转义的影响,结合requests库发送数据时的常见错误,剖析Unicode码点转换原理及源码实现逻辑,并提供服务器端识别转义字符串的正确解码方法。
问题背景与字符编码基础
撰写本文的起因是在使用requests库调用接口时,直接利用请求参数中的json字段传输数据,导致服务器无法正确解析。经过排查发现,requests内部调用json.dumps将字符串转换为JSON格式时,默认会将非ASCII字符进行转义,致使发送数据中的中文被转为转义序列,从而引发服务器识别失败。本文虽聚焦于json.dumps的问题,但也涉及字符编码的基础知识,因此先简要介绍字符编码概念。
Python中的字符编码机制
在Python3环境中,内存里的字符以Unicode格式存储。常规字符占用两个字节,而部分生僻字符则需四个字节。所谓默认使用Unicode存储,可通过示例说明:在Python Shell中输入字符串'\u4e2d\u6587',观察其输出结果。
In [51]: '\u4e2d\u6587'
Out[51]: '中文'
上述操作输出为“中文”二字。其中,\u4e2d和\u6587分别代表“中”和“文”的Unicode编码(即码点)的十六进制表示。在Python3中,以\u开头的字符串会被解析为Unicode字符,并通过其十六进制码点还原为具体字符,因此“中文”在内存中的表示即为\u4e2d\u6587。
获取字符的Unicode码点
Python标准库提供了ord函数用于输出单个字符的Unicode码点,以及chr函数用于将码点转换回字符。具体示例如下。
In [54]: ord('中')
Out[54]: 20013

In [56]: chr(20013)
Out[56]: '中'
上述输出显示的码点采用十进制表示,可通过以下代码将整数格式化为十六进制字符串。
'{0:04x}'.format(20013)
json.dumps与ensure_ascii参数详解
使用json.dumps方法
基于前述背景,接下来讨论json.dumps的具体应用。以下通过一个示例进行说明。
In [121]: json.dumps('中文', ensure_ascii=True)
Out[121]: '"\\u4e2d\\u6587"'

In [122]: json.dumps('中文', ensure_ascii=False)
Out[122]: '"中文"'
从结果可见,当ensure_ascii参数为True时,中文被编码为Unicode码;若设为False,则能正常显示。这看似与ASCII无关,但需参考官方文档对该参数的解释。
官方文档指出:若ensure_ascii为True(默认值),输出将确保所有非ASCII字符被转义;若为False,这些字符将原样输出。
至此可稍作理解:当ensure_ascii为True时,若字符串包含非ASCII字符,系统会将其转义。根据结果可知,该字符被转为Unicode码并格式化为字符串。需注意,“\\u4e2d\\u6587”与“\u4e2d\u6587”不同,前者是长度为12的字符串,后者会被Python直接解析为“中文”,长度为2。这正是初期遇到的问题:直接将转义后的字符串在网络传输,若服务器不知其为转义序列,则视为普通字符串,导致识别错误。将ensure_ascii设为False可避免转义,直接使用原始字符。
转义字符的识别与解码方法
如何识别转义字符
若服务器接收数据后发现其为转义形式,该如何识别?实际上,转义字符串与使用unicode_escape编码后再以utf-8解码的结果一致,代码如下。
In [129]: msg
Out[129]: '中文'

In [130]: msg.encode('unicode_escape').decode('utf-8')
Out[130]: '\\u4e2d\\u6587'
因此,服务器只需反向操作,即先以utf-8编码,再以unicode_escape解码即可还原。
JSON转义源码实现原理
转义过程的实现原理
接下来分析json对字符转义的具体过程。调试json.dumps源码可知,其调用JSONEncoder.encode方法,而encode中的关键代码片段如下。
if self.ensure_ascii:
  return encode_basestring_ascii(o)
else:
  return encode_basestring(o)
该方法根据ensure_ascii的值选择调用不同函数。encode_basestring_ascii的值取决于(c_encode_basestring_ascii or py_encode_basestring_ascii),即默认使用C实现版本,其次为Python实现版本。既然存在Python版本,可进一步查看其实现方式,可通过from json.encoder import py_encode_basestring_ascii导入,并在其内部进行调试。源码如下。
def py_encode_basestring_ascii(s):
  """Return an ASCII-only JSON representation of a Python string

  """
  def replace(match):
    s = match.group(0)
    try:
      return ESCAPE_DCT[s]
    except KeyError:
      n = ord(s)
      if n < 0x10000:
        return '\\u{0:04x}'.format(n)
        #return '\\u%04x' % (n,)
      else:
        # surrogate pair
        n -= 0x10000
        s1 = 0xd800 | ((n >> 10) & 0x3ff)
        s2 = 0xdc00 | (n & 0x3ff)
        return '\\u{0:04x}\\u{1:04x}'.format(s1, s2)
  return '"' + ESCAPE_ASCII.sub(replace, s) + '"'
观察最后的return语句,可见其本质是正则替换,并在前后添加双引号。ESCAPE_ASCII的定义如下。
ESCAPE_ASCII = re.compile(r'([\\"]|[^\ -~])')
其中,([\\"]用于匹配反斜杠和双引号,而[^\ -~]表示对空格到波浪号(~)范围内的字符取反(此处反斜杠可能用于转义空格,具体行为可能因环境略有差异,但不影响匹配逻辑)。在ASCII表中,空格对应十进制40,~对应176,此为所有可打印字符范围;取反即匹配编码不在40至176之间的字符,故中文会被匹配。ASCII表参考如下。
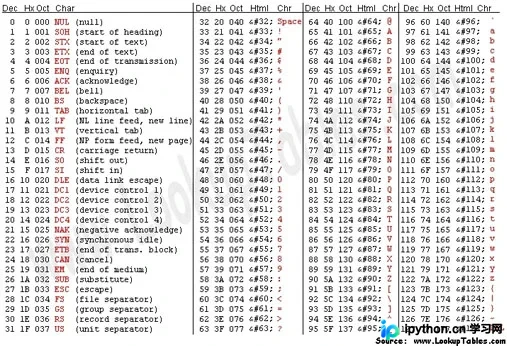
对于匹配到的字符,会传入回调函数replace进行转义处理。replace函数中的ESCAPE_DCT定义如下。
ESCAPE_DCT = {
  '\\': '\\\\',
  '"': '\\"',
  '\b': '\\b',
  '\f': '\\f',
  '\n': '\\n',
  '\r': '\\r',
  '\t': '\\t',
}
该字典处理常用字符的转义;若未命中,则获取其Unicode码点,并判断是否小于0x10000(即是否为两字节字符,最大值为0xFFFF)。若是,则格式化为Unicode码;否则,使用四字节表示(涉及代理对处理)。
总结
在使用requests发送JSON数据时,务必注意中文编码问题,建议将ensure_ascii设为False或确保服务器能正确解析转义序列。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















