


Python爬虫实战:煎蛋网图片抓取与404错误排查

本文详解使用Python爬取煎蛋网图片的完整流程,涵盖urllib.request与os库的应用。重点分析因网页结构变化导致的404错误,通过对比前5面与后5面URL格式差异,定位find()函数匹配失效原因,并提出使用正则或BeautifulSoup优化的建议,帮助开发者规避常见抓取陷阱。
Python爬取煎蛋网图片实战
本文提供Python爬取煎蛋网图片的完整代码示例,内容详实,对学习与工作具有参考价值。
本次实践尝试爬取煎蛋网的图片资源。
主要依赖以下Python库:
- urllib.request
- os
通过封装几个核心函数,分别控制下载图片的页数、获取目标网页内容、解析网页总页数以及将图片保存至本地,整体流程简洁清晰。
核心代码实现
具体源代码如下:
import urllib.request
import os


def url_open(url):
  req = urllib.request.Request(url)
  req.add_header('user-agent','Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/75.0.3770.100 Safari/537.36')
  response = urllib.request.urlopen(url)
  html = response.read()

  return html

def get_page(url):
  html = url_open(url).decode('utf-8')

  a = html.find('current-comment-page')+23
  b = html.find(']',a)

  return html[a:b]


def find_imgs(url):
  html = url_open(url).decode('utf-8')
  img_addrs = []

  a = html.find('img src=')

  while a != -1:
    b = html.find('.jpg',a ,a+255)
    if b != -1:
      img_addrs.append('https:'+html[a+9:b+4]) # 'img src='为9个偏移 '.jpg'为4个偏移
    else:
      b = a+9
    a = html.find('img src=', b)

  return img_addrs


def save_imgs(folder, img_addrs):
  for each in img_addrs:
    filename = each.split('/')[-1]
    with open(filename, 'wb') as f:
      img = url_open(each)
      f.write(img)
    print(img_addrs)

def download_mm(folder = 'xxoo', pages = 5):
  os.mkdir(folder)
  os.chdir(folder)

  url = 'http://jandan.net/ooxx/'
  page_num = int(get_page(url))

  for i in range(pages):
    page_num -= i
    page_url = url + 'page-'+ str(page_num) + '#comments'
    img_addrs = find_imgs(page_url)
    save_imgs(folder, img_addrs)

if __name__ == '__main__':
  download_mm()
404错误排查与优化建议
在主函数download_mm()中,初始设置下载页数为5页。
原本计划设置为10页,但在程序运行过程中遇到了404 ERROR错误。
该错误指向imgae_url获取异常。为此在save_img()函数中增加测试代码print(img_addrs)以排查问题。
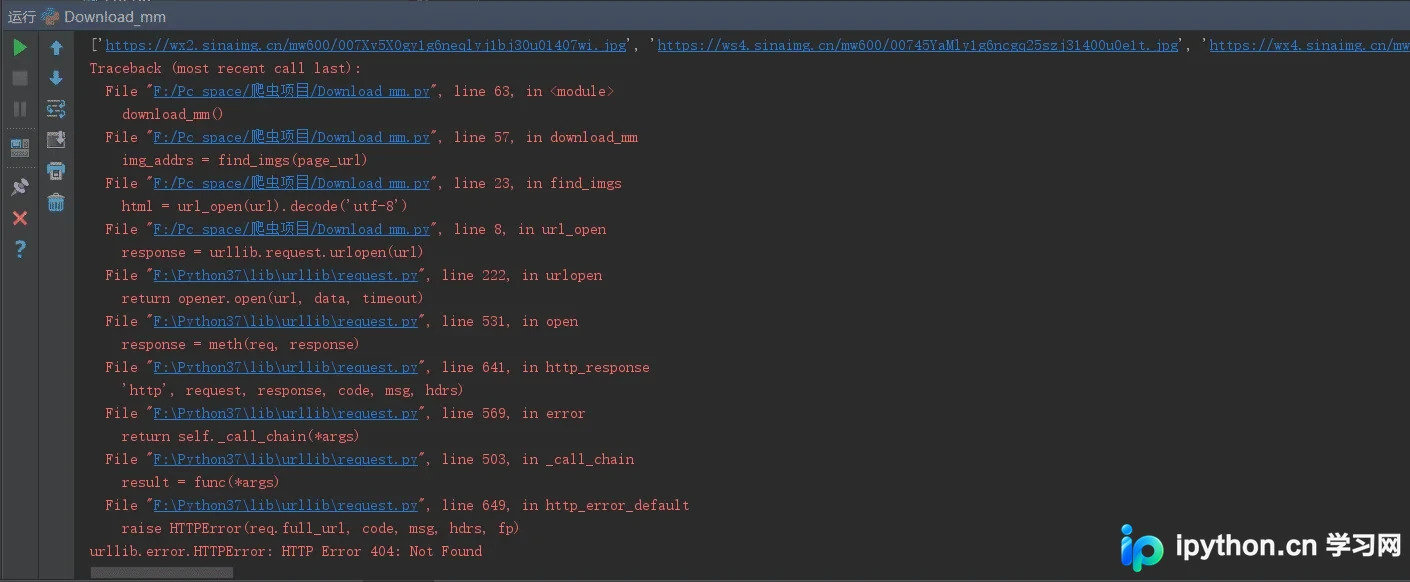
推测可能是后续页数的图片img_url格式发生变动导致404,因此将pages参数调整为5。
重新运行后结果正常,图片可以成功下载:
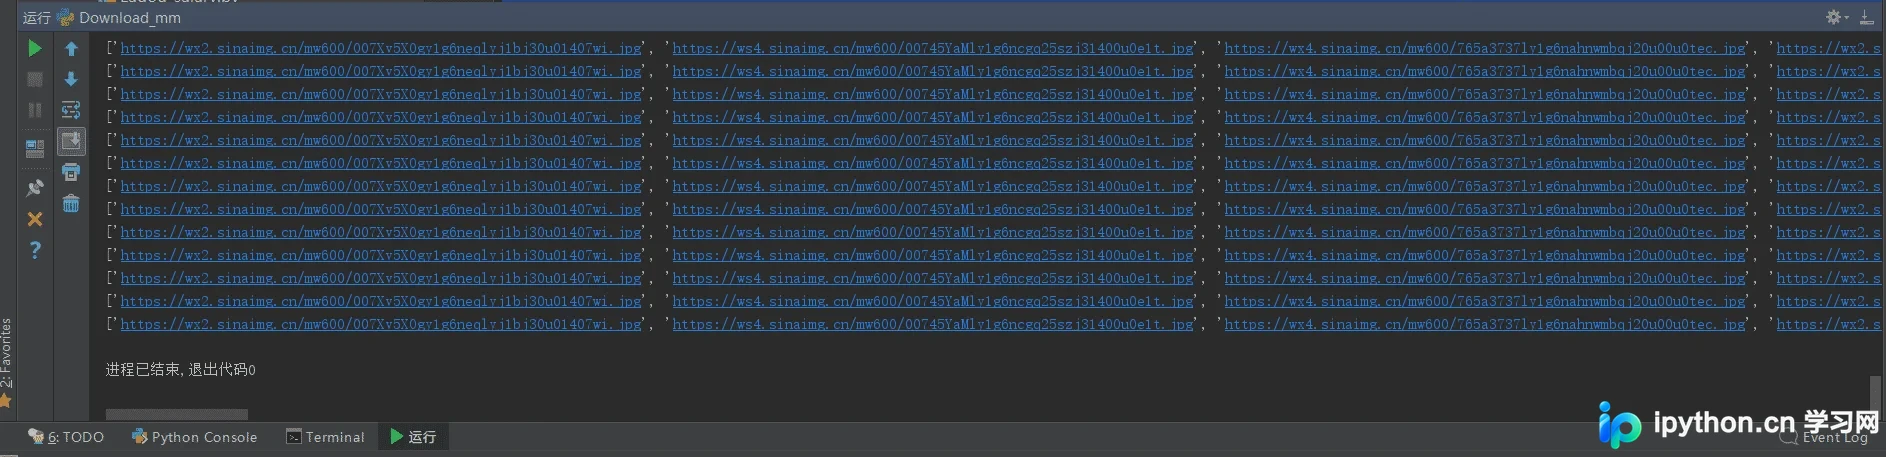
经观察发现,从第5页之后的图片开始出现无法下载的情况(404)。为此直接访问煎蛋网第6页查看图片URL结构。

上图展示后5面的图片URL,下图展示前5面的图片URL。
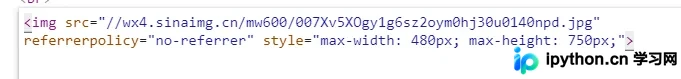
原代码使用find()函数定位<img src='...'>中的.jpg图片URL,但后5页的HTML结构变为a href,导致原有正则匹配失效,进而引发404 ERROR。若需下载后续图片,需重新添加针对新结构的URL定位逻辑。
具体而言,需在find中将匹配目标由img src改为a href,并相应调整偏移量。
总结:
使用find()定位网页标签效率较低,未来爬虫开发中建议尽量采用正则表达式或Beautifulsoup库以提升效率。目前对这两项技术尚不熟练,需加强训练。
以上为本文全部内容,希望对读者有所帮助,欢迎支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















