


Python实现简单网页图片抓取完整代码实例

发布时间:2026-10-14 |
3人浏览过
本文详细介绍如何使用Python的urllib和re模块抓取网页图片。通过获取HTML源码,利用正则表达式过滤图片URL,并实现本地保存功能。代码以百度贴吧为例,演示了从获取源码、解析链接到创建文件夹保存多张图片的完整流程,适合Python初学者参考学习。
Python抓取网页图片的基本步骤
使用Python抓取网络图片主要包含三个步骤: 1、根据指定的网址获取网页源代码 2、利用正则表达式从源代码中提取图片地址 3、根据提取到的图片地址下载网络图片到本地
以下是一个相对简单的示例,展示如何抓取某个百度贴吧网页中的图片:
基础图片抓取代码实现
# -*- coding: utf-8 -*-
# feimengjuan
import re
import urllib
import urllib2
#抓取网页图片
#根据给定的网址来获取网页详细信息,得到的html就是网页的源代码
def getHtml(url):
  page = urllib.urlopen(url)
  html = page.read()
  return html
 def getImg(html):
  #利用正则表达式把源代码中的图片地址过滤出来
  reg = r'src="(.+?\.jpg)" pic_ext'
  imgre = re.compile(reg)
  imglist = imgre.findall(html) #表示在整个网页中过滤出所有图片的地址,放在imglist中
  x = 0
  for imgurl in imglist:
    urllib.urlretrieve(imgurl,'%s.jpg' %x) #打开imglist中保存的图片网址,并下载图片保存在本地
    x = x + 1
 html = getHtml("http://tieba.baidu.com/p/2460150866")#获取该网址网页详细信息,得到的html就是网页的源代码
getImg(html)#从网页源代码中分析并下载保存图片
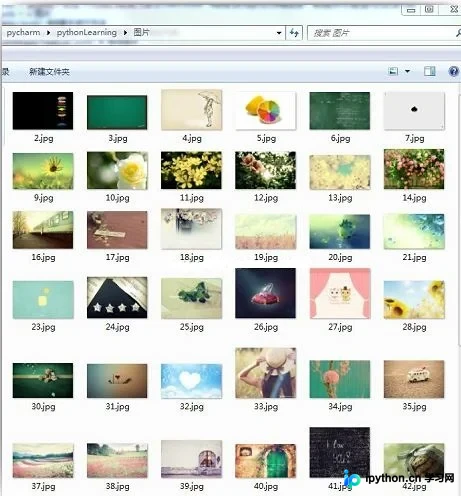
对代码进行了优化整理,在本地创建了一个名为“图片”的文件夹用于存储下载的图片
优化代码:创建文件夹并批量保存
# -*- coding: utf-8 -*-
# feimengjuan
import re
import urllib
import urllib2
import os
#抓取网页图片
#根据给定的网址来获取网页详细信息,得到的html就是网页的源代码
def getHtml(url):
  page = urllib.urlopen(url)
  html = page.read()
  return html

#创建保存图片的文件夹
def mkdir(path):
  path = path.strip()
  # 判断路径是否存在
  # 存在  True
  # 不存在 Flase
  isExists = os.path.exists(path)
  if not isExists:
    print u'新建了名字叫做',path,u'的文件夹'
    # 创建目录操作函数
    os.makedirs(path)
    return True
  else:
    # 如果目录存在则不创建,并提示目录已经存在
    print u'名为',path,u'的文件夹已经创建成功'
    return False
# 输入文件名,保存多张图片
def saveImages(imglist,name):
  number = 1
  for imageURL in imglist:
    splitPath = imageURL.split('.')
    fTail = splitPath.pop()
    if len(fTail) > 3:
      fTail = 'jpg'
    fileName = name + "/" + str(number) + "." + fTail
    # 对于每张图片地址,进行保存
    try:
      u = urllib2.urlopen(imageURL)
      data = u.read()
      f = open(fileName,'wb+')
      f.write(data)
      print u'正在保存的一张图片为',fileName
      f.close()
    except urllib2.URLError as e:
      print (e.reason)
    number += 1
#获取网页中所有图片的地址
def getAllImg(html):
  #利用正则表达式把源代码中的图片地址过滤出来
  reg = r'src="(.+?\.jpg)" pic_ext'
  imgre = re.compile(reg)
  imglist = imgre.findall(html) #表示在整个网页中过滤出所有图片的地址,放在imglist中
  return imglist
#创建本地保存文件夹,并下载保存图片
if __name__ == '__main__':
  html = getHtml("http://tieba.baidu.com/p/2460150866")#获取该网址网页详细信息,得到的html就是网页的源代码
  path = u'图片'
  mkdir(path) #创建本地文件夹
  imglist = getAllImg(html) #获取图片的地址列表
  saveImages(imglist,path) # 保存图片
最终在“图片”文件夹中保存了数十张图片,效果如截图所示:
总结
以上就是本文关于Python实现简单网页图片抓取完整代码实例的全部内容,希望对大家有所帮助。感兴趣的朋友可以继续参阅本站:
Python爬虫实例爬取网站搞笑段子
python爬虫系列Selenium定向爬取虎扑篮球图片详解
如有不足之处,欢迎留言指出。感谢朋友们对本站的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















