


Python3使用Requests库批量抓取网络图片教程

本文详细介绍如何利用Python3的Requests库结合正则表达式,实现从百度图片批量抓取指定关键词图片的功能。教程涵盖通过开发者工具分析网络请求、提取目标URL、解析HTML源码以及编写下载脚本的完整流程,帮助初学者掌握基础的网络数据抓取技术。
爬虫技术入门与目标定位
近期我对网络爬虫技术产生了浓厚兴趣,并进行了相关学习。看到网络上许多教程展示如何获取大量图片,我也尝试实践,下面直接进入技术核心部分。
抓取图片的本质与下载图片类似,核心操作均围绕链接(URL)展开。因此,在明确抓取目标后,首要任务是定位并获取这些链接。以百度图片为例,我们需要先通过搜索功能获取初始页面。
使用开发者工具分析网络请求
接下来,利用浏览器自带的开发者工具进行分析。可以通过按下F12键或右键点击页面选择“检查元素”来进入开发者模式。
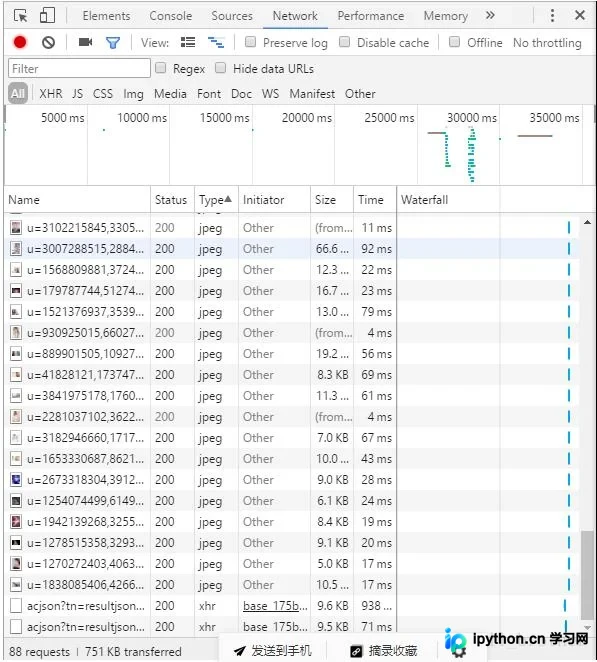
在开发者工具中,重点观察Network(网络)标签下的XHR请求。如果未直接看到XHR,尝试向下滚动页面以触发更多加载请求,并仔细对比不同请求之间的差异。
第一个观察到的请求结构如下(具体结构见原图)。
第二个观察到的请求结构如下(具体结构见原图)。
解析URL规律与提取关键数据
请注意观察参数pn,它似乎是30的倍数,且随着页面滑动,加载的图片数量也在增加。确认这一规律后,我们需要进一步分析请求URL。首先查看原网页的源代码。
原网页源码中的请求链接示例如下:view-source:http://image.baidu.com/search/index?tn=baiduimage&ipn=r&ct=201326592&cl=2&lm=-1&st=-1&fm=index&fr=&hs=0&xthttps=111121&sf=1&fmq=&pv=&ic=0&nc=1&z=&se=1&showtab=0&fb=0&width=&height=&face=0&istype=2&ie=utf-8&word=%E7%BE%8E%E5%A5%B3&oq=%E7%BE%8E%E5%A5%B3&rsp=-1
对比两个Requests URL对应的页面内容,可以发现它们具有相似的结构特征。
无需关注其他无关信息,我们的目标是提取ObjURL字段。在源码中,该字段格式通常为:"ObjURL":"http:\/\/image.tianjimedia.com\/uploadimages\/2015\/131\/34\/545szi3x5s84_680x500.jpg"。
Python代码实现与效果测试
明确了数据位置后,接下来就是编写程序代码来实现自动化抓取。
import re
import requests
import os

name=input('输入文件夹名称:')
robot='C:/Users/lenovo/Desktop/'+name+'/'
kv={'user-agent':'mozilla/5.0'}

#获取url对应的源码页面
def getHTMLText(url):
 try:
  r=requests.get(url,timeout=30,headers=kv)
  r.raise_for_status()
  r.encoding=r.apparent_encoding
  return r.text
 except:
  return ''

#解析url源码页面
def parserHTML(html):
#正则表达式为获取ObjURL
 pattern=r'"ObjURL":"(.*?)"'
 reg=re.compile(pattern)
 urls=re.findall(reg,html)
 return urls

#下载图片
def download(List):
 for url in List:
  try:
   path=robot+url.split('/')[-1]
   url=url.replace('\\','')
   r=requests.get(url,timeout=30)
   r.raise_for_status()
   r.encoding=r.apparent_encoding
   if not os.path.exists(robot):
    os.makedirs(robot)
   if not os.path.exists(path):
    with open(path,'wb') as f:
     f.write(r.content)
     f.close()
     print(path+' 文件保存成功')
   else:
    print('文件已经存在')
  except:
   continue

#通过Requests URL请求到更多的url源码页面
def getmoreurl(num,word):
 ur=[]
 url=r'http://image.baidu.com/search/acjson?tn=resultjson_com&ipn=rj&ct=201326592&is=&fp=result&queryWord={word}&cl=2&lm=-1&ie=utf-8&oe=utf-8&adpicid=&st=-1&z=&ic=0&word={word}&s=&se=&tab=&width=&height=&face=0&istype=2&qc=&nc=1&fr=&cg=girl&pn={pn}&rn=30'
 for x in range(1,num+1):
#word为搜索关键词,num为想获取的页面数量
  u=url.format(word=word,pn=30*x)
  ur.append(u)
 return ur

def main():
 n=int(input('输入想下载多少张图片(n*30):'))
 word=input('输入想下载的图片:')
#初始页面url
 url='http://image.baidu.com/search/index?tn=baiduimage&ipn=r&ct=201326592&cl=2&lm=-1&st=-1&fm=result&fr=&sf=1&fmq=1499773676062_R&pv=&ic=0&nc=1&z=&se=1&showtab=0&fb=0&width=&height=&face=0&istype=2&ie=utf-8&word={word}'.format(word=word)
 html=getHTMLText(url)
 urls=parserHTML(html)
 download(urls)
#下面操作获取的更多页面图片
 url1=getmoreurl(n,word)
 for i in range(n):
  html1=getHTMLText(url1[i])
  urls1=parserHTML(html1)
  download(urls1)

main()
编写完成后,运行程序测试实际效果。
希望这个简单的示例能得到大家的理解与包容。
以上是关于使用Python3 Requests库实现多图片爬取的完整教程,希望能为读者提供参考。欢迎支持本站,获取更多技术分享。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















