


Python使用re模块爬取豆瓣Top250电影实战指南

发布时间:2026-10-14 |
3人浏览过
本文详细介绍使用Python爬取豆瓣电影Top250的完整流程。通过requests发送请求并设置User-Agent避免封禁,利用re模块正则表达式精准提取电影名称、评分及评价人数,最后将结果保存至本地文件。代码包含完整的请求、解析与保存逻辑,适合Python初学者学习网络爬虫基础。
爬虫基本原理与流程
爬虫的基本原理可归纳为四个核心步骤:
第一步是发送网络请求,通常使用Python的requests库来实现。
第二步是获取服务器返回的响应数据,即目标网页的原始内容。
第三步是对获取到的数据进行解析,并从中提取出我们感兴趣的关键信息,这里主要依赖re(正则表达式)模块进行匹配。
第四步是将提取到的数据保存下来,通常通过with open()语句进行文件读写操作。
在实际操作中,爬虫流程常被简化为三个主要环节:
首先是发送请求,建立与目标网站的连接。
其次是解析数据,从HTML或JSON中提取有效信息。
最后是保存数据,将处理后的结果持久化存储。
特别需要注意的是,在爬取豆瓣网页时,必须正确设置请求头(Headers),否则服务器可能会拒绝返回数据。
Python代码实现详解
import re
import requests

# 爬蟲三部曲:
# 1.获取请求
def get_data(url, headers):
  response = requests.get(url, headers=headers)
  # 如果爬取的是html文本就是用.text方法获取文本数据,如果爬取的是音视频就用.content方法获取二进制流数据
  # print(response.text)  # 获取相应文本,比如html代码
  return response.text

# 2.解析数据
def parser_data(text):
  # re.findall("正则表达式", "过滤的文本", re.S) # 匹配模式:re.S 全局模式
  data = re.findall(
    '<div class="item">.*?<a href="(.*?)" rel="external nofollow" >.*?<span class="title">(.*?)</span>.*?<span class="rating_num" property="v:average">(.*?)</span>.*?<span>(.*?)人评价</span>', text, re.S)
  for move_info in data:
    yield move_info

# 3.保存数据
def save_data(res_list_iter):
  with open("豆瓣TOP250.txt", "a", encoding="utf-8") as f:
    for i in res_list_iter:
      move_page, move_title, move_score, move_evaluation = i
      # print(move_page, move_title, move_score, move_evaluation)
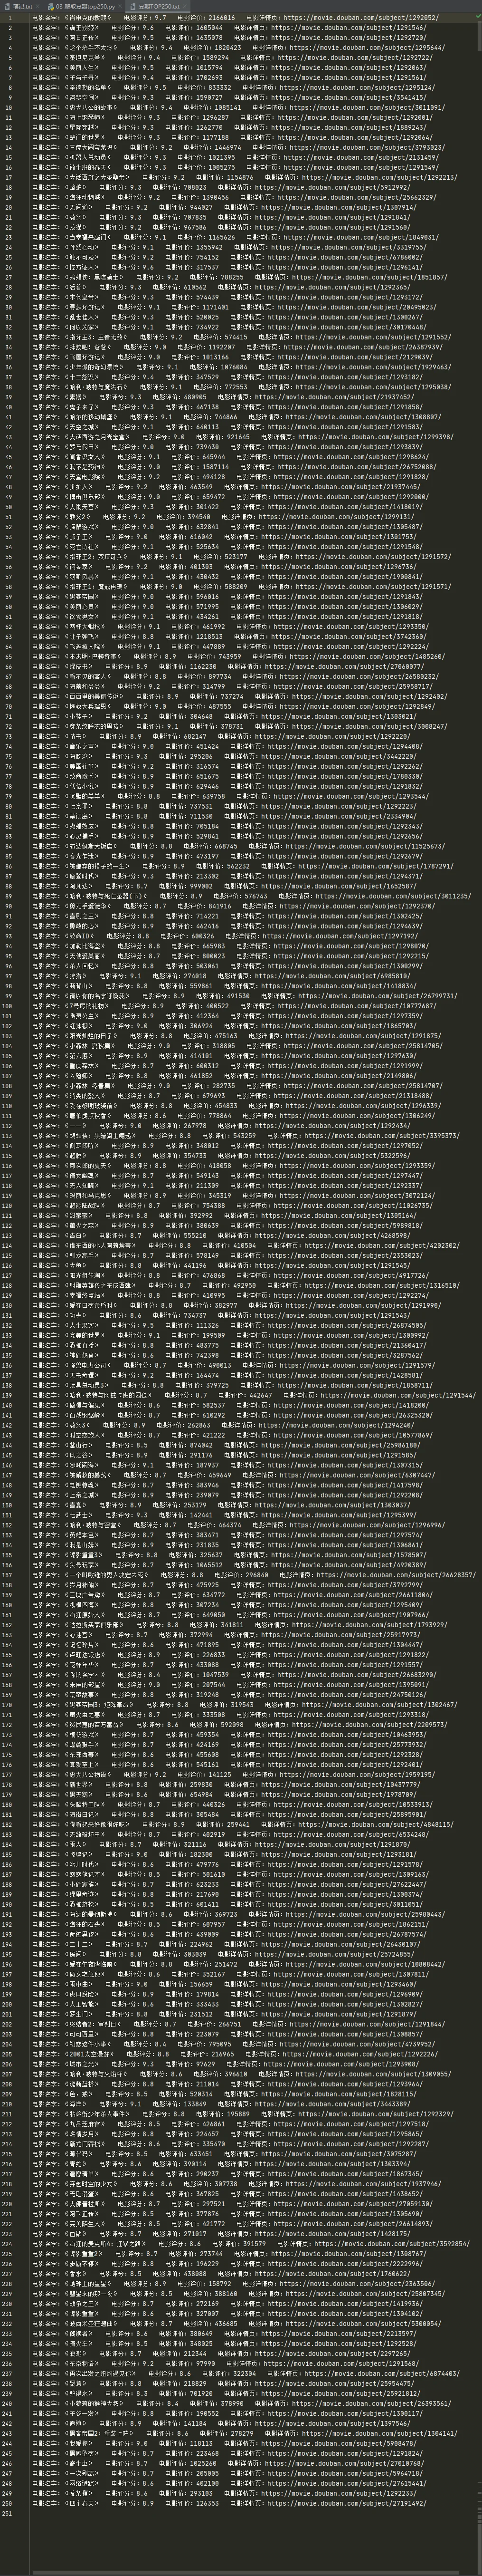
      str1 = f"电影名字:《{move_title}》  电影评分:{move_score}  电影评价:{move_evaluation}  电影详情页:{move_page}\n"
      f.write(str1)

# 使用请求头请求数据
headers = {
  'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/70.0.3538.102 \
  Safari/537.36'
}
n = 0
# 获取10个链接
for i in range(10):
  url = f"https://movie.douban.com/top250?start={n}&filter=="
  n += 25
  text = get_data(url, headers)
  res_list_iter = parser_data(text)
  save_data(res_list_iter)
以下是代码执行后的预期结果展示:
以上就是关于使用Python re模块爬取豆瓣Top250电影的详细教程,更多Python爬虫相关技术文章欢迎持续关注本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















