


Python批量处理TXT文件并写入Excel的完整流程

发布时间:2026-10-13 |
2人浏览过
本文介绍使用Python批量处理多个TXT文件的方法。通过遍历指定文件夹获取文件列表,提取文件名中的通道与电容信息进行排序,读取TXT数据并计算指定列的均值,最后利用openpyxl库将结果写入Excel文件。代码包含文件遍历、路径解析及Excel读写操作,适用于日志数据的批量分析场景。
Python批量处理TXT文件流程概述
本文演示如何使用Python脚本对多个TXT文件进行批量处理。
- 首先需要确定文件所在的目录路径,并读取该目录下的所有文件。
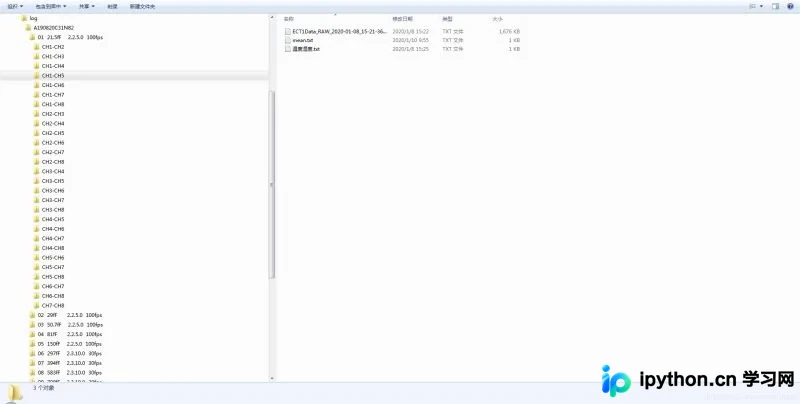
- 从文件路径中提取文件名和文件夹名称,以便后续对数据进行分类和索引。
- 根据提取的文件夹名称,对相应的通道文件夹进行排序,确保数据顺序一致。
- 针对TXT文件内部的数据,选取特定的某一列或某一行进行均值计算处理。
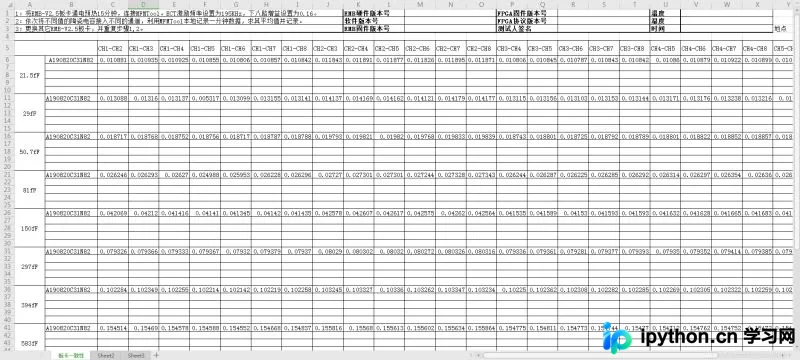
- 将计算得到的均值结果写入到预先准备好的Excel文件中。
- 完成数据写入后,关闭Excel文件以保存更改并释放资源。
核心代码实现与文件遍历
#import numpy as np
import pandas as pd
import os
folder = 'D:/log/A190820C31N82'
def all_files_in_a_folder_iter(folder):
  import os
  for root, dirs, files in os.walk(folder):
    for file in files:
      # 获取文件路径
      yield (os.path.join(root, file))
#对CH1-CH2到CH7-CH8的文件夹进行排序
l = os.listdir('D:/log/A190820C31N82/08 583fF  2.3.10.0 30fps')
dic ={}
n=1
for i in l:
  if 'CH' in i:
    dic[i] = n
    n=n+1
#对电容大小排序
dd = os.listdir('D:/log/A190820C31N82')
dsc = {}
m=1
for j in dd:
  if 'fF' in j:
    dsc[j] = m
    m=m+1
#import xlrd
#import xlwt
from openpyxl import load_workbook
#import openpyxl
#打开Excel文件
wb = load_workbook('D:/log/data_process.xlsx')#生成一个已存在的wookbook对象
wb1 = wb.active#激活sheet
for i in all_files_in_a_folder_iter(folder):
  if '.txt' in i and 'ECT' in i:
#    print(i)
    a = pd.read_table(i,header=None)
    s = i.split('\\')[2]
    t = i.split('\\')[1]
    n = dic[s]
    m = dsc[t]
    res = a.values[:,n].mean() #做均值处理,保存结果

    wb1.cell(t*5+1,n+2,res)#往sheet中的第t*5+1行第n+2列写入均值
wb.save('D:/log/data_process.xlsx')#保存
wb.close()
文件结构说明与总结
具体的文件目录结构如下图所示。
综上所述,该方案实现了从TXT读取、数据处理到Excel写入的全自动化流程。
以上即为Python批量处理TXT文件的实例代码详解,希望能为读者提供实际帮助。如有任何疑问,欢迎留言交流,小编会及时回复。感谢大家对本站的支持!若觉得本文对您有帮助,欢迎转载,请注明出处,谢谢!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















