


Python爬虫实战:解析B站视频系列总时长

本文介绍利用Python脚本自动获取Bilibili系列视频总时长的方法。通过抓取网页源码中的timelength字段,结合正则表达式解析分集数量,实现批量视频时长的快速统计。文章包含详细操作步骤及完整GitHub源码链接,适合Python初学者参考学习。
背景与需求分析
说明:最近在B站观看材料力学相关视频时,发现部分UP主将内容拆分为极多的集数,有些甚至多达上百集。为了直观了解这类系列视频的总时长,我决定编写一个简单的脚本进行统计分析。
以下是具体的分析过程:
网页源码解析步骤
第一步,打开目标视频页面。
第二步,在页面任意位置右键点击,选择“查看网页源代码”。
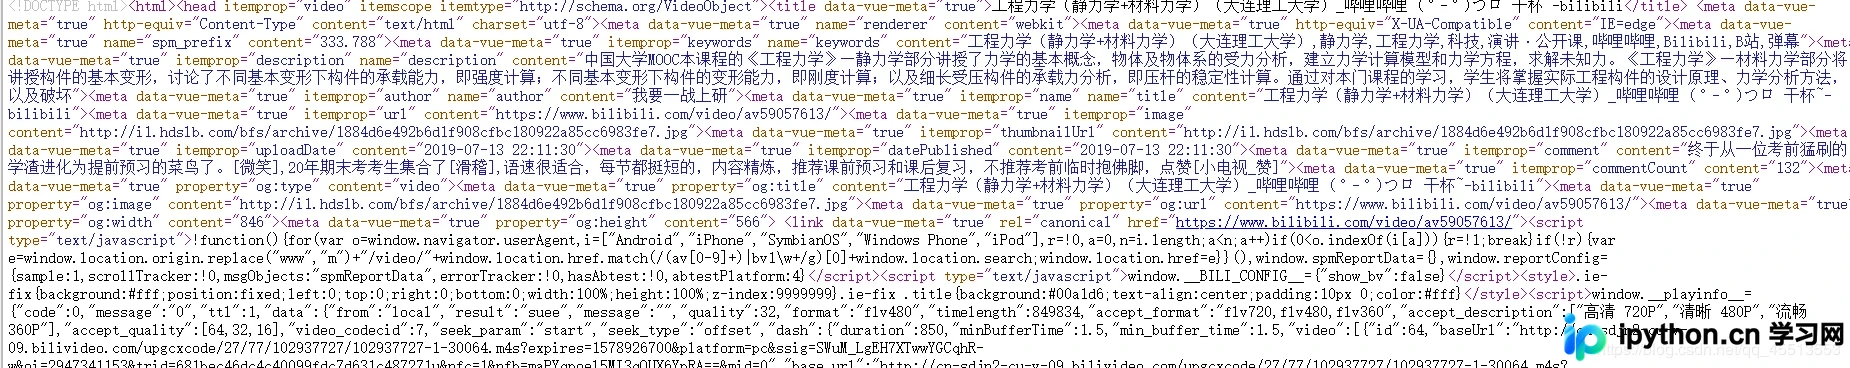
既然目标是获取时间信息,我们在源码中搜索与time相关的关键词。很快就能找到名为timelength的字段。具备基础英语知识的人应该能猜到,这代表时长。虽然过程看似简单,但直接将该数值除以60或3600并不能得到正确的分钟或小时数。经过进一步观察,发现该数值的前几位数字除以60即可得到所需结果,从而顺利获取了单集时长数据。
批量分集数据处理策略
随后遇到另一个问题:虽然单个页面能显示信息,但面对大量分集,手动输入显然不现实。经查看,该系列共有93集,直接搜索所有页面效率低下。考虑到之前发现的timelength参数具有类似字典的结构特征,尝试按字典格式进行搜索。结果显示,这种方法非常有效,第一个搜索结果即为目标数据。这种简洁的解决方式让问题迎刃而解。
Python实现代码与源码获取
最后是完整的Python代码。作为初学者作品,恳请资深开发者指正。如有不足之处,敬请谅解。完整源码已上传至GitHub。
import requests
import re
import pygame
import time

header = {'User-Agent': 'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) '
            'Chrome/74.0.3729.157 ''Safari/537.36 '}


class Bili(object):
  def __init__(self, url):
    self.url = url
    self.max_page = 0
    self.the_time = list()
    self.sum_time = 0
    self.b_url = 'https://www.bilibili.com/video/av' + re.search(r'av(\d+)', url).group(1) + '?p='

  @staticmethod
  def get_html(acp_url):
    try:
      r = requests.get(acp_url, headers=header)
      r.raise_for_status()
      r.encoding = r.apparent_encoding
      return r.text
    except Exception as result:
      print("get_html:", result)
      return ""

  def parse_max_page(self):
    self.max_page = int(re.findall(r'videos":(.+?),', self.get_html(self.url))[0])

  def parse_time(self, se_url):
    text = self.get_html(se_url)
    single_time = re.findall(r'"timelength":(\d+),', text)[0][:-3]
    return single_time

  def get_time(self):
    for i in range(self.max_page + 1):
      s_url = self.b_url + str(i)
      ret = self.parse_time(s_url)
      self.the_time.append(ret)
      print("第%d页 time=%s" % (i, ret))
    for each in self.the_time:
      self.sum_time += int(each)
    print("sum_time:%.3s h" % str(self.sum_time / 60))

  def main(self):
    self.parse_max_page()
    self.get_time()


if __name__ == '__main__':
  i_url = input("请输入链接地址[要以+结尾]:")
  Bili(i_url).main()
代码说明
语句i_url = input("请输入链接地址[要以+结尾]:")中,由于部分编译环境的行为特性,直接回车可能会导致光标跳转或执行异常,需注意输入格式。
GitHub源码地址:https://github.com/easyprogramer/My_Python_Spider/tree/master
以上就是本文的全部内容,希望能为各位的学习提供帮助,也欢迎大家继续支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















