


Python爬虫实战:requests库核心用法与异常处理详解

本文详细解析Python中requests库的核心用法,涵盖安装配置、GET与POST请求参数传递、JSON解析、文件保存、Headers与代理设置、Cookie会话维持、证书验证及超时异常捕获等关键操作,帮助开发者高效构建稳定的网络爬虫程序。
Python爬虫技术:深入解析requests库
requests是Python生态中一款简洁高效的HTTP客户端库,其API设计比底层urllib更为直观易用。通过requests,开发者可以轻松地发送HTTP/1.1协议请求,只需指定目标URL并可选地附加查询字符串,即可快速实现网页数据抓取等网络交互操作。
由于requests属于第三方扩展库,在首次使用前需通过命令行工具(如CMD或终端)执行安装命令以完成环境配置。
pip install requests
安装成功后,在Python脚本中执行import导入操作,若未报错则表明库已正确集成,可立即投入开发使用。
基础调用方法如下:
调用requests.get()函数可向指定目标发起网络请求,该函数返回一个HTTPResponse类型的对象,封装了服务器响应的所有数据。
import requests
response = requests.get('http://www.baidu.com')
print(response.status_code)  # 打印状态码
print(response.url)          # 打印请求url
print(response.headers)      # 打印头信息
print(response.cookies)      # 打印cookie信息
print(response.text)  #以文本形式打印网页源码
print(response.content) #以字节流形式打印
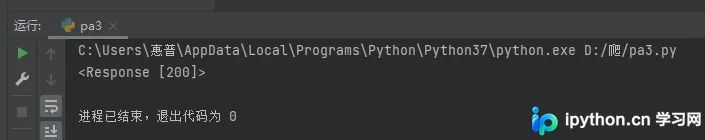
以下示例演示如何获取并打印响应状态码,运行后输出结果如下:
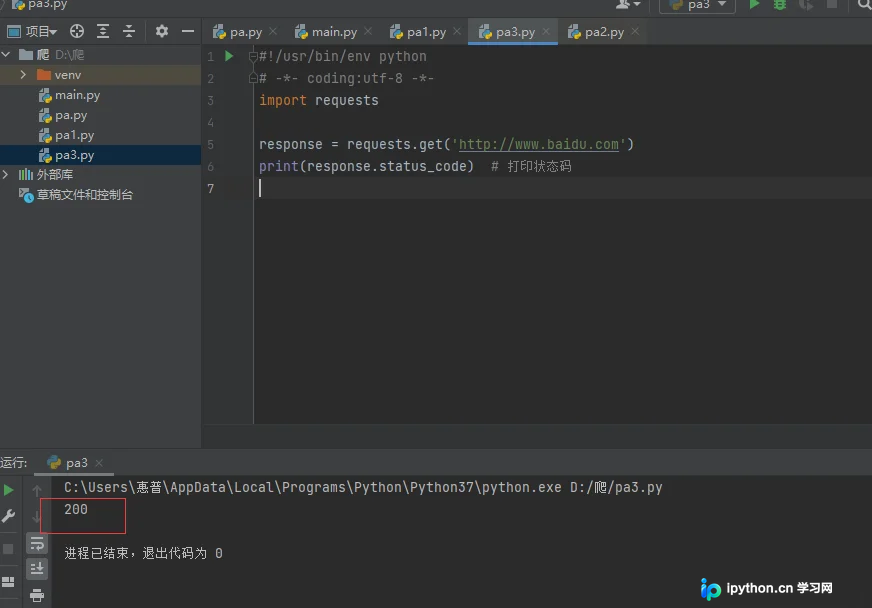
当返回的状态码为200时,表明请求已成功发送至目标网站且服务器正常响应。
若状态码返回403,通常意味着目标网站部署了防火墙或反爬机制,导致当前IP被限制访问。
requests支持多种HTTP请求方式,具体包括:
import requests
requests.get('http://www.baidu.com')
requests.post('http://www.baidu.com')
requests.put('http://www.baidu.com')
requests.delete('http://www.baidu.com')
requests.head('http://www.baidu.com')
requests.options('http://www.baidu.com')
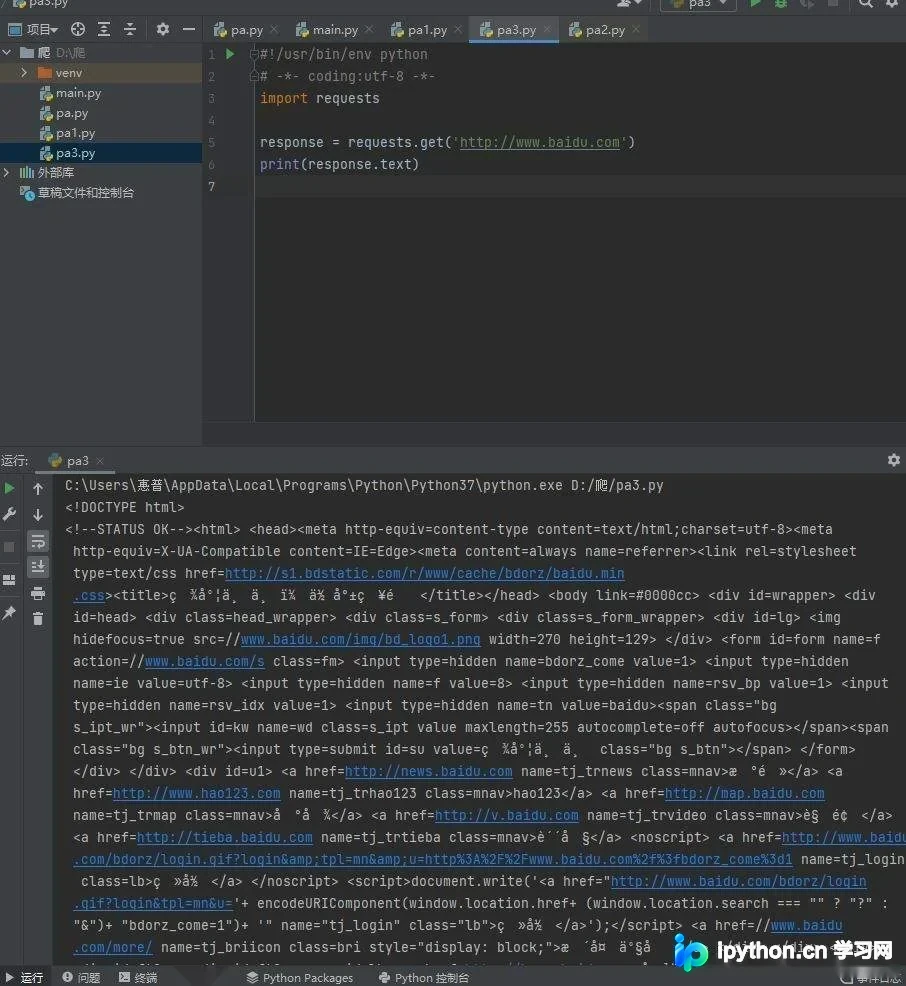
最基础的GET请求示例:
import requests
response = requests.get('http://www.baidu.com')
print(response.text)
带有查询参数的GET请求实现方式:
第一种方式是将参数直接拼接在URL字符串中。
import requests
response = requests.get("https://www.crrcgo.cc/admin/crr_supplier.html?params=1")
print(response.text)
第二种推荐方式是将参数封装在字典中,并在发起请求时通过params参数传入该字典,由库自动处理编码。
import requests
data = {
    'params': '1',
}
response = requests.get('https://www.crrcgo.cc/admin/crr_supplier.html?', params=data)
print(response.text)
基本的POST请求示例:
import requests
response = requests.post('http://baidu.com')
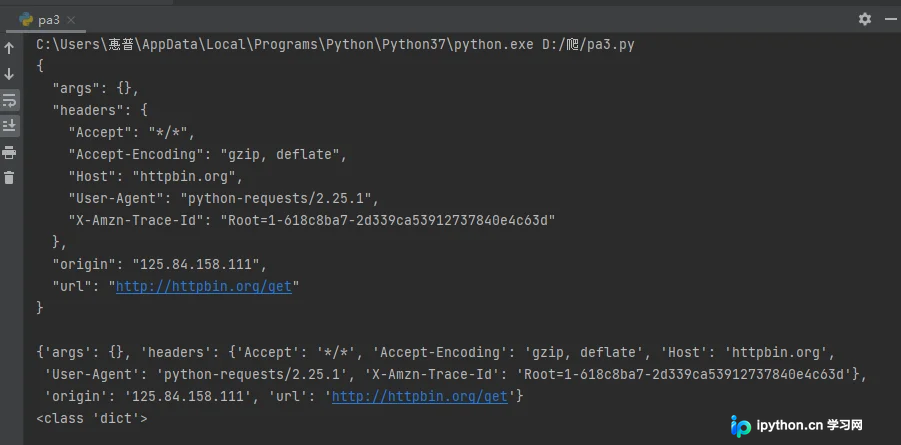
解析服务器返回的JSON数据:
import requests
response = requests.get('http://httpbin.org/get')
print(response.text)
print(response.json())  #response.json()方法同json.loads(response.text)
print(type(response.json()))
演示如何简单保存二进制文件(如图片)到本地:
import requests
response = requests.get('http://img.ivsky.com/img/tupian/pre/201708/30/kekeersitao-002.jpg')
b = response.content
with open('F://fengjing.jpg','wb') as f:
    f.write(b)
为HTTP请求添加自定义头部信息(Headers):
import requests
heads = {}
heads['User-Agent'] = 'Mozilla/5.0 ' \
                          '(Macintosh; U; Intel Mac OS X 10_6_8; en-us) AppleWebKit/534.50 ' \
                          '(KHTML, like Gecko) Version/5.1 Safari/534.50'
 response = requests.get('http://www.baidu.com',headers=headers)
正确设置User-Agent等Header信息可有效规避部分防火墙检测,从而隐藏客户端真实身份。
配置并使用网络代理:
与添加Headers类似,代理配置也通过字典形式传递。此处代码演示了从IP代理网站抓取IP、端口及类型信息的过程。需注意,免费代理地址往往不稳定且极易失效。
相关代码实现如下:
import requests
import re
def get_html(url):
    proxy = {
        'http': '120.25.253.234:812',
        'https' '163.125.222.244:8123'
    }
    heads = {}
    heads['User-Agent'] = 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/49.0.2623.221 Safari/537.36 SE 2.X MetaSr 1.0'
    req = requests.get(url, headers=heads,proxies=proxy)
    html = req.text
    return html
def get_ipport(html):
    regex = r'<td data-title="IP">(.+)</td>'
    iplist = re.findall(regex, html)
    regex2 = '<td data-title="PORT">(.+)</td>'
    portlist = re.findall(regex2, html)
    regex3 = r'<td data-title="类型">(.+)</td>'
    typelist = re.findall(regex3, html)
    sumray = []
    for i in iplist:
        for p in portlist:
            for t in typelist:
                pass
            pass
        a = t+','+i + ':' + p
        sumray.append(a)
    print('高匿代理')
    print(sumray)
if __name__ == '__main__':
    url = 'http://www.baidu.com'
    get_ipport(get_html(url))
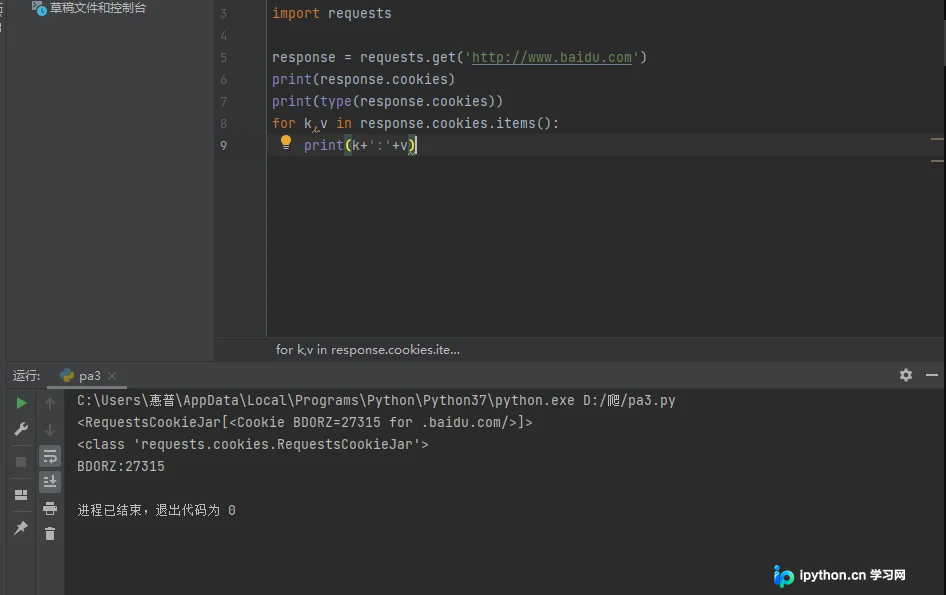
获取并处理服务器返回的Cookie信息:
import requests
response = requests.get('http://www.baidu.com')
print(response.cookies)
print(type(response.cookies))
for k,v in response.cookies.items():
    print(k+':'+v)
利用会话对象维持Cookie状态:
import requests
session = requests.Session()
session.get('https://www.crrcgo.cc/admin/crr_supplier.html')
response = session.get('https://www.crrcgo.cc/admin/')
print(response.text)
配置SSL证书验证选项:
import requests
from requests.packages import urllib3
urllib3.disable_warnings()  #从urllib3中消除警告
response = requests.get('https://www.12306.cn',verify=False)  #证书验证设为FALSE
print(response.status_code)
处理请求超时异常:
import requests
from requests.exceptions import ReadTimeout
try:
    res = requests.get('http://httpbin.org', timeout=0.1)
    print(res.status_code)
except ReadTimeout:
    print(timeout)
全面的异常处理机制:
通过try...except结构捕获并处理可能发生的网络异常。
import requests
from requests.exceptions import ReadTimeout,HTTPError,RequestException
try:
    response = requests.get('http://www.baidu.com',timeout=0.5)
    print(response.status_code)
except ReadTimeout:
    print('timeout')
except HTTPError:
    print('httperror')
except RequestException:
    print('reqerror')
内容总结
本文至此结束,希望能为您的Python爬虫开发提供实用帮助。欢迎持续关注本站,获取更多前沿技术内容!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















