


TensorFlow实现指数衰减学习率的方法

本文介绍TensorFlow中tf.train.exponential_decay函数的用法。该函数通过设置初始学习率、衰减系数和衰减步数,实现学习率的指数级下降。文章详细解析了staircase参数对连续衰减与阶梯状衰减的影响,并展示了global_step作为变量自动更新和作为占位符手动feed的两种典型应用形态,帮助开发者优化模型训练过程。
指数衰减学习率的基本原理
在TensorFlow框架中,利用tf.train.exponential_decay函数可以实现学习率的指数衰减策略。该策略的核心思想是:在训练初期采用较大的学习率以加速收敛,获得一个较为理想的初始解;随着训练迭代的深入,逐步降低学习率,从而确保模型在训练后期能够更稳定地收敛,避免震荡。
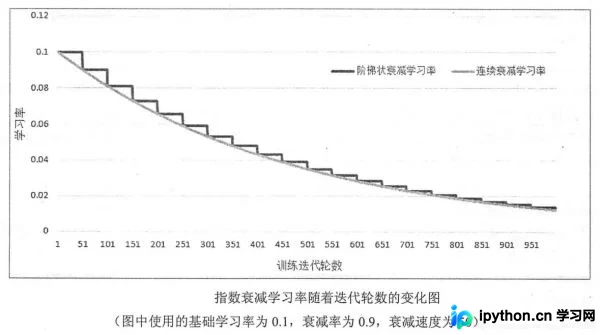
tf.train.exponential_decay函数解析
tf.train.exponential_decay(learning_rate, global_step, decay_steps, decay_rate, staircase, name)函数负责执行学习率的指数级减小操作,其内部逻辑对应于以下数学计算过程:
tf.train.exponential_decay函数允许通过配置staircase参数来切换不同的学习率衰减模式。
当staircase参数设置为False(这也是默认设置)时,系统采用连续衰减模式计算学习率: decayed_learning_rate = learning_rate * math.pow(decay_rate, global_step / decay_steps)
当staircase参数设置为True时,系统采用阶梯状衰减模式计算学习率: decayed_learning_rate = learning_rate * math.pow(decay_rate, global_step // decay_steps)
①decayed_leaming_rate表示每一轮优化迭代时实际使用的学习率;
②leaming_rate表示用户预先设定的初始学习率;
③decay_rate表示衰减系数,用于控制学习率下降的速度;
④global_step表示当前训练的轮数或步数;
⑤decay_steps表示衰减速度,通常定义为完整遍历一遍训练数据所需的迭代轮数。其计算方式为总训练样本数除以每个batch中的样本数。例如,若训练数据集包含128个样本,每个batch包含8个样本,则decay_steps的值应为16。
当staircase参数设为True时,采用阶梯状衰减学习率,意味着每完整遍历一遍训练数据(即经过decay_steps轮训练),学习率就会降低一次。这种机制确保了训练数据集中的所有数据对模型训练的贡献相对均衡。相反,当staircase参数设为False时,采用连续衰减学习率,此时不同阶段的数据对应不同的学习率;随着学习率逐渐减小,后续训练数据对模型最终结果的影响也随之减弱。
指数衰减学习率的两种应用形态
接下来分析tf.train.exponential_decay函数在实际代码中的两种主要应用形态(此处省略部分非核心代码):
①第一种形态是将global_step作为可优化变量。在此模式下,global_step是一个Variable类型的变量。在调用minimize函数时传入global_step参数,TensorFlow会自动更新该变量的值(每轮迭代自动加一),从而驱动学习率随之动态更新:
import tensorflow as tf
 .
 .
 .
#设置学习率
global_step = tf.Variable(tf.constant(0))
learning_rate = tf.train.exponential_decay(0.01, global_step, 16, 0.96, staircase=True)
#定义反向传播算法的优化方法
train_step = tf.train.AdamOptimizer(learning_rate).minimize(cross_entropy, global_step=global_step)
 .
 .
 .
#创建会话
with tf.Session() as sess:
 .
 .
 .
 for i in range(STEPS):
 .
 .
 .
  #通过选取的样本训练神经网络并更新参数
  sess.run(train_step, feed_dict={x:X[start:end], y_:Y[start:end]})
  .
 .
 .
②第二种形态是将global_step作为占位符(Placeholder)并通过feed机制传入。在此模式下,global_step被定义为占位符,在调用sess.run(train_step)时,需要手动传入当前迭代的轮数i进行feed:
import tensorflow as tf
 .
 .
 .
#设置学习率
global_step = tf.placeholder(tf.float32, shape=())
learning_rate = tf.train.exponential_decay(0.01, global_step, 16, 0.96, staircase=True)
#定义反向传播算法的优化方法
train_step = tf.train.AdamOptimizer(learning_rate).minimize(cross_entropy)
 .
 .
 .
#创建会话
with tf.Session() as sess:
 .
 .
 .
 for i in range(STEPS):
 .
 .
 .
  #通过选取的样本训练神经网络并更新参数
  sess.run(train_step, feed_dict={x:X[start:end], y_:Y[start:end], global_step:i})
 .
 .
 .
总结
以上介绍了在TensorFlow中实现指数衰减学习率的具体方法,希望能为读者的模型训练工作提供有益参考。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















