


Kubernetes部署:Pod水平自动伸缩配置

理解 HPA 工作原理与扩缩容条件
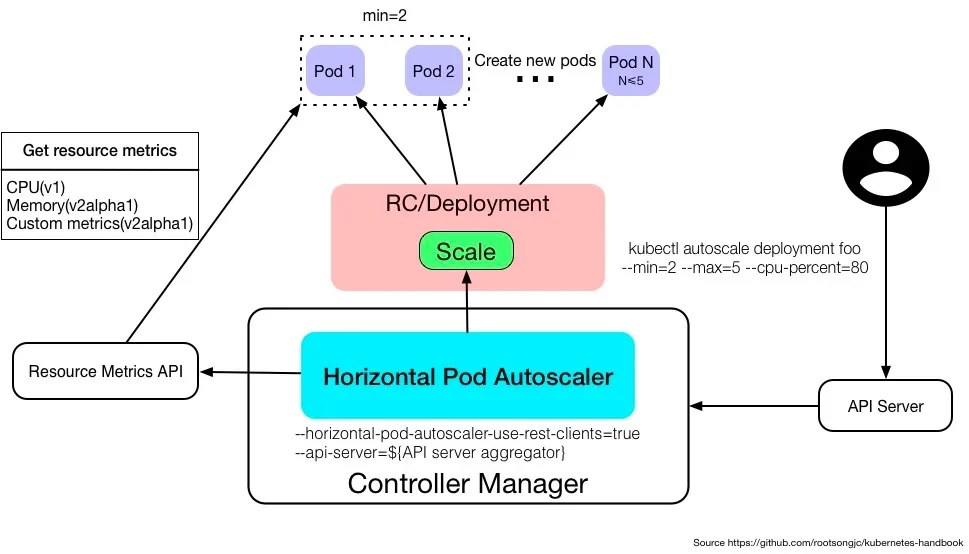
HPA(HorizontalPodAutoscaler)是 Kubernetes 控制平面中的核心控制器,负责根据实时指标动态调整工作负载的副本数量。它与 Deployment 和 Pod 形成紧密的协作链路:Deployment 负责声明期望的 Pod 状态,而 HPA 则持续监控指标并修改 Deployment 的 spec.replicas 字段,进而触发底层 ReplicaSet 创建或销毁 Pod。扩缩容的触发条件严格依赖于 minReplicas 与 maxReplicas 设定的边界,以及目标利用率(如 CPU averageUtilization)。需要特别注意的是,HPA 的计算公式为 目标副本数 = ceil(当前指标总和 / (目标利用率 × 单个 Pod 的 requests 值))。因此,容器必须显式配置 resources.requests.cpu,否则 HPA 无法获取基准值进行除法运算,导致扩缩容逻辑失效。合理设置 requests 与目标阈值,是确保弹性伸缩平稳运行的前提。
准备 Metrics Server 与可用资源指标
在启用基于 CPU 或内存的 HPA 之前,集群必须部署 Metrics Server 以提供 metrics.k8s.io API 数据源。该组件通过 kubelet 的 Summary API 定期采集节点与容器的资源使用情况,并将其聚合为可查询的指标接口。部署完成后,可通过执行 kubectl top nodes 与 kubectl top pods 命令进行快速验证。若终端能正常输出各节点的 CPU 内存使用量及具体 Pod 的实时消耗数据,则表明 Metrics Server 运行正常且 API 聚合层已就绪。若命令返回 error: metrics not available 或 unable to fetch metrics,通常意味着 Metrics Server 未正确安装、缺少 kubelet-insecure-tls 参数(针对非标准证书环境)或集群网络策略阻断了其访问 kubelet 的 10250 端口。确保指标管道畅通是后续 HPA 能够准确感知负载变化的基础。
创建 Deployment 并配置 HPA
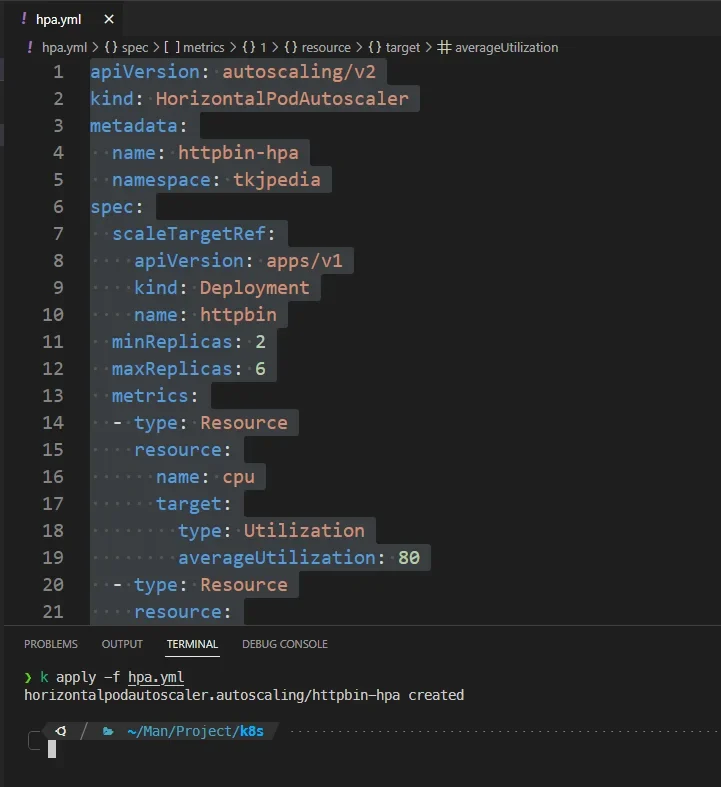
配置 HPA 前,需先定义一个包含明确 CPU 资源请求的 Deployment。在容器 resources 字段中设置 requests.cpu: 250m,为 HPA 提供计算基准。随后,使用 autoscaling/v2 API 版本创建 HorizontalPodAutoscaler 对象。在 YAML 中,scaleTargetRef 需精确指向目标 Deployment 的名称与 API 版本;minReplicas 与 maxReplicas 划定伸缩边界,例如分别设为 2 和 10。核心指标配置位于 metrics 数组中,采用 type: Resource,指定 resource.name: cpu,并在 target 中设置 type: Utilization 与 averageUtilization: 60。该配置表示当所有 Pod 的平均 CPU 使用率超过 requests 值的 60% 时,HPA 将触发扩容。编写完成后,通过 kubectl apply -f hpa.yaml 提交配置,系统即开始周期性(默认 15 秒)拉取指标并评估是否调整副本数。
制造负载并验证自动扩缩容
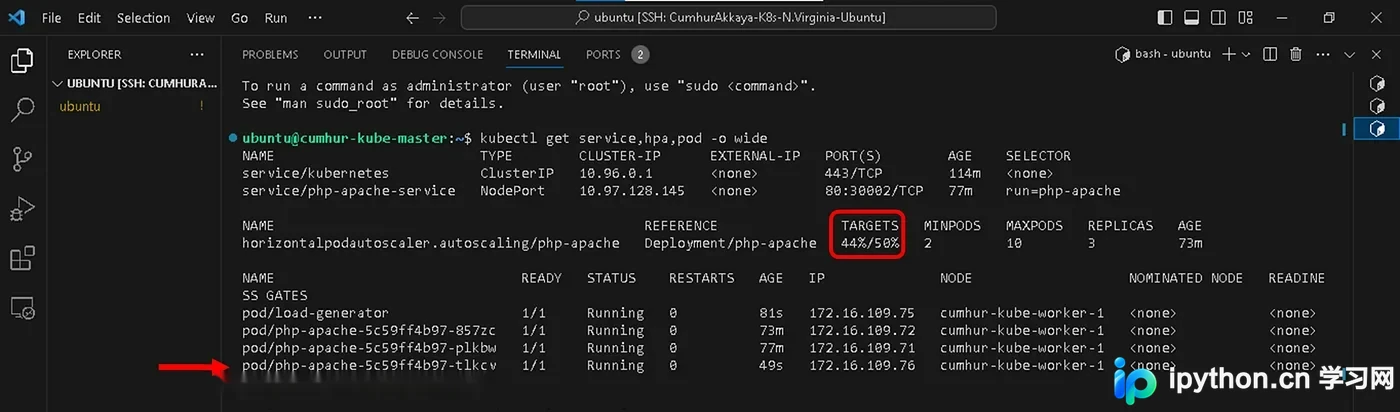
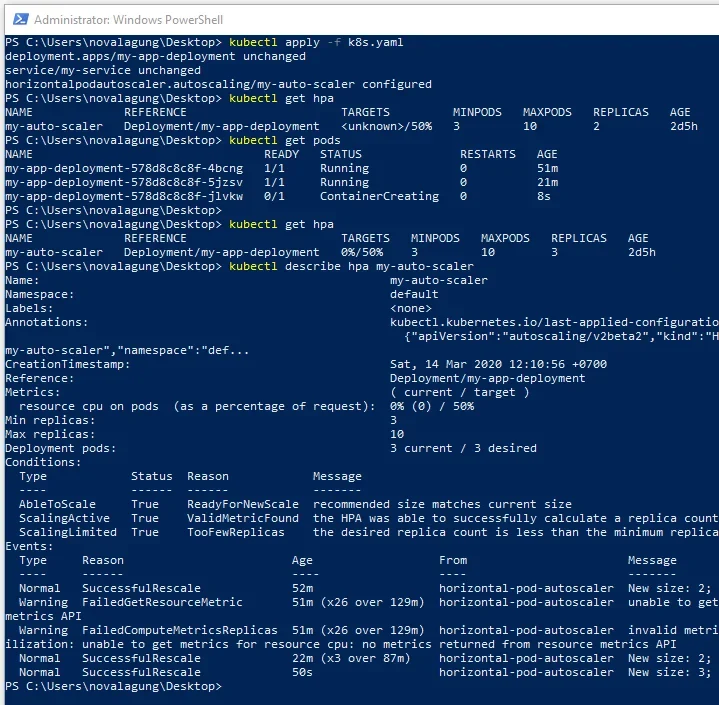
验证 HPA 功能需通过模拟真实流量触发指标阈值。可使用 kubectl run -i --tty load-generator --image=busybox -- /bin/sh 进入调试容器,并执行 while true; do wget -q -O- http://<service-ip>:<port>; done 持续发起请求,或使用 stress 工具直接压测 CPU。负载上升后,执行 kubectl get hpa 观察 TARGETS 列的当前利用率是否突破设定值,REPLICAS 列的 CURRENT/DESIRED 数值将逐步增加。通过 kubectl get pods 可看到新 Pod 进入 ContainerCreating 并最终 Running。停止压测后,HPA 不会立即缩容,而是遵循默认的冷却窗口(通常 5 分钟),待指标回落至阈值下方并稳定后,DESIRED 副本数才会逐步减少至 minReplicas。使用 kubectl describe hpa <name> 可查看 Events 日志,确认 SuccessfulRescale 事件及具体的扩缩容决策时间线。
排查 HPA 不生效与配置避坑
HPA 不生效通常由配置缺失或环境异常引起。首要排查点是 Metrics Server 状态,若 kubectl top 失败,HPA 指标将长期显示 unknown。其次,检查目标容器是否遗漏 resources.requests.cpu,无 requests 则 HPA 无法计算利用率。若 scaleTargetRef 指向的 API 版本或名称拼写错误,控制器将拒绝执行。此外,minReplicas 大于 maxReplicas 会导致校验失败。扩缩容频繁波动(Flapping)多因目标阈值设置过低或业务流量呈锯齿状,可通过调整 behavior.scaleDown.stabilizationWindowSeconds 延长缩容稳定期,或合理提高 averageUtilization 目标值。使用 kubectl describe hpa 查看底部 Events,重点关注 FailedComputeMetricsReplicas 或 FailedGetResourceMetric 警告,结合 kubectl logs -n kube-system deploy/metrics-server 可精准定位底层采集故障。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















