


TensorFlow 图片保存为 TFRecord 及读取详解

本文详细介绍 TensorFlow 中三种数据读取方式,重点讲解如何使用 TFRecord 格式保存和读取图片数据。通过 Slim 库实现高效的数据序列化与反序列化,涵盖从文件路径获取、参数配置到批量读取的完整流程,适用于大规模图像数据集的训练与验证。
TensorFlow 数据读取方法概述
TensorFlow 官方提供了三种主要的数据读取方法:
预加载数据(preloaded data):在 TensorFlow 计算图中定义常量或变量来存储所有数据,这种方法适用于数据量较小的场景。
填充数据(feeding):通过 Python 代码生成数据,然后利用 feed_dict 将数据填充到后端计算图中。
从文件读取数据(reading from file):直接从文件中读取数据,并通过队列管理器进行高效的数据读取。
本文主要介绍第三种方法,即通过 TFRecord 文件来保存和读取数据,同时也会对前两种方式进行简要介绍。
预加载数据与填充数据
一、预加载数据
  a = tf.constant([1,2,3])
  b = tf.constant([4,5,6])
  c = tf.add(a,b)
  with tf.Session() as sess:
    print(sess.run(c))#[5 7 9]
这种方式加载数据相对简单,直接将数据嵌入到数据流图中。然而,当训练数据量较大时,这种方法会消耗大量内存资源。
二、填充数据
通过先定义 placeholder,然后利用 feed_dict 来输入数据。这种方式在 TensorFlow 中应用广泛,但在处理大规模数据时同样存在内存消耗大的问题。接下来,我们将介绍一种更高效的数据读取方式,即通过 TFRecord 文件来读取数据。
  x = tf.placeholder(tf.int16)
  y = tf.placeholder(tf.int16)
  z = tf.add(x,y)
  with tf.Session() as sess:
    print(sess.run(z,feed_dict={x:[1,2,3],y:[4,5,6]}))
    #[5 7 9]
从文件读取数据:TFRecord 保存与读取
三、从文件读取数据
通过 Slim 库实现将图片保存为 TFRecord 文件以及从 TFRecord 文件中读取数据。Slim 是 TensorFlow 的一个更高级别的封装库,使用 Slim 编程可以实现更高效率和更简洁的代码。
本次实验使用的数据集来自 Kaggle 的 Dog vs Cat 竞赛,数据集下载地址为:https://www.kaggle.com/c/dogs-vs-cats/data
1、TFRecord 文件的保存
a、参数设置
dataset_dir_path:训练集图片存放的上级目录(train 目录下还有一个 train 目录用来存放图片)。在 Dog vs Cat 数据集中,dog 和 cat 类的区别是依靠图片的名称。如果你的数据集通过文件夹的名称来划分图片类标,可能需要对代码进行部分修改。
label_name_to_num:字符串类标与数字类标的对应关系。在将图片保存为 TFRecord 文件时,需要将字符串转为整数类标 0 和 1,方便后续的训练。
label_num_to_name:数字类标与字符串类标的对应关系。
val_size:验证集在训练集中所占的比例。训练集一共有 25000 张图片,用 20000 张来训练,5000 张来进行验证。
batch_size:在读取 TFRecord 文件时,每次读取图片的数量。
#数据所在的目录路径
dataset_dir_path = "D:/dataset/kaggle/cat_or_dog/train"
#类标名称和数字的对应关系
label_name_to_num = {"cat":0,"dog":1}
label_num_to_name = {value:key for key,value in label_name_to_num.items()}
#设置验证集占整个数据集的比例
val_size = 0.2
batch_size = 1
b、获取训练集所有的图片路径
获取训练目录下所有的 dog 和 cat 的图片路径,将它们分开保存,便于后面训练集和验证集数据的划分,保证每类图片在所占的比例相同。
 #获取文件所在路径
 dataset_dir = os.path.join(dataset_dir,split_name)
 #遍历目录下的所有图片
 for filename in os.listdir(dataset_dir):
   #获取文件的路径
   file_path = os.path.join(dataset_dir,filename)
   if file_path.endswith("jpg") and os.path.exists(file_path):
     #获取类别的名称
     label_name = filename.split(".")[0]
     if label_name == "cat":
       cat_img_paths.append(file_path)
     elif label_name == "dog":
       dog_img_paths.append(file_path)
 return cat_img_paths,dog_img_paths
c、设置需要保存的图片信息
对于训练集的图片,主要保存图片的字节数据、图片的格式、图片的标签、图片的高和宽。测试集保存为 TFRecord 文件时,需要保存图片的名称,因为在提交数据时需要用到图片的名称信息。在保存图片信息时,需要先将这些信息转换为 byte 数据才能写入到 TFRecord 文件中。
def int64_feature(values):
 if not isinstance(values, (tuple, list)):
  values = [values]
 return tf.train.Feature(int64_list=tf.train.Int64List(value=values))

def bytes_feature(values):
 return tf.train.Feature(bytes_list=tf.train.BytesList(value=[values]))


#将图片信息转换为tfrecords可以保存的序列化信息
def image_to_tfexample(split_name,image_data, image_format, height, width, img_info):
  '''
  :param split_name: train或val或test
  :param image_data: 图片的二进制数据
  :param image_format: 图片的格式
  :param height: 图片的高
  :param width: 图片的宽
  :param img_info: 图片的标签或图片的名称,当split_name为test时,img_info为图片的名称否则为图片标签
  :return:
  '''
  if split_name == "test":
    return tf.train.Example(features=tf.train.Features(feature={
       'image/encoded': bytes_feature(image_data),
       'image/format': bytes_feature(image_format),
       'image/img_name': bytes_feature(img_info),
       'image/height': int64_feature(height),
       'image/width': int64_feature(width),
     }))
  else:
     return tf.train.Example(features=tf.train.Features(feature={
       'image/encoded': bytes_feature(image_data),
       'image/format': bytes_feature(image_format),
       'image/label': int64_feature(img_info),
       'image/height': int64_feature(height),
       'image/width': int64_feature(width),
     }))
d、保存 TFRecord 文件
主要通过 TFRecordWriter 来保存 TFRecord 文件。在将图片信息保存为 TFRecord 文件时,需要先将图片信息序列化为字符串才能进行写入。ImageReader 类可以将图片字节数据解码为指定格式的图片,获取图片的宽和高信息。
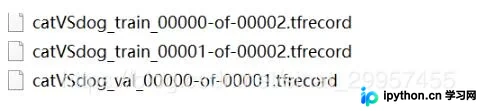
_get_dataset_filename 函数是通过数据集的名称和 split_name 的名称来组合获取 TFRecord 文件的名称,TFRecord 名称如下:
def _convert_tfrecord_dataset(split_name, filenames, label_name_to_id,
dataset_dir, tfrecord_filename, _NUM_SHARDS):
  '''
  :param split_name:train或val或test
  :param filenames:图片的路径列表
  :param label_name_to_id:标签名与数字标签的对应关系
  :param dataset_dir:数据存放的目录
  :param tfrecord_filename:文件保存的前缀名
  :param _NUM_SHARDS:将整个数据集分为几个文件
  :return:
  '''
  assert split_name in ['train', 'val','test']
  #计算平均每一个tfrecords文件保存多少张图片
  num_per_shard = int(math.ceil(len(filenames) / float(_NUM_SHARDS)))
  with tf.Graph().as_default():
    image_reader = ImageReader()
    with tf.Session('') as sess:
      for shard_id in range(_NUM_SHARDS):
        #获取tfrecord文件的名称
        output_filename = _get_dataset_filename(
            dataset_dir, split_name, shard_id,
 tfrecord_filename = tfrecord_filename, _NUM_SHARDS = _NUM_SHARDS)
        #写tfrecords文件
        with tf.python_io.TFRecordWriter(output_filename) as tfrecord_writer:
          start_ndx = shard_id * num_per_shard
          end_ndx = min((shard_id+1) * num_per_shard, len(filenames))
          for i in range(start_ndx, end_ndx):
            #更新控制台中已经完成的图片数量
            sys.stdout.write('\r>> Converting image %d/%d shard %d' % (
              i+1, len(filenames), shard_id))
            sys.stdout.flush()
            #读取图片,将图片数据读取为bytes
            image_data = tf.gfile.FastGFile(filenames[i], 'rb').read()
            #获取图片的高和宽
            height, width = image_reader.read_image_dims(sess, image_data)
            #获取路径中的图片名称
            img_name = os.path.basename(filenames[i])
            if split_name == "test":
              #需要将图片名称转换为二进制
              example = image_to_tfexample(
                split_name,image_data, b'jpg', height, width, img_name.encode())
              tfrecord_writer.write(example.SerializeToString())
            else:
              #获取图片的类别
              class_name = img_name.split(".")[0]
              label_id = label_name_to_id[class_name]
              example = image_to_tfexample(
                split_name,image_data, b'jpg', height, width, label_id)
              tfrecord_writer.write(example.SerializeToString())
        sys.stdout.write('\n')
        sys.stdout.flush()
e、将数据集分为验证集和训练集保存为 TFRecord 文件
先获取数据集中所有图片的路径和图片的标签信息,将不同类别的图片分为训练集和验证集,并保证训练集和验证集中不同类别的图片数量保持相同。在保存为 TFRecord 文件之前,打乱所有图片的路径。将训练集分为了 2 个 TFRecord 文件,验证集保存为 1 个 TFRecord 文件。
#生成tfrecord文件
def generate_tfreocrd():
  #获取目录下所有的猫和狗图片的路径
  cat_img_paths,dog_img_paths = _get_dateset_imgPaths(dataset_dir_path,"train")
  #打乱路径列表的顺序
  np.random.shuffle(cat_img_paths)
  np.random.shuffle(dog_img_paths)
  #计算不同类别验证集所占的图片数量
  cat_val_num = int(len(cat_img_paths) * val_size)
  dog_val_num = int(len(dog_img_paths) * val_size)
  #将所有的图片路径分为训练集和验证集
  train_img_paths = cat_img_paths[cat_val_num:]
  val_img_paths = cat_img_paths[:cat_val_num]
  train_img_paths.extend(dog_img_paths[dog_val_num:])
  val_img_paths.extend(dog_img_paths[:dog_val_num])
  #打乱训练集和验证集的顺序
  np.random.shuffle(train_img_paths)
  np.random.shuffle(val_img_paths)
  #将训练集保存为tfrecord文件
  _convert_tfrecord_dataset("train",train_img_paths,label_name_to_num,dataset_dir_path,"catVSdog",2)
  #将验证集保存为tfrecord文件
  _convert_tfrecord_dataset("val",val_img_paths,label_name_to_num,dataset_dir_path,"catVSdog",1)
通过控制台你可以看到 TFRecord 文件的保存进度。
2、从 TFRecord 文件中读取数据
a、读取 TFRecord 文件,将数据转换为 dataset
通过 TFRecordReader 来读取 TFRecord 文件。在读取 TFRecord 文件时,需要通过 tf.FixedLenFeature 来反序列化存储的图片信息。这里我们只读取图片数据和图片的标签,再通过 Slim 模块将图片数据和标签信息存储为一个 dataset。
 #创建一个tfrecord读文件对象
  reader = tf.TFRecordReader
    keys_to_feature = {
      "image/encoded":tf.FixedLenFeature((),tf.string,default_value=""),
      "image/format":tf.FixedLenFeature((),tf.string,default_value="jpg"),
     "image/label":tf.FixedLenFeature([],tf.int64,default_value=tf.zeros([],tf.int64))
    }
    items_to_handles = {
      "image":slim.tfexample_decoder.Image(),
      "label":slim.tfexample_decoder.Tensor("image/label")
    }
    items_to_descriptions = {
      "image":"a 3-channel RGB image",
      "img_name":"a image label"
    }
    #创建一个tfrecoder解析对象
    decoder = slim.tfexample_decoder.TFExampleDecoder(keys_to_feature,items_to_handles)
    #读取所有的tfrecord文件,创建数据集
    dataset = slim.dataset.Dataset(
      data_sources = tfrecord_paths,
      decoder = decoder,
      reader = reader,
      num_readers = 4,
      num_samples = num_imgs,
      num_classes = num_classes,
      labels_to_name = labels_to_name,
      items_to_descriptions = items_to_descriptions
    )
b、获取 batch 数据
preprocessing_image 对图片进行预处理,对图片进行数据增强,输出后的图片尺寸由 height 和 width 参数决定,固定图片的尺寸方便 CNN 的模型训练。
def load_batch(split_name,dataset,batch_size,height,width):
  data_provider = slim.dataset_data_provider.DatasetDataProvider(
    dataset,
    common_queue_capacity = 24 + 3 * batch_size,
    common_queue_min = 24
  )
    raw_image,img_label = data_provider.get(["image","label"])
    #Perform the correct preprocessing for this image depending if it is training or evaluating
    image = preprocess_image(raw_image, height, width,True)
    #As for the raw images, we just do a simple reshape to batch it up
    raw_image = tf.expand_dims(raw_image, 0)
    raw_image = tf.image.resize_nearest_neighbor(raw_image, [height, width])
    raw_image = tf.squeeze(raw_image)
    #获取一个batch数据
    images,raw_image,labels = tf.train.batch(
      [image,raw_image,img_label],
      batch_size=batch_size,
      num_threads=4,
      capacity=4*batch_size,
      allow_smaller_final_batch=True
    )
    return images,raw_image,labels
c、读取 TFRecord 文件
#读取tfrecord文件
def read_tfrecord():
  #从tfreocrd文件中读取数据
  train_dataset = get_dataset_by_tfrecords("train",dataset_dir_path,"catVSdog",2,label_num_to_name)
  images,raw_images,labels = load_batch("train",train_dataset,batch_size,227,227)
  with tf.Session() as sess:
    threads = tf.train.start_queue_runners(sess)
    for i in range(6):
      train_img,train_label = sess.run([raw_images,labels])
      plt.subplot(2,3,i+1)
      plt.imshow(np.array(train_img[0]))
      plt.title("image label:%s"%str(label_num_to_name[train_label[0]]))
    plt.show()
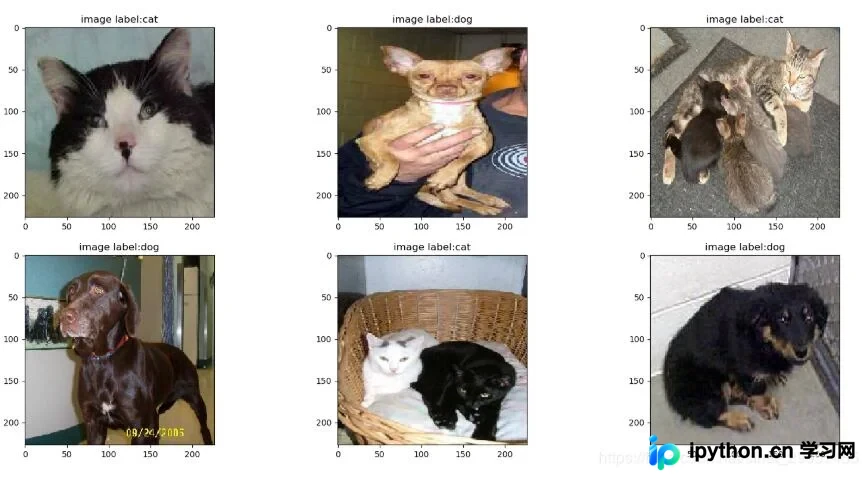
读取训练集的 TFRecord 文件,只从 TFRecord 文件中获取了图片数据和图片的标签。images 表示的是预处理后的图片,raw_images 表示的是没有经过预处理的图片。
以上这篇 TensorFlow 将图片保存为 TFRecord 和 TFRecord 的读取方式就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















