


Python使用xml.dom.minidom解析、写入与更新XML文件详解

本文详细介绍如何利用Python内置的xml.dom.minidom模块对XML文件进行解析、新建写入及节点更新操作。通过具体代码示例,演示如何遍历节点、创建新元素并追加到文档,以及如何定位并修改特定节点的文本值或属性,适用于需要处理XML数据结构的开发场景。
Python XML处理概述
概述
本文档将演示如何使用Python对XML文件进行解析、在现有文件中追加新元素并保存,以及更新XML文件中特定节点的值。主要使用的工具是Python标准库中的xml.dom.minidom模块,相关详细信息可参考其官方文档:xml.dom.minidom官方文档。以下所有操作均基于示例文件customer.xml进行。
<?xml version="1.0" encoding="utf-8" ?>
<!-- This is list of customers -->
<customers>
 <customer ID="C001">
  <name>Acme Inc.</name>
  <phone>12345</phone>
  <comments>
   <![CDATA[Regular customer since 1995]]>
  </comments>
 </customer>
 <customer ID="C002">
  <name>Star Wars Inc.</name>
  <phone>23456</phone>
  <comments>
   <![CDATA[A small but healthy company.]]>
  </comments>
 </customer>
</customers>
CDATA:在XML语法中,CDATA区内的数据不会被XML解析器进行解析处理。
注:本文中的“结点”与“节点”概念等同,读者可根据习惯互换使用,此处未做严格区分。
解析XML文件
1. 解析XML文件
在解析XML文档时,所有文本内容均存储于文本节点中,且该文本节点被视为对应元素节点的子节点。例如,元素<phone>2005</phone>中,“2005”是<phone>元素的子文本节点的值,而非<phone>元素本身的属性值。最常用的获取节点的方法是getElementsByTagName(),获取到节点集合后,可根据文档树结构进一步解析具体数据。
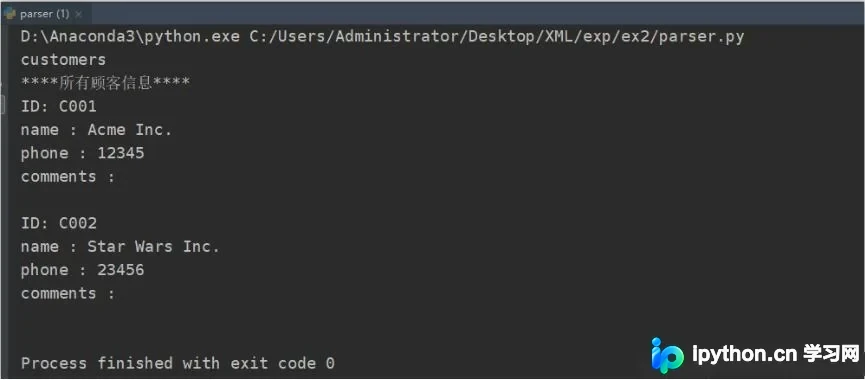
此处省略冗长的理论阐述,结合上述XML文件及下方代码,可以直观地看到具体操作方法。以下代码的功能是遍历并输出所有节点名称及其包含的信息:
# -*- coding: utf-8 -*-
"""
  @Author : LiuZhian
  @Time  : 2019/4/24 0024 上午 9:19
  @Comment :
"""
from xml.dom.minidom import parse
def readXML():
 domTree = parse("./customer.xml")
 # 文档根元素
 rootNode = domTree.documentElement
 print(rootNode.nodeName)

 # 所有顾客
 customers = rootNode.getElementsByTagName("customer")
 print("****所有顾客信息****")
 for customer in customers:
 if customer.hasAttribute("ID"):
  print("ID:", customer.getAttribute("ID"))
  # name 元素
  name = customer.getElementsByTagName("name")[0]
  print(name.nodeName, ":", name.childNodes[0].data)
  # phone 元素
  phone = customer.getElementsByTagName("phone")[0]
  print(phone.nodeName, ":", phone.childNodes[0].data)
  # comments 元素
  comments = customer.getElementsByTagName("comments")[0]
  print(comments.nodeName, ":", comments.childNodes[0].data)

if __name__ == '__main__':
 readXML()
写入XML文件
2. 写入XML文件
在写入XML文件时,通常涉及两种场景:
创建全新的XML文件
在已有的XML文件基础上追加新的元素信息
针对上述两种情况,创建元素节点的方法基本一致:首先必须创建或获取一个DOM对象,然后基于该DOM对象创建新的节点。
对于第一种场景(新建文件),可通过dom=minidom.Document()来实例化DOM对象;对于第二种场景(修改现有文件),可直接通过解析现有XML文件来获取DOM对象,例如:dom = parse("./customer.xml")。
在具体创建元素节点或文本节点时,代码逻辑大致遵循以下“四步法”:
① 使用createElement()创建一个新的元素节点
② 使用createTextNode()创建文本节点
③ 将文本节点追加(appendChild)到元素节点上
④ 将元素节点追加到其父元素节点上。
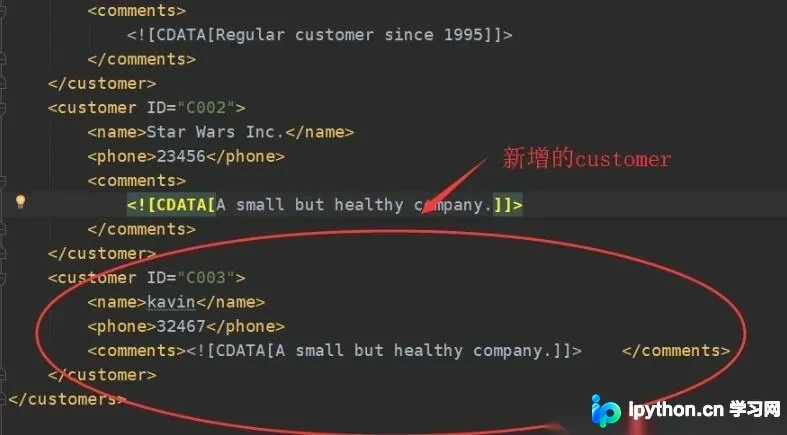
现在,我们需要新建一个customer节点,其具体信息如下:
<customer ID="C003">
  <name>kavin</name>
  <phone>32467</phone>
  <comments>
   <![CDATA[A small but healthy company.]]>
  </comments>
 </customer>
实现代码如下:
def writeXML():
 domTree = parse("./customer.xml")
 # 文档根元素
 rootNode = domTree.documentElement

 # 新建一个customer节点
 customer_node = domTree.createElement("customer")
 customer_node.setAttribute("ID", "C003")

 # 创建name节点,并设置textValue
 name_node = domTree.createElement("name")
 name_text_value = domTree.createTextNode("kavin")
 name_node.appendChild(name_text_value) # 把文本节点挂到name_node节点
 customer_node.appendChild(name_node)

 # 创建phone节点,并设置textValue
 phone_node = domTree.createElement("phone")
 phone_text_value = domTree.createTextNode("32467")
 phone_node.appendChild(phone_text_value) # 把文本节点挂到name_node节点
 customer_node.appendChild(phone_node)

 # 创建comments节点,这里是CDATA
 comments_node = domTree.createElement("comments")
 cdata_text_value = domTree.createCDATASection("A small but healthy company.")
 comments_node.appendChild(cdata_text_value)
 customer_node.appendChild(comments_node)

 rootNode.appendChild(customer_node)

 with open('added_customer.xml', 'w') as f:
 # 缩进 - 换行 - 编码
 domTree.writexml(f, addindent=' ', encoding='utf-8')

if __name__ == '__main__':
 writeXML()
更新XML文件
3. 更新XML文件
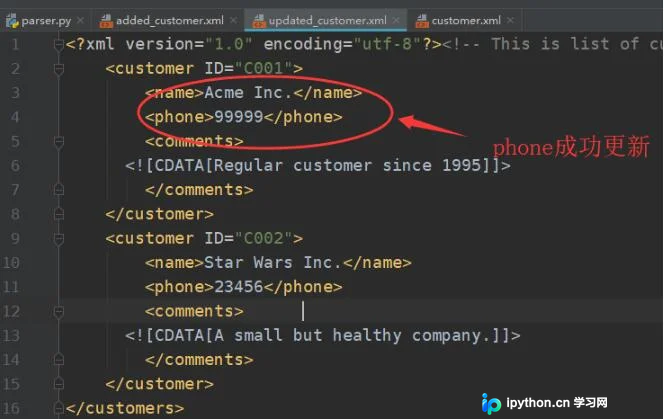
更新XML文件时,核心步骤是先定位到目标元素节点,然后修改其下的文本节点内容或属性值,最后将修改后的DOM树保存回文件。具体思路已在代码中详细注释,如下所示:
def updateXML():
 domTree = parse("./customer.xml")
 # 文档根元素
 rootNode = domTree.documentElement

 names = rootNode.getElementsByTagName("name")
 for name in names:
 if name.childNodes[0].data == "Acme Inc.":
  # 获取到name节点的父节点
  pn = name.parentNode
  # 父节点的phone节点,其实也就是name的兄弟节点
  # 可能有sibNode方法,我没试过,大家可以google一下
  phone = pn.getElementsByTagName("phone")[0]
  # 更新phone的取值
  phone.childNodes[0].data = 99999

 with open('updated_customer.xml', 'w') as f:
 # 缩进 - 换行 - 编码
 domTree.writexml(f, addindent=' ', encoding='utf-8')

if __name__ == '__main__':
 updateXML()
如有疏漏或错误之处,欢迎指正。
补充:ElementTree方式修改XML
补充知识:使用Python读取XML文件内容并完成修改
此处不再赘述,直接参考以下代码实现。
import os
import xml.etree.ElementTree as ET


def changesku(inputpath):
  listdir = os.listdir(inputpath)
  for file in listdir:
    if file.endswith('xml'):
      file = os.path.join(inputpath,file)
      tree = ET.parse(file)
      root = tree.getroot()
      for object1 in root.findall('object'):   #我要修改的元素在object里面,所以需要先找到object
        for sku in object1.findall('name'):  #查找想要修改的所有同种元素
          if (sku.text == '005'):         #‘005'为原始的text
            sku.text = '008'           #修改‘name'的标签值
            tree.write(file,encoding='utf-8')   #写进原始的xml文件,不然修改就无效,‘encoding = “utf - 8”'避免原始xml                                           #中文字符乱码

          else:
            pass
    else:
      pass

if __name__ == '__main__':

  inputpath = 'D:\\easy\\hebing_xml'     #这是xml文件的文件夹的绝对地址
  changesku(inputpath)
以上就是Python解析XML文件(包括解析、更新、写入)的完整内容分享,希望能为读者提供参考,欢迎支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















