


Python模块与包机制详解:导入原理、路径配置及常用标准库实战

本文系统梳理Python模块与包的核心概念,深入解析import与from...import的底层执行差异及路径搜索机制。详细讲解如何动态处理跨目录导入,并对比json、pickle、shelve及hashlib等常用标准库的功能特性与使用场景,帮助开发者掌握模块化管理与数据持久化技巧。
本文详细解析Python中模块相关的关键知识点,旨在为读者提供清晰的参考与实用的操作指南。
Python模块与包的基础定义
1. 模块的基本概念:
模块是Python代码的逻辑组织单元,用于封装变量、函数、类及具体功能逻辑。其本质是一个以.py为后缀的Python源文件,例如文件名为test.py,则对应的模块名即为test。
包(Package)用于在逻辑层级上组织多个模块,其本质是一个包含__init__.py文件的目录(文件夹)。
导入包的操作,实质上是解释并执行该包目录下的__init__.py文件。
若需在某个模块中导入特定包内的内容,应修改该包目录下的__init__.py文件中的导入方式,语法格式为:from . import module_name,其中点号(.)代表当前路径。
模块导入机制与路径搜索
6. 模块导入的具体方法:
Import module_name(模块名)===>>实质导出的是模块名称 name.test()

Import module_name,m1,m2

from module(模块) import * (函数)===>实质是把代码复制到当前位置(不建议 )

from module import module_name,m1,m2

from module import module_name  as modele_name_from_wfb (as取别名)
7. import语句的本质(涉及路径搜索机制):
(1)使用import module_name语句,会将导入模块的全部代码统一解释执行,并将结果赋值给module_name变量,例如:module_name等于“module_name.py的所有代码”。可通过module_name.name访问。
执行流程为:Import module_name → 执行module_name.py → 查找module_name.py的路径 → 依据sys.path列表。
(2)使用from module import module_name语句,会将module模块中的module_name部分提取出来,在当前文件中单独执行一遍。例如直接调用name()。
总结而言,导入模块的本质就是将Python文件解释执行一遍。
跨目录文件与包的导入配置
2. 导入不同目录下的文件或包:
由于导入模块或包的实质是在系统环境变量(路径)中查找目标文件,若文件存在则执行成功,否则需将文件或包的绝对路径动态添加到系统环境变量中。此过程通常结合sys和os模块使用。
Import sys,os
lujin=os.path.dirname(os.path.abspath(__file__))


Sys.path.append(lujin)
主要目的是:在当前文件中获取指定文件或包的父级目录路径。
具体解释如下:
使用os.path.abspath(__file__)可获取当前文件的绝对路径。
使用os.path.dirname可获取当前文件所在的父级目录。
通过Sys.path.append(lujin)将获取到的路径追加到系统环境变量列表中。
导入方式的性能优化对比
3. 导入方式的优化建议:
(1) 使用Import module_name
调用方式为module_name.name()。
其机制是先查找模块,再查找模块下的方法。这种双重查找过程效率相对较低。
(2) 使用from module_name import name
调用方式简化为name()。
其机制是将模块中的方法直接提取到指定位置执行。相比import语句,这种方式减少了多次查找的过程,效率更高。
Python标准库常用模块解析
4. 模块的分类:
a. 标准库(内置库)
1. time和datetime模块。
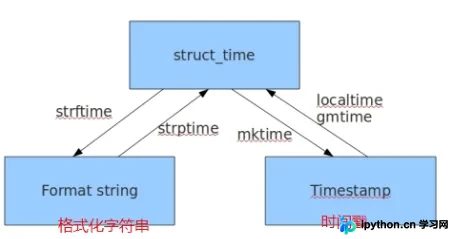
gmtime():用于获取标准时间(0时区)。
localtime():用于获取本地时间(东八区)。
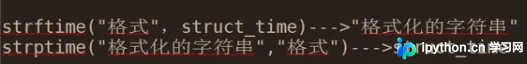
示例代码:time.strftime("%Y-%m-%d %H:%M:%S",time.gmtime()),其中%Y对应tm_year,%m对应tm.mon。
数据序列化与持久化工具
5. json和pickle模块:
Json模块提供了四个核心功能:dumps、dump、loads、load。
pickle模块同样提供了四个核心功能:dumps、dump、loads、load。
建议仅对json和pickle模块使用dumps和loads进行单次操作,若需多次存取,需严格遵循之前的顺序,否则处理较为繁琐。dumps将对象序列化为字符串。
6. shelve模块:
shelve模块是一个简单的键值对(k,v)存储工具,可将内存数据通过文件持久化。它支持任何pickle可处理的Python数据格式,可理解为实现了多次dumps和loads的功能。
使用方法如下:
import shelve

d = shelve.open('shelve_test') #打开一个文件
存储操作:d["key"]=value
读取操作:d.get("key")
信息加密与哈希处理
7. 加密模块:
hashlib模块。
针对中/英文信息的加密处理:
import hashlib

m=hashlib.md5()

m.update(b"Hello")

m.update("It's me 你好".encode(encoding='utf-8'))
对信息进行加密时:
import hmac

m=hmac.new(b'天王盖地虎', '宝塔镇河妖'.encode(encoding='utf-8')
b'天王盖地虎':必须为bytes类型。
'宝塔镇河妖'.encode(encoding='utf-8'):对包含中文的字符串需进行编码(encode)转换为二进制数据,主要区别在于是否带有b前缀。
更多关于Python相关内容感兴趣的读者可查看本站专题:《Python文件与目录操作技巧汇总》、《Python文本文件操作技巧汇总》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》及《Python入门与进阶经典教程》。
希望本文所述的知识点对大家学习Python程序设计有所帮助。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















