


Python解析VOC格式XML提取目标框坐标及批量处理示例

发布时间:2026-10-13 |
5人浏览过
本文介绍如何使用Python解析PASCAL VOC格式的XML标注文件,提取图像中目标物体的边界框坐标。通过示例代码展示如何还原标注结果并可视化显示,同时提供批量修改XML文件夹名称及按类别裁剪特定目标图片的方法,帮助开发者验证数据集质量并预处理图像数据。
Python解析VOC XML提取目标框坐标
实现代码:
#!/usr/bin/python
# -*- coding: UTF-8 -*-
# get annotation object bndbox location
import os
import cv2
try:
  import xml.etree.cElementTree as ET #解析xml的c语言版的模块
except ImportError:
  import xml.etree.ElementTree as ET

##get object annotation bndbox loc start
def GetAnnotBoxLoc(AnotPath):#AnotPath VOC标注文件路径
  tree = ET.ElementTree(file=AnotPath) #打开文件,解析成一棵树型结构
  root = tree.getroot()#获取树型结构的根
  ObjectSet=root.findall('object')#找到文件中所有含有object关键字的地方,这些地方含有标注目标
  ObjBndBoxSet={} #以目标类别为关键字,目标框为值组成的字典结构
  for Object in ObjectSet:
    ObjName=Object.find('name').text
    BndBox=Object.find('bndbox')
    x1 = int(BndBox.find('xmin').text)#-1 #-1是因为程序是按0作为起始位置的
    y1 = int(BndBox.find('ymin').text)#-1
    x2 = int(BndBox.find('xmax').text)#-1
    y2 = int(BndBox.find('ymax').text)#-1
    BndBoxLoc=[x1,y1,x2,y2]
    if ObjName in ObjBndBoxSet:
    	ObjBndBoxSet[ObjName].append(BndBoxLoc)#如果字典结构中含有这个类别了,那么这个目标框要追加到其值的末尾
    else:
    	ObjBndBoxSet[ObjName]=[BndBoxLoc]#如果字典结构中没有这个类别,那么这个目标框就直接赋值给其值吧
  return ObjBndBoxSet
##get object annotation bndbox loc end

def display(objBox,pic):
  img = cv2.imread(pic)

  for key in objBox.keys():
    for i in range(len(objBox[key])):
      cv2.rectangle(img, (objBox[key][i][0],objBox[key][i][1]), (objBox[key][i][2], objBox[key][i][3]), (0, 0, 255), 2)
      cv2.putText(img, key, (objBox[key][i][0],objBox[key][i][1]), cv2.FONT_HERSHEY_COMPLEX, 1, (255,0,0), 1)
  cv2.imshow('img',img)
  cv2.imwrite('display.jpg',img)
  cv2.waitKey(0)


if __name__== '__main__':
  pic = r"./VOCdevkit/VOC2007/JPEGImages/000282.jpg"
  ObjBndBoxSet=GetAnnotBoxLoc(r"./VOCdevkit/VOC2007/Annotations/000282.xml")
  print(ObjBndBoxSet)
  display(ObjBndBoxSet,pic)
运行输出结果:
{'chair': [[335, 263, 484, 373]], 'person': [[327, 104, 476, 300], [232, 57, 357, 374], [3, 32, 199, 374], [58, 139, 296, 374]]}
可视化图示:
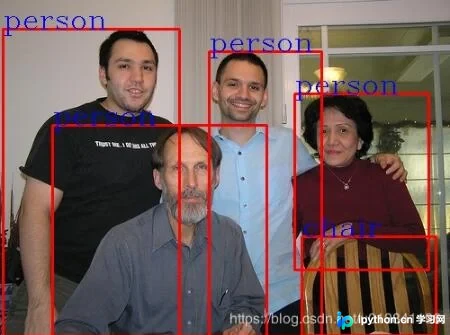
补充说明:利用Python脚本解析VOC类型的XML标注文件,实现目标区域的还原显示,并支持批量裁剪指定类别的目标图像。
在使用LabelImg等标注工具对图片进行VOC格式标注后,会生成对应的XML文件。为了评估数据集标注质量,可以通过以下代码将标注信息还原到图像上进行查看。
批量还原标注与可视化显示
import xml.etree.cElementTree as ET
import cv2
import os
import glob

def GetAnnotBoxLoc(AnotPath):
  tree = ET.ElementTree(file=AnotPath)
  root = tree.getroot()
  ObjectSet=root.findall('object')
  ObjBndBoxSet={}
  for Object in ObjectSet:
    ObjName=Object.find('name').text
    BndBox=Object.find('bndbox')
    x1 = int(BndBox.find('xmin').text)
    y1 = int(BndBox.find('ymin').text)
    x2 = int(BndBox.find('xmax').text)
    y2 = int(BndBox.find('ymax').text)
    BndBoxLoc=[x1,y1,x2,y2]
    if ObjName in ObjBndBoxSet:
    	ObjBndBoxSet[ObjName].append(BndBoxLoc)
    else:
    	ObjBndBoxSet[ObjName]=[BndBoxLoc]
  return ObjBndBoxSet

def GetAnnotName(AnotPath):
  tree = ET.ElementTree(file=AnotPath)
  root = tree.getroot()
  path=root.find('path').text
  return path

def Drawpic(xml_path,result_path):
  n = 0
  xmls = glob.glob(os.path.join(xml_path, '*.xml'))
  for xml in xmls:
    n = n + 1
    box=GetAnnotBoxLoc(xml)
    path=GetAnnotName(xml)
    img = cv2.imread(path)
    for classes in list(box.keys()):
      for boxes in box[classes]:
        if classes == "bad1":
          cv2.rectangle(img,(int(boxes[0]),int(boxes[1])),(int(boxes[2]),int(boxes[3])),(255,0,0),3) #blue
        if classes == "bad2":
          cv2.rectangle(img,(int(boxes[0]),int(boxes[1])),(int(boxes[2]),int(boxes[3])),(0,255,0),3) #green
        if classes == "bad3":
          cv2.rectangle(img,(int(boxes[0]),int(boxes[1])),(int(boxes[2]),int(boxes[3])),(0,0,255),3) #red
    cv2.imwrite(result_path+"/"+str(n)+"_result.jpg", img)
    print(path,"还原成功")

Drawpic("/home/wxy/Dashboard/dataset/VOCdevkit/VOC2012/Annotations","/home/wxy/Dashboard/dataset/VOCdevkit/VOC2012/test")
使用LabelImg进行图像标注时,需注意修改XML文件中的folder目录字段。
批量修改XML文件夹名称
import xml.etree.ElementTree as ET
import os

for i in os.listdir('/home/wxy/Dashboard/dataset/VOCdevkit/VOC2012/Annotations'):
  tree = ET.parse('/home/wxy/Dashboard/dataset/VOCdevkit/VOC2012/Annotations'+'/'+i)
  root = tree.getroot()
  print(root.find('folder').text)
  root.find('folder').text = 'VOC2012'
  print(root.find('folder').text)
  tree.write('/home/wxy/Dashboard/dataset/VOCdevkit/VOC2012/Annotations'+'/'+i)
关于批量裁剪特定类别的目标,有观点认为xml.dom.minidom模块在处理此类任务时比xml.etree.cElementTree更为便捷。
按类别批量裁剪目标图像
#coding=utf-8
import xml.dom.minidom
import cv2
import os

for name in os.listdir("./Annotations/"):
  dom=xml.dom.minidom.parse("./Annotations/"+name)
  root=dom.documentElement
  object_name=root.getElementsByTagName('name')
  if(object_name[0].firstChild.data == "normal"):
    print(name)
    xmin=root.getElementsByTagName('xmin')
    ymin=root.getElementsByTagName('ymin')
    xmax=root.getElementsByTagName('xmax')
    ymax=root.getElementsByTagName('ymax')

    x_min = int(xmin[0].firstChild.data)
    y_min = int(ymin[0].firstChild.data)
    x_max = int(xmax[0].firstChild.data)
    y_max = int(ymax[0].firstChild.data)

    img=cv2.imread("./JPEGImages/"+name[:-4]+".jpg")
    cropped=img[y_min:y_max,x_min:x_max]
    cv2.imwrite("./cut_jpg/"+name[:-4]+".jpg", cropped)
以上即为Python读取VOC中XML目标框的完整示例,希望能为相关开发者提供参考,欢迎继续支持本站获取更多技术内容。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















