


Python解析PASCAL VOC XML提取bndbox坐标并裁剪保存图像

发布时间:2026-10-13 |
4人浏览过
本文介绍利用Python解析PASCAL VOC格式XML文件,提取bndbox边界框坐标,并从JPEGImages中截取对应区域图像另存为JPG文件的完整流程。通过xml.dom.minidom获取xmin、ymin、xmax、ymax数值,结合OpenCV进行图像裁剪与保存,并提供封装函数及注意事项。
文件目录结构说明
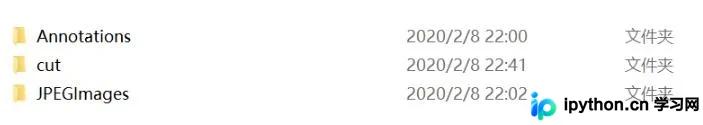
文件目录
Annotations文件夹内存放XML标注文件。
JPEGImages文件夹内存放对应的原始JPG图像文件。
XML文件格式与提取目标
XML文件格式示例
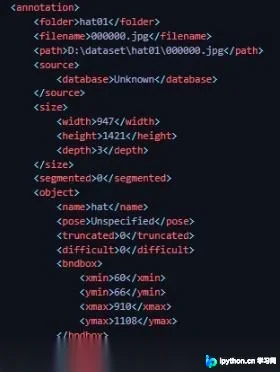
目标是从XML文件中提取bndbox定义的坐标区域。
Python裁剪图像实现代码
Python实现代码
# -*- coding: utf-8 -*-
# @Time  : 2020/2/8 22:14
# @Author : SanZhi
# @File  : get_xml.py
# @Software: PyCharm
import cv2
import numpy as np

import xml.dom.minidom
import os
import argparse

def main():
  # JPG文件的地址
  img_path = 'D:/ser/JPEGImages/'
  # XML文件的地址
  anno_path = 'D:/ser/Annotations/'
  # 存结果的文件夹
  cut_path = 'D:/ser/cut/'
  # 获取文件夹中的文件
  imagelist = os.listdir(img_path)

  for image in imagelist:
    image_pre, ext = os.path.splitext(image)
    img_file = img_path + image
    img = cv2.imread(img_file)
    xml_file = anno_path + image_pre + '.xml'
    DOMTree = xml.dom.minidom.parse(xml_file)
    collection = DOMTree.documentElement
    objects = collection.getElementsByTagName("object")

    for object in objects:
      print("start")
      bndbox = object.getElementsByTagName('bndbox')[0]
      xmin = bndbox.getElementsByTagName('xmin')[0]
      xmin_data = xmin.childNodes[0].data
      ymin = bndbox.getElementsByTagName('ymin')[0]
      ymin_data = ymin.childNodes[0].data
      xmax = bndbox.getElementsByTagName('xmax')[0]
      xmax_data = xmax.childNodes[0].data
      ymax = bndbox.getElementsByTagName('ymax')[0]
      ymax_data = ymax.childNodes[0].data
      xmin = int(xmin_data)
      xmax = int(xmax_data)
      ymin = int(ymin_data)
      ymax = int(ymax_data)
      img_cut = img[ymin:ymax, xmin:xmax, :]
      cv2.imwrite(cut_path + 'cut_img_{}.jpg'.format(image_pre), img_cut)


if __name__ == '__main__':
  main()
读取bndbox与object name的封装方法
补充知识:Python读取XML中bndbox和object name的方法
直接提供封装好的函数代码,调用即可使用。注意以下几个关键点。
第一,bndbox节点下包含4个子对象,因此不能直接用firstChild获取内容,需在该对象内继续查找标签为xmin等的子对象,且必须加上[0]索引才能正确获取,如有问题可调试查看变量结构后按结构调用。
第二,将空格' '替换为'_'以方便文件命名。注意str.replace(' ', '_')不会直接修改原字符串,而是返回新字符串,因此需要用变量接收返回值。
import xml.dom.minidom as xmldom
def get_bndboxfromxml(imageNum, xmlfilebasepath):
  # 读取xml文件
  bndbox = [0, 0, 0, 0]
  xmlfilepath = xmlfilebasepath + "\%06d" % imageNum+'.xml'
  # print(xmlfilepath)
  domobj = xmldom.parse(xmlfilepath)
  elementobj = domobj.documentElement
  sub_element_obj = elementobj.getElementsByTagName('bndbox')
  if sub_element_obj is not None:
    bndbox[0] = int(sub_element_obj[0].getElementsByTagName('xmin')[0].firstChild.data)
    bndbox[1] = int(sub_element_obj[0].getElementsByTagName('ymin')[0].firstChild.data)
    bndbox[2] = int(sub_element_obj[0].getElementsByTagName('xmax')[0].firstChild.data)
    bndbox[3] = int(sub_element_obj[0].getElementsByTagName('ymax')[0].firstChild.data)
  return bndbox


def get_bndboxnamefromxml(imageNum, xmlfilebasepath):
  bndbox = [0, 0, 0, 0]
  xmlfilepath = xmlfilebasepath + "\%06d" % imageNum + '.xml'
  domobj = xmldom.parse(xmlfilepath)
  elementobj = domobj.documentElement
  sub_element_obj = elementobj.getElementsByTagName('name')
  name = sub_element_obj[0].firstChild.data.replace(' ', '_')

  return name
以上关于Python截取XML中bndbox坐标图像并另存为JPG的实例内容分享完毕,希望提供参考,感谢支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















