


详解用Python进行时间序列预测的7种方法

本文深入解析使用Python进行时间序列预测的7种核心方法,涵盖从简单的朴素法、移动平均到复杂的Holt-Winters及ARIMA模型。通过JetRail高铁乘客数据案例,逐步演示数据预处理、模型构建与参数调优过程,帮助开发者掌握不同场景下的最佳预测策略。
数据准备与预处理
数据准备
首先获取JetRail高铁的乘客数量数据集。
设定一个具体的时序预测任务:利用2012年8月至2014年8月共两年的历史数据,预测接下来7个月的乘客流量。
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt

df = pd.read_csv('train.csv')
df.head()
df.shape
基于上述代码,我们提取了2012年至2014年间每小时的乘客记录。为了清晰展示各预测方法的差异,我们将数据按天进行聚合处理。
- 选取2012年8月至2013年12月的数据构建基础数据集。
- 划分训练集与测试集以支持建模。前14个月(2012年8月至2013年10月)的数据作为训练集,剩余两个月(2013年11月至2013年12月)的数据作为测试集。
- 将数据集按天维度进行聚合处理。
import pandas as pd
import matplotlib.pyplot as plt

# Subsetting the dataset
# Index 11856 marks the end of year 2013
df = pd.read_csv('train.csv', nrows=11856)

# Creating train and test set
# Index 10392 marks the end of October 2013
train = df[0:10392]
test = df[10392:]

# Aggregating the dataset at daily level
df['Timestamp'] = pd.to_datetime(df['Datetime'], format='%d-%m-%Y %H:%M') # 4位年用Y,2位年用y
df.index = df['Timestamp']
df = df.resample('D').mean() #按天采样,计算均值

train['Timestamp'] = pd.to_datetime(train['Datetime'], format='%d-%m-%Y %H:%M')
train.index = train['Timestamp']
train = train.resample('D').mean() #

test['Timestamp'] = pd.to_datetime(test['Datetime'], format='%d-%m-%Y %H:%M')
test.index = test['Timestamp']
test = test.resample('D').mean()

#Plotting data
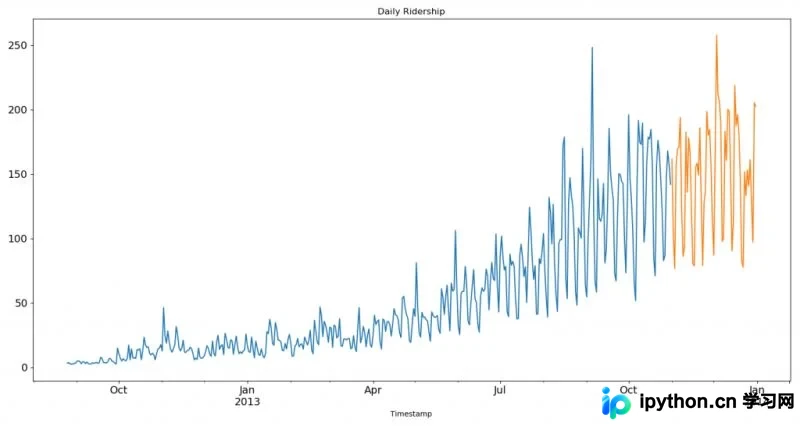
train.Count.plot(figsize=(15,8), title= 'Daily Ridership', fontsize=14)
test.Count.plot(figsize=(15,8), title= 'Daily Ridership', fontsize=14)
plt.show()
对数据进行可视化展示(包含训练集和测试集),以直观观察数据随时间的变化趋势。
基础预测方法:朴素法与简单平均
方法1:朴素法
假设y轴代表商品价格,x轴代表时间(天)。
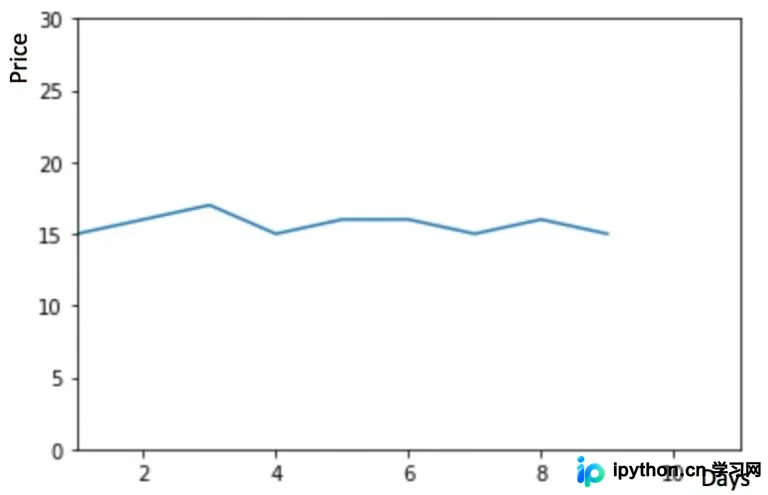
若数据集在一段时间内保持平稳,且目标是预测次日价格,可直接取前一日的价格作为第二天的预测值。这种假设下一个预测点等于上一个观测值的预测方法称为朴素法,公式表示为 $\hat{y_{t+1}} = y_t$。
dd = np.asarray(train['Count'])
y_hat = test.copy()
y_hat['naive'] = dd[len(dd) - 1]
plt.figure(figsize=(12, 8))
plt.plot(train.index, train['Count'], label='Train')
plt.plot(test.index, test['Count'], label='Test')
plt.plot(y_hat.index, y_hat['naive'], label='Naive Forecast')
plt.legend(loc='best')
plt.title("Naive Forecast")
plt.show()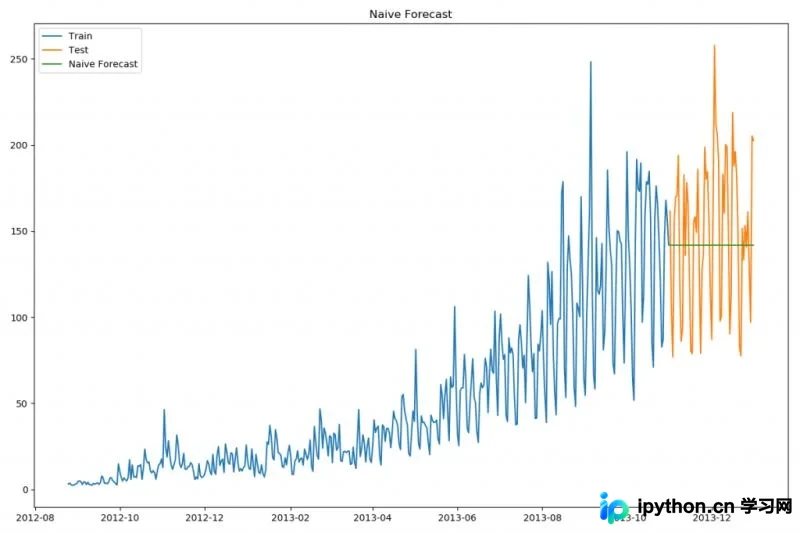
朴素法并不适用于波动剧烈的数据集,它最适合稳定性极高的场景。我们计算均方根误差(RMSE)以评估模型在测试集上的准确率:
from sklearn.metrics import mean_squared_error
from math import sqrt

rms = sqrt(mean_squared_error(test['Count'], y_hat['naive']))
print(rms)
最终计算得到的均方根误差(RMS)为:43.91640614391676。
方法2:简单平均法
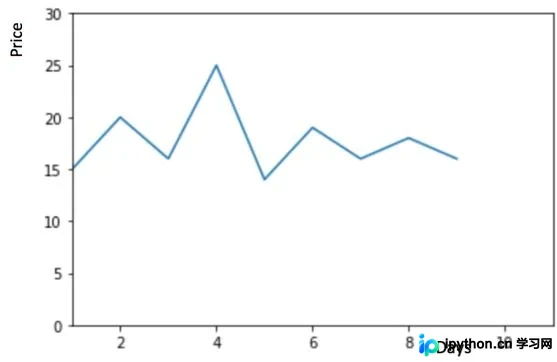
商品价格可能随机涨跌,但长期平均价格保持稳定。许多数据集虽在一定时期内有小幅波动,但各时间段的平均值恒定。此时,可预测次日价格等于过去所有天数的平均价格。这种将预期值等同于之前所有观测点平均值的预测方法称为简单平均法,即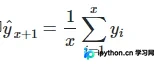 。
y_hat_avg = test.copy()
y_hat_avg['avg_forecast'] = train['Count'].mean()
plt.figure(figsize=(12,8))
plt.plot(train['Count'], label='Train')
plt.plot(test['Count'], label='Test')
plt.plot(y_hat_avg['avg_forecast'], label='Average Forecast')
plt.legend(loc='best')
plt.show()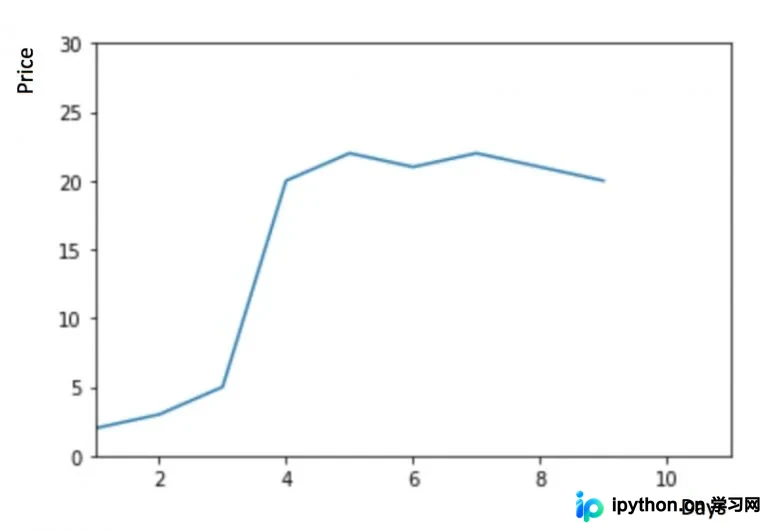
移动平均与加权移动平均
若商品价格经历大幅上涨后趋于平稳,这类数据集(如销售额或价格在某阶段剧烈升降)在使用简单平均法时会遇到问题。因为使用所有历史数据的平均值会受到早期价格值的显著影响,导致后续日期的预测失真。因此,仅取最近几个时期的价格平均值更为合理,其逻辑在于近期值更具参考价值。这种基于特定窗口期计算平均值的预测方法称为移动平均法。
计算移动平均值涉及一个称为“滑动窗口”的大小参数p。使用简单移动平均模型,可根据之前固定数量p的数值的平均值来预测时序中的下一个值。因此,对于所有 i > p:
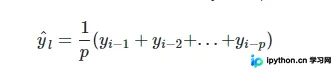
在上述移动平均法中,我们对窗口“p”内的观测值赋予了相同的权重。然而,有时不同观测值对预测结果的影响程度不同。将不同权重分配给过去观测值的方法称为加权移动平均法。这本质上仍属移动平均法,区别在于“滑动窗口”内的值被赋予了不同的权重,通常近期时间点的数据具有更大的影响力。公式为:
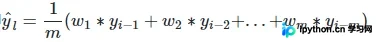
该方法并非选择一个固定窗口期的值,而是需要指定一列权重值(权重之和为1)。例如,若选择[0.40, 0.25, 0.20, 0.15]作为权重,则最近4个时间点分别被赋予40%、25%、20%和15%的权重。
简单指数平滑法
方法4:简单指数法
观察简单平均法和加权移动平均法在选取时间点上的思路差异,我们需要一种折中方案:既考虑所有数据,又赋予不同权重。例如,相较于早期观测值,该方法给予近期观测值更大的权重。遵循此原则的方法称为简单指数平滑法。它通过加权平均值计算预测值,其中权重随观测值从早期到晚期呈指数级下降,最小权重与最早观测值相关:
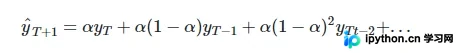
其中0≤α≤1为平滑参数。对时间点T+1的单步预测值是时序$y_1,…,y_T$所有观测值的加权平均数。权重下降速率由参数α控制,预测值$\hat{y}_x$是$\alpha \cdot y_t $与$(1-\alpha) \cdot \hat{y}_x$的和。
因此,公式可写为:
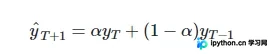
本质上,这是利用两个权重α和1−α计算加权移动平均值,并使表达式呈现递进形式。
from statsmodels.tsa.api import SimpleExpSmoothing

y_hat_avg = test.copy()
fit = SimpleExpSmoothing(np.asarray(train['Count'])).fit(smoothing_level=0.6, optimized=False)
y_hat_avg['SES'] = fit.forecast(len(test))
plt.figure(figsize=(16, 8))
plt.plot(train['Count'], label='Train')
plt.plot(test['Count'], label='Test')
plt.plot(y_hat_avg['SES'], label='SES')
plt.legend(loc='best')
plt.show()
模型中使用的α值为0.6,可通过测试集继续调整参数以生成更优模型。
霍尔特线性趋势法
方法5:霍尔特(Holt)线性趋势法
假设y轴表示某商品价格,x轴表示时间(天)。
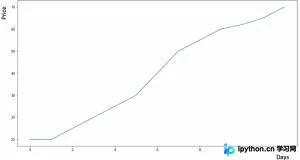
若商品价格持续上涨(见上图),前述方法未考虑这种趋势,即一段时间内观察到的价格总体模式。
任何时序数据集均可分解为几个部分:趋势(Trend)、季节性(Seasonal)和残差(Residual)。任何呈现特定趋势的数据集均可使用霍尔特线性趋势法进行预测。
import statsmodels.api as sm

sm.tsa.seasonal_decompose(train['Count']).plot()
result = sm.tsa.stattools.adfuller(train['Count'])
plt.show()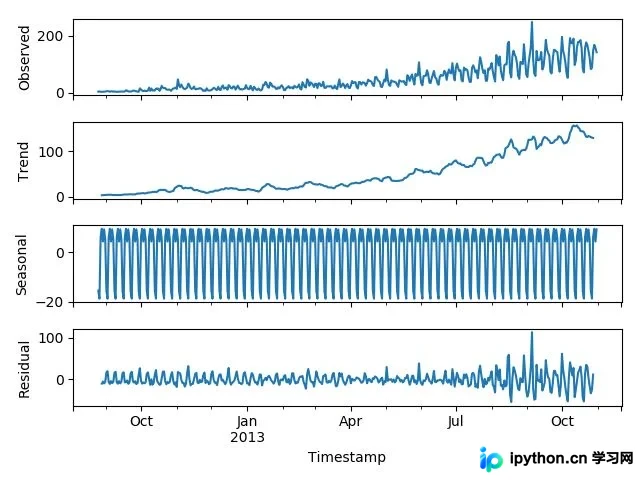
从图中可见,该数据集呈上升趋势,因此可使用霍尔特线性趋势法预测未来价格。该算法包含三个方程:一个水平方程,一个趋势方程,以及将二者相加得到预测值$\hat{y}$的方程:
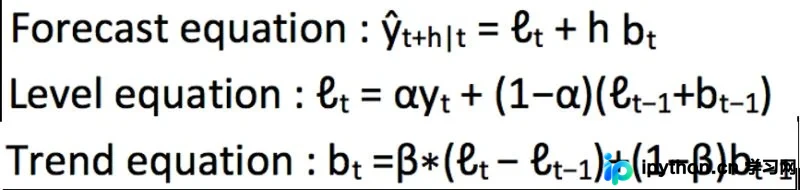
上述算法中预测的值称为水平(level)。与简单指数平滑类似,水平方程显示其为观测值和样本内单步预测值的加权平均数;趋势方程显示其是根据 ℓ(t)−ℓ(t−1) 和之前的预测趋势 b(t−1) 在时间t处的预测趋势的加权平均值。
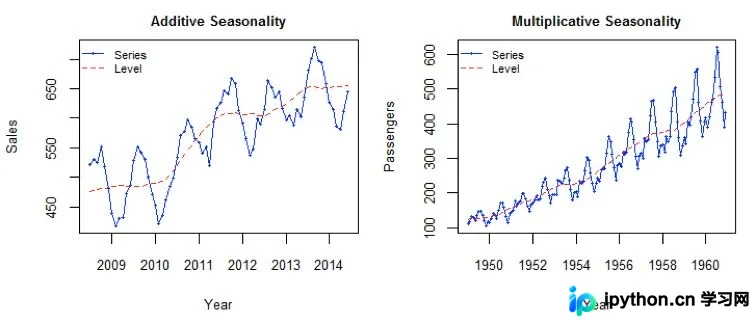
将这两个方程相加,得出一个预测函数。也可将两者相乘得到乘法预测方程。当趋势呈线性增加或下降时,使用相加方程;当趋势呈指数级增加或下降时,使用相乘方程。实践表明,相乘方程预测结果更稳定,但相加方程更易于理解。
from statsmodels.tsa.api import Holt

y_hat_avg = test.copy()

fit = Holt(np.asarray(train['Count'])).fit(smoothing_level=0.3, smoothing_slope=0.1)
y_hat_avg['Holt_linear'] = fit.forecast(len(test))

plt.figure(figsize=(16, 8))
plt.plot(train['Count'], label='Train')
plt.plot(test['Count'], label='Test')
plt.plot(y_hat_avg['Holt_linear'], label='Holt_linear')
plt.legend(loc='best')
plt.show()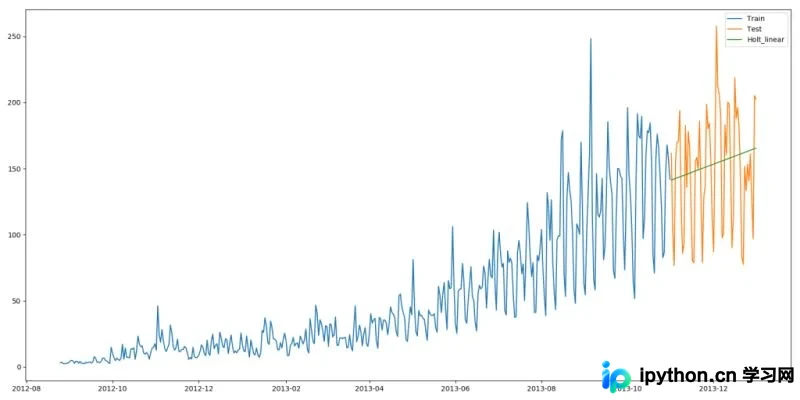
该方法能准确显示趋势,因此比前几种模型效果更好。若调整参数,结果会进一步优化。
Holt-Winters季节性预测模型
方法6:Holt-Winters季节性预测模型
应用此算法前,先介绍一个新术语。假设一家酒店位于半山腰,夏季生意兴隆、顾客众多,而其余时间顾客稀少。因此,每年夏季收入远高于其他季节,且每年如此,这种重复现象称为“季节性”(Seasonality)。若数据集在固定时间段内呈现相似模式,则该数据集具有季节性。
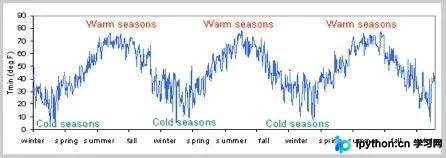
此前讨论的5种模型在预测时未考虑数据集的季节性,因此需要一种能纳入该因素的方法。适用于此情况的算法称为Holt-Winters季节性预测模型,它是一种三次指数平滑预测,其核心理念是将指数平滑应用于季节分量,除了水平和趋势外。
Holt-Winters季节性预测模型由预测函数和三次平滑函数组成——分别是水平函数ℓt、趋势函数bt、季节分量 st,以及平滑参数α,β和γ。
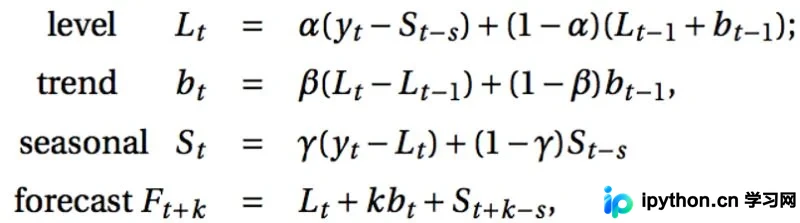
其中 s 为季节循环长度,0≤α≤ 1, 0 ≤β≤ 1 , 0≤γ≤ 1。水平函数为季节性调整的观测值和时间点t处非季节预测之间的加权平均值。趋势函数与霍尔特线性方法中的含义相同。季节函数为当前季节指数和去年同一季节的季节性指数之间的加权平均值。在本算法中,同样可使用相加和相乘方法。当季节性变化大致相同时,优先选择相加方法;当季节变化的幅度与各时间段的水平成正比时,优先选择相乘方法。
from statsmodels.tsa.api import ExponentialSmoothing

y_hat_avg = test.copy()
fit1 = ExponentialSmoothing(np.asarray(train['Count']), seasonal_periods=7, trend='add', seasonal='add', ).fit()
y_hat_avg['Holt_Winter'] = fit1.forecast(len(test))
plt.figure(figsize=(16, 8))
plt.plot(train['Count'], label='Train')
plt.plot(test['Count'], label='Test')
plt.plot(y_hat_avg['Holt_Winter'], label='Holt_Winter')
plt.legend(loc='best')
plt.show()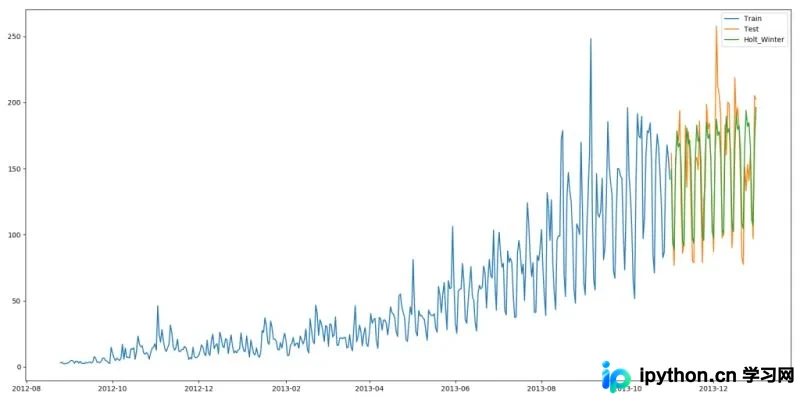
可见趋势和季节性预测准确度均较高。我们选择了 seasonal_period = 7作为每周重复的数据周期。也可调整其他参数,我在搭建此模型时使用默认参数。读者可尝试调整参数以优化模型。
自回归移动平均模型(ARIMA)
方法7:自回归移动平均模型(ARIMA)
另一类时序模型是自回归移动平均模型(ARIMA)。指数平滑模型基于对数据中趋势和季节性的描述,而自回归移动平均模型旨在描述数据彼此间的关系。ARIMA的一个优化版为季节性ARIMA(SARIMA),它像Holt-Winters季节性预测模型一样,也将数据集的季节性考虑在内。
import statsmodels.api as sm

y_hat_avg = test.copy()
fit1 = sm.tsa.statespace.SARIMAX(train.Count, order=(2, 1, 4), seasonal_order=(0, 1, 1, 7)).fit()
y_hat_avg['SARIMA'] = fit1.predict(start="2013-11-1", end="2013-12-31", dynamic=True)
plt.figure(figsize=(16, 8))
plt.plot(train['Count'], label='Train')
plt.plot(test['Count'], label='Test')
plt.plot(y_hat_avg['SARIMA'], label='SARIMA')
plt.legend(loc='best')
plt.show()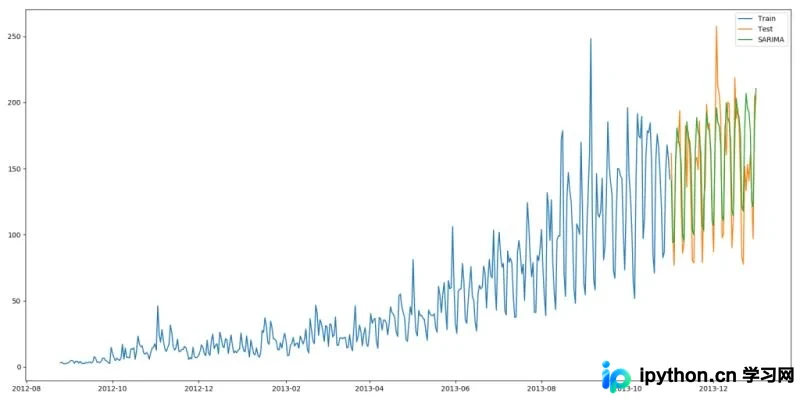
可见使用季节性ARIMA的效果与Holt-Winters相近。我们根据ACF(自相关函数)和PACF(偏自相关)图选择参数。若为ARIMA模型选择参数遇到困难,可使用R语言中的auto.arima函数。
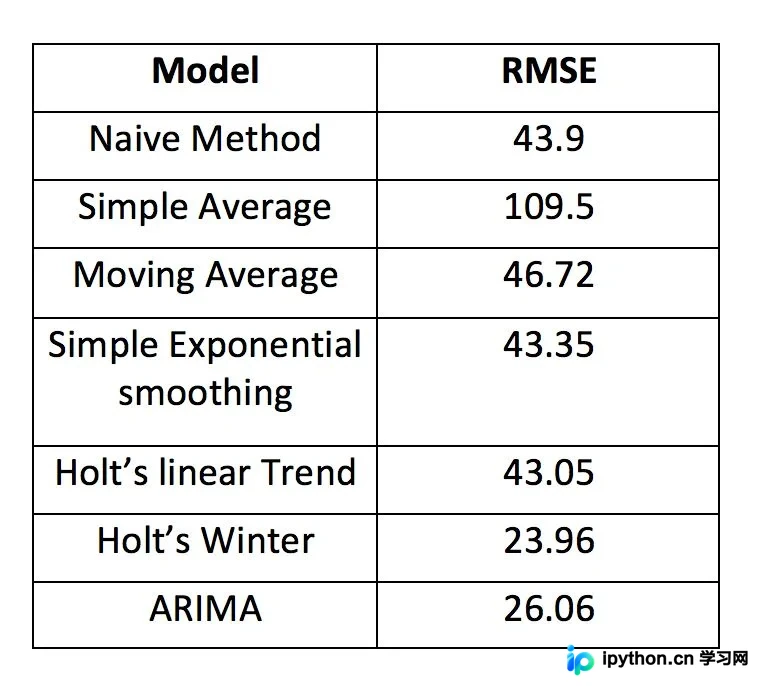
最后,我们将几种模型的准确度进行比较:
模型比较与总结
后话
建议在解决问题时,依次尝试这几种模型,观察哪种效果最佳。从上文可知,不同数据集下,每种模型的效果可能优于其他模型。因此,一个模型在某个数据集上表现良好,并不代表它在所有数据集上都优于其他模型。
参考链接:
1. 标点符-用Python进行时间序列预测的7种方法
2. 博客园-python时间序列resample参数
3. CSDN-python resample()函数(用于数据聚合)
到此这篇关于详解用Python进行时间序列预测的7种方法的文章就介绍到这了,更多相关Python 时间序列预测内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















