


Python中urlencode与unquote函数的实际应用解析

发布时间:2026-10-13 |
4人浏览过
本文详细解析Python中处理含中文URL参数的常见需求,重点介绍urllib库中的urlencode和unquote函数。通过具体代码示例,展示如何将键值对转换为标准查询字符串,以及如何对单个字符串进行编码和解码操作,解决Callback等场景下的中文传递问题。
URL中文参数处理背景
在处理包含中文的URL地址,或者URL参数中含有中文字符时,这是非常普遍的情况。然而,当需要将此类URL作为参数传递时(最常见的场景如回调地址callback),必须对部分中文字符甚至斜杠'/'进行编码转换,以确保数据能正确传输。
因此,对于URL无法直接识别的中文或特殊字符,需要执行相应的转换操作。具体的转换结果示例如下所示:
urlencode函数详解
一、urlencode函数应用
在Python的urllib库中,内置了urlencode函数,该函数能够将键值对(key-value)格式的数据转换为所需的字符串格式,返回形式类似于a=1&b=2。具体使用示例如下:
import urllib.parse
values={}
values['username']='02蔡彩虹'
values['password']='ddddd?'
url="http://www.baidu.com"
data=urllib.parse.urlencode(values)
print(data)
运行上述代码后的输出结果如下:

若仅需对单个字符串执行urlencode转换,应如何处理?此时,urllib库提供了另一个专用函数:quote()。
import urllib.parse
s='长春'
s=urllib.parse.quote(s)
print(s)
使用该函数处理后的输出结果为:
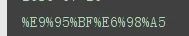
unquote解码操作
二、urldecode(解码)操作
当经过urlencode编码后的字符串被传递并接收完毕后,接下来需要进行解码处理,即urldecode。需要注意的是,urllib库中提供了unquote()函数用于此目的,但并未提供名为urldecode()的函数。
s='%E5%B9%BF%E5%B7%9E'
s=urllib.parse.unquote(s)
print(s)
执行unquote解码后的输出结果为:

以上内容涵盖了本文的核心知识点,希望能为读者的学习提供有益帮助。同时也欢迎大家继续支持本站,获取更多技术分享。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















