


Python多线程下载脚本实现详解

发布时间:2026-10-13 |
3人浏览过
本文介绍使用Python实现多线程下载网络资源的完整脚本。通过Download类计算文件总大小并分配线程任务,结合ThreadDownload类继承threading.Thread实现并发读写。代码包含URL请求头设置、分块下载逻辑及进度回显功能,适用于歌曲或大文件的高效下载场景。
多线程下载原理分析
0x01 原理分析
构建一个简易的多线程资源下载Python脚本,核心逻辑由两个主要类构成:
Download类:该类封装了download()和get_complete_rate()两种核心方法。
- 在方法中,首先利用urlopen()建立与远程资源的连接,并通过Content-Length头部信息获取文件的总大小。随后,脚本计算每个线程应负责下载的数据块大小及对应的字节范围,最后依次创建并启动多个线程,分别下载网络资源的指定片段。
- 方法用于计算并返回当前已下载数据量占文件总大小的比例,以此实现下载进度的实时回显。
ThreadDownload类:此线程类继承自threading.Thread,内部包含一个run()方法。
方法的主要职责是负责从网络读取数据,并将其写入本地文件。
Python代码实现
0x02 代码实现
# 文件名:ThreadDownload.py
import threading
from urllib.request import *


class Download:
  def __init__(self, link, file_path, thread_num):
    # 下载路径
    self.link = link
    # 保存位置
    self.file_path = file_path
    # 使用多少线程
    self.thread_num = thread_num
    # 初始化threads数组
    self.threads = []

  def download(self):
    req = Request(url=self.link, method='GET')
    req.add_header('Accept', '*/*')
    req.add_header('Charset', 'UTF-8')
    req.add_header('Connection', 'Keep-Alive')
    f = urlopen(req)
    # 获取要下载的文件的大小
    self.file_size = int(dict(f.headers).get('Content-Length', 0))
    f.close()
    # 计算每个线程要下载的资源的大小
    current_part_size = self.file_size // self.thread_num + 1
    for i in range(self.thread_num):
      # 计算每个线程下载的开始位置
      start_pos = i * current_part_size
      # 每个线程使用一个wb模式打开的文件进行下载
      t = open(self.file_path, 'wb')
      t.seek(start_pos, 0)
      # 创建下载线程
      td = ThreadDownload(self.link, start_pos, current_part_size, t)
      self.threads.append(td)
      td.start()

  # 获下载的完成百分比
  def get_complete_rate(self):
    sum_size = 0
    for i in range(self.thread_num):
      sum_size += self.threads[i].length
    return sum_size / self.file_size

class ThreadDownload(threading.Thread):
  def __init__(self, link, start_pos, current_part_size, current_part):
    super().__init__()
    # 下载路径
    self.link = link
    # 当前线程的下载位置
    self.start_pos = start_pos
    # 定义当前线程负责下载的文件大小
    self.current_part_size = current_part_size
    # 当前文件需要下载的文件快
    self.current_part = current_part
    # 定义该线程已经下载的字节数
    self.length = 0

  def run(self):
    req = Request(url = self.link, method='GET')
    req.add_header('Accept', '*/*')
    req.add_header('Charset', 'UTF-8')
    req.add_header('Connection', 'Keep-Alive')

    f = urlopen(req)
    # 跳过self.start_pos个字节,表明该线程只负责下载自己负责的那部分内容
    for i in range(self.start_pos):
      f.read(1)
    # 读取网络数据,并写入本地
    while self.length < self.current_part_size:
      data = f.read(1024)
      if data is None or len(data) <= 0:
        break
      self.current_part.write(data)
      # 累计该线程下载的总大小
      self.length += len(data)
    self.current_part.close()
    f.close()
#!/usr/bin/env python
# -*- coding: utf-8 -*-
# 文件名:thread_download-master.py

import sys
import time

from ThreadDownload import *


def show_process(dl):
  while dl.get_complete_rate() < 1:
    complete_rate = int(dl.get_complete_rate()*100)
    print('\r' + '下载中···(已下载' + str(complete_rate) + '%)', end='', flush=True)
    time.sleep(0.01)


def main():
  try:
    Link = input('[+]' + 'Link: ')
    file_path = input('[+]' + 'File Path: ')
    thread_number = input('[+]' + 'Thread Number: ')
    thread_number = int(thread_number)
    dl = Download(Link, file_path, thread_number)
    dl.download()
    print('\n开始下载!')
    show_process(dl)
    print('\r' + '下载中···(已下载' + '100%)', end='', flush=True)
    print('\n下载完成!')
  except Exception:
      print('Parameter Setting Error')
      sys.exit(1)

if __name__=='__main__':
    main()
运行结果示例
0x03 运行结果展示
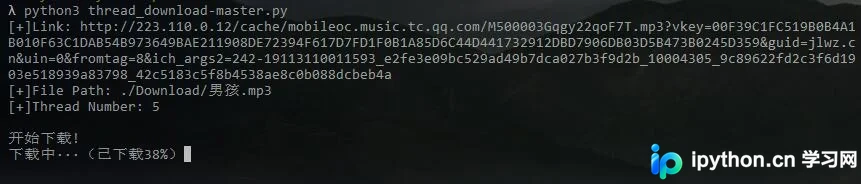
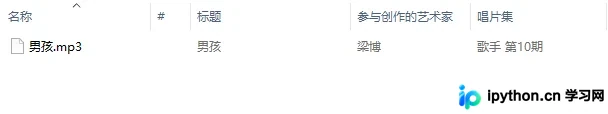
以下载歌曲《男孩》为例,文件将保存至./Download/目录,并命名为男孩.mp3。此处配置使用5个线程进行并发下载:
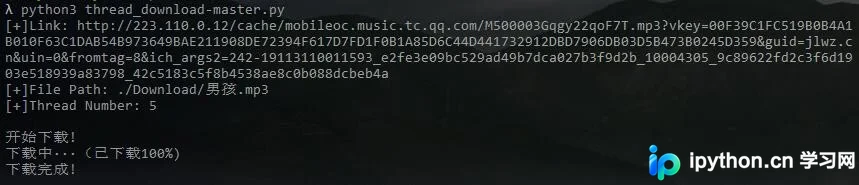
下载成功后的输出如下:
以上就是关于Python实现多线程下载脚本的示例代码。如需了解更多Python多线程下载相关技术,请搜索本站历史文章或继续浏览后续内容,感谢大家的支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















