


Python多进程生产者消费者模型:Queue与JoinableQueue实现详解

本文详解Python多进程环境下生产者消费者模型的两种实现方式。首先分析基础Queue模型中因缺乏停止信号导致的阻塞问题,并展示通过手动发送None值解决的方案。随后深入介绍JoinableQueue,利用task_done和join方法自动管理任务计数,实现更优雅的多消费者退出机制,避免手动发送多个结束信号的繁琐。
生产者消费者模型概述
一、生产者消费者模型介绍
1.1 为什么需要使用生产者消费者模型
在该模型中,负责生成数据的任务称为生产者,负责处理数据的任务称为消费者。若生产速度远超消费速度,生产者必须等待消费者处理完毕才能继续生成新数据;反之,若消费速度快于生产速度,消费者则需等待生产者生成数据。这种相互等待会显著降低系统效率。为了解决这一瓶颈,引入了生产者消费者模型来解耦生产与消费过程。
1.2 如何实现生产者消费者模型
在进程间通信中,引入队列是实现生产者消费者模型的有效手段。利用队列机制,开发者无需手动管理复杂的锁机制,因为进程间的数据交换已通过队列对象自动处理。
具体而言,生产者将生成的数据写入队列,消费者则直接从队列中读取数据进行消费。这种架构实现了生产者和消费者之间的解耦,使两者可以独立运行。
生产者 -- > 队列 <--消费者
基于Queue的实现与问题
二、Queue实现生产者消费者模型
2.1 消费者生产者模型代码
from multiprocessing import Process, Queue
import time

# 消费者方法
def consumer(q, name):
  while True:
    res = q.get()
    # if res is None: break
    print("%s 吃了 %s" % (name, res))

# 生产者方法
def producer(q, name, food):
  for i in range(3):
    time.sleep(1) # 模拟生产西瓜的时间延迟
    res = "%s %s" % (food, i)
    print("%s 生产了 %s" % (name, res))
    # 把生产的vegetable放入到队列中
    q.put(res)

if __name__ == "__main__":
  #创建队列
  q = Queue()
  # 创建生产者
  p1 = Process(target=producer, args=(q, "kelly", "西瓜"))
  c1 = Process(target=consumer, args=(q, "peter",))
  p1.start()
  c1.start()

  # p1.join()
  # q.put(None)
  print("主进程")
2.2 执行结果
2.2.1 直接执行上面的代码的结果
直接运行上述代码会暴露一个关键问题:当生产者完成所有数据生成后,并未向消费者发送任何停止信号。这导致消费者进程一直阻塞在q.get()调用上,等待新数据,从而导致整个程序无法正常退出。
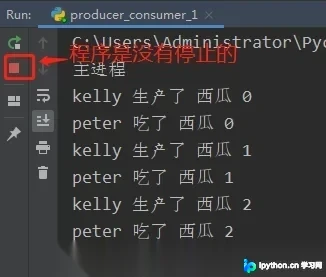
为解决此问题,确保消费者在消费完生产者数据后能自动退出,需要在生产者进程结束时向队列中放入一个特殊的结束信号。消费者接收到该信号后,即可终止消费进程。
主要修改点在于取消代码中相关注释。开启这些注释后,消费者在消费完数据并接收到生产者的结束信号后,将正常退出消费者进程。
def consumer():
  if res is None: break

if __name__ == "__main__":
p1.join()
q.put(None)
2.2.2 把注释打开后的运行结果
开启注释后,消费者成功接收到生产者发送的结束信号,程序得以正常退出。
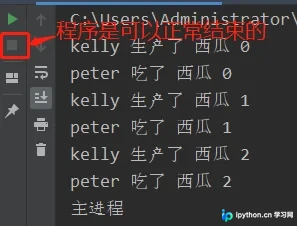
然而,如果存在n个消费者进程,就需要向队列中发送n个结束信号。这种方式不够简洁,如以下代码所示:
from multiprocessing import Process, Queue
import time


# 消费者方法
def consumer(q, name):
  while True:
    res = q.get()
    if res is None: break
    print("%s 吃了 %s" % (name, res))


# 生产者方法
def producer(q, name, food):
  for i in range(3):
    time.sleep(1) # 模拟生产西瓜的时间延迟
    res = "%s %s" % (food, i)
    print("%s 生产了 %s" % (name, res))
    # 把生产的vegetable放入到队列中
    q.put(res)


if __name__ == "__main__":
  # 创建队列
  q = Queue()
  # 创建生产者
  p1 = Process(target=producer, args=(q, "kelly", "西瓜"))
  p2 = Process(target=producer, args=(q, "kelly2", "香蕉"))
  c1 = Process(target=consumer, args=(q, "peter",))
  c2 = Process(target=consumer, args=(q, "peter2",))
  c3 = Process(target=consumer, args=(q, "peter3",))
  p1.start()
  p2.start()
  c1.start()
  c2.start()
  c3.start()

  p1.join()
  p2.join()
  q.put(None)
  q.put(None)
  q.put(None)
  print("主进程")
基于JoinableQueue的优化实现
实际上,当生产者完成数据生成并试图发送结束信号时,Python提供了另一种队列类型JoinableQueue([maxsize])来处理此类场景,它提供了更高级的管理机制。
三、JoinableQueue实现生产者消费者模型
3.1 JoinableQueue方法介绍
JoinableQueue([maxsize]):一种支持join()和task_done()方法的队列类型。
q.task_done():消费者使用此方法发出信号,表明通过q.get()获取的项目已被处理完毕。
q.join():生产者调用此方法进行阻塞,直到队列中所有的项目均被处理完毕。阻塞将持续到队列中的每个项目都调用了q.task_done()方法为止。
3.2 JoinableQueue实现生产者消费者模型源码
from multiprocessing import Process,JoinableQueue
import time


# 消费者方法
def consumer(q, name):
  while True:
    res = q.get()
    if res is None: break
    print("%s 吃了 %s" % (name, res))
    q.task_done() # 发送信号给q.join(),表示已经从队列中取走一个值并处理完毕了


# 生产者方法
def producer(q, name, food):
  for i in range(3):
    time.sleep(1) # 模拟生产西瓜的时间延迟
    res = "%s %s" % (food, i)
    print("%s 生产了 %s" % (name, res))
    # 把生产的vegetable放入到队列中
    q.put(res)
  q.join() # 等消费者把自己放入队列的所有元素取完之后才结束


if __name__ == "__main__":
  # q = Queue()
  q = JoinableQueue()
  # 创建生产者
  p1 = Process(target=producer, args=(q, "kelly", "西瓜"))
  p2 = Process(target=producer, args=(q, "kelly2", "蓝莓"))
  # 创建消费者
  c1 = Process(target=consumer, args=(q, "peter",))
  c2 = Process(target=consumer, args=(q, "peter2",))
  c3 = Process(target=consumer, args=(q, "peter3",))

  c1.daemon = True
  c2.daemon = True
  c3.daemon = True

  p_l = [p1, p2, c1, c2, c3]
  for p in p_l:
    p.start()

  p1.join()
  p2.join()
  # 1.主进程等待p1,p2进程结束才继续执行
  # 2.由于q.join()的存在,生产者只有等队列中的元素被消费完才会结束
  # 3.生产者结束了,就代表消费者已经消费完了,也可以结束了,所以可以把消费者设置为守护进程(随着主进程的退出而退出)

  print("主进程")
3.3 运行结果
从运行结果可以看出,生产者无需手动发送结束信号给消费者,而是通过JoinableQueue队列的机制,同样实现了生产者消费者模型的功能。
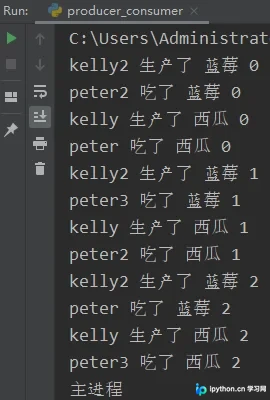
到此这篇关于python多进程下的生产者和消费者模型的文章就介绍到这了,更多相关python多进程下的生产者和消费者内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















