


Python利用pandas一行代码爬取网页表格数据

本文介绍如何使用Python的pandas库通过一行代码高效抓取网页表格数据。相比传统结合requests和bs4的复杂解析方式,pd.read_html()能直接处理URL并返回DataFrame对象。文章详细演示了从抓取代理IP网站表格到保存为CSV文件的完整流程,并解析了read_html函数的常用参数及返回值处理技巧,帮助开发者简化数据采集工作。
使用pandas快速抓取网页表格
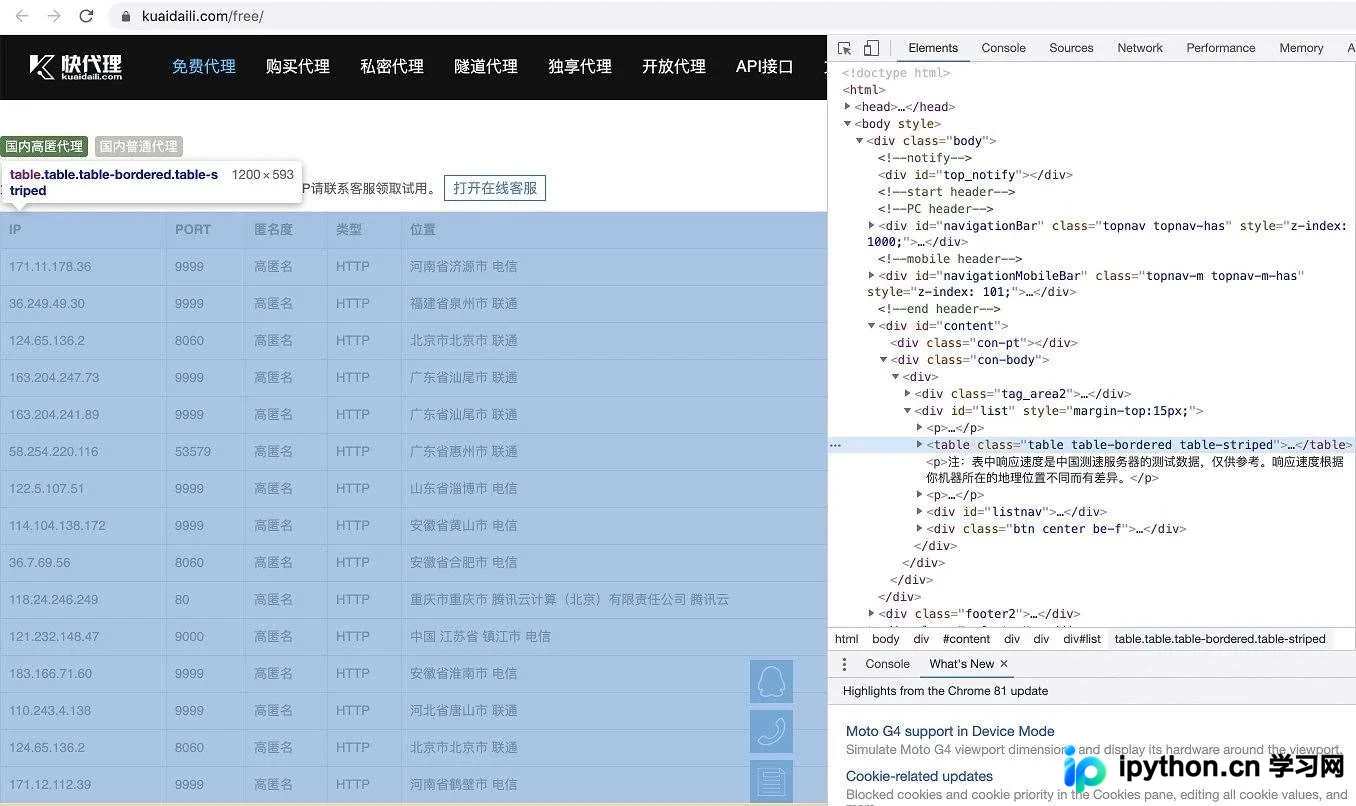
以常见的网页表格为例,目标网站为:https://www.kuaidaili.com/free/。
该网站的数据存储在HTML的table标签中。如果使用传统的requests库配合bs4、正则表达式、xpath或lxml进行解析,通常需要编写多行代码才能完成提取工作。
今天介绍一种更为便捷的方法:利用pandas内置的爬虫功能pd.read_html()。只需传入目标URL,即可通过一行代码完成数据抓取。
原网页的结构大致如下:
对应的Python实现代码如下:
import pandas as pd
url='http://www.kuaidaili.com/free/'
df=pd.read_html(url)[0]
# [0]:表示第一个table,多个table需要指定,如果不指定默认第一个
# 如果没有【0】,输入dataframe格式组成的list
df
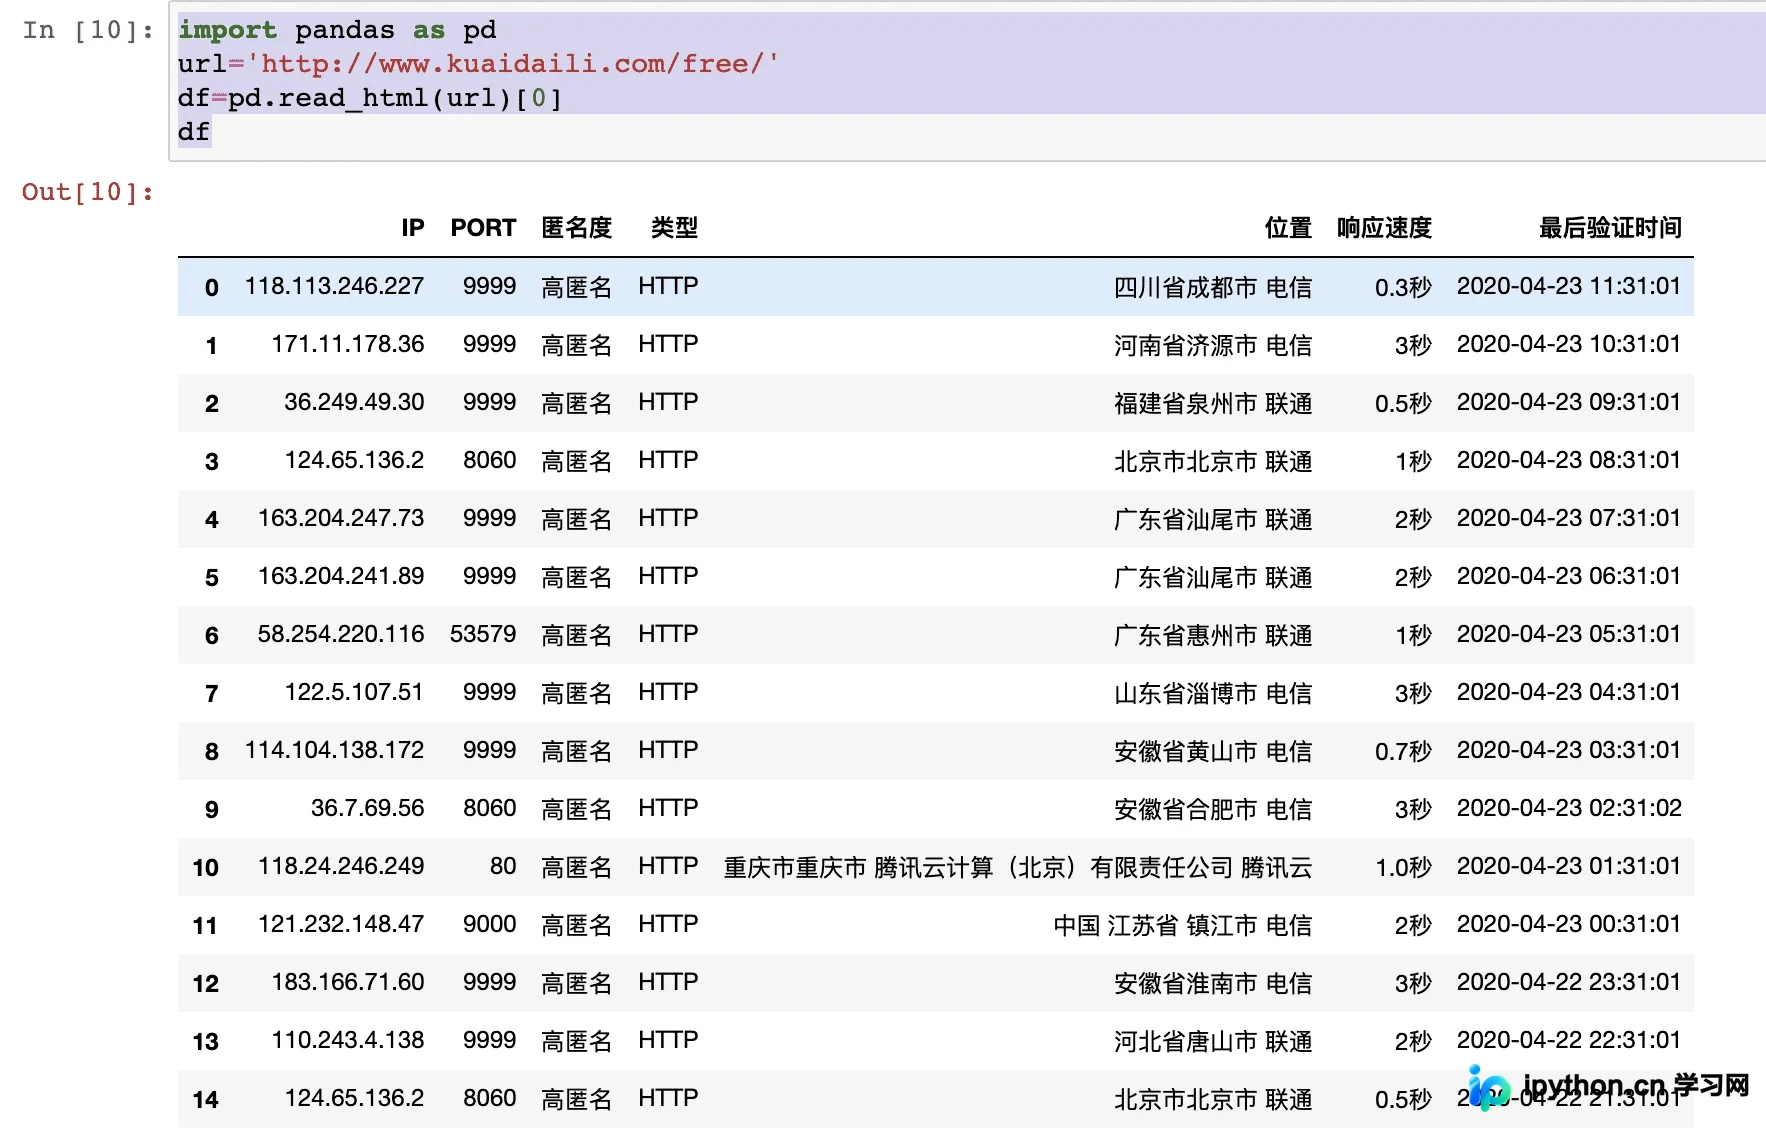
执行后将输出DataFrame格式的数据结果。
若需将数据保存至本地,建议采用CSV格式,并注意指定中文编码为utf_8_sig以避免乱码。
print(type(df))df.to_csv('free ip.csv',mode='a', encoding='utf_8_sig', header=1, index=0)print('done!')
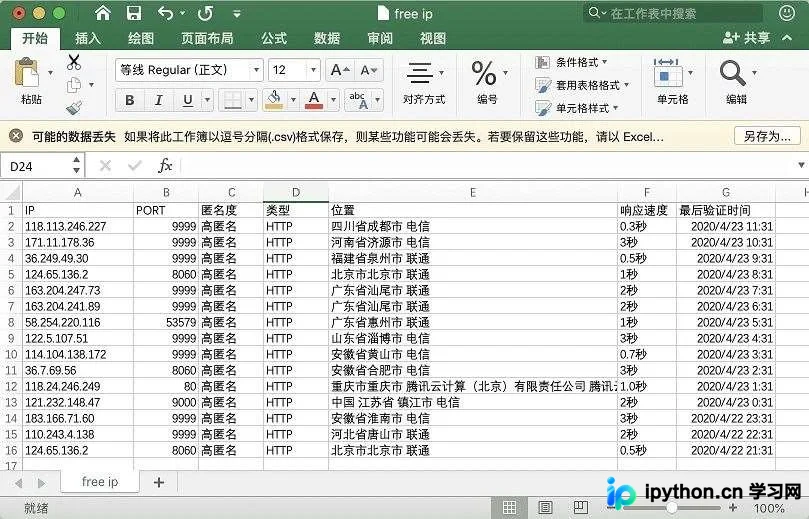
保存后可查看生成的csv文件内容。
read_html函数参数详解
首先了解一下read_html函数的API定义:
pandas.read_html(io, match='.+', flavor=None, header=None, index_col=None, skiprows=None, attrs=None, parse_dates=False, tupleize_cols=None, thousands=', ', encoding=None, decimal='.', converters=None, na_values=None, keep_default_na=True, displayed_only=True)
以下是该函数常用的参数说明:
- io:支持传入url、HTML文本字符串或本地文件路径等;
- flavor:指定使用的解析器类型;
- header:定义表格标题所在的行;
- skiprows:指定需要跳过的行数;
- attrs:用于筛选特定属性的表格,例如 attrs = {'id': 'table'};
- parse_dates:是否解析日期列。
需要注意的是,该函数返回的结果是由**DataFrame**对象组成的**list**。
若需直接获取单个DataFrame,只需从列表中取出索引为【0】的元素即可。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















