


Python爬取全国高校数据并可视化分析实战

发布时间:2026-10-14 |
3人浏览过
本文详解如何利用Python爬取中国教育在线的高校数据,通过requests发送POST请求获取JSON数据,使用Pandas进行清洗与存储至Excel,最后结合Matplotlib等库生成柱形图、地图及分布统计,辅助大学选择决策。
一、获取url
访问中国教育在线网站,按下 F12 键打开开发者工具,在顶部导航栏点击 NetWork 标签页,接着筛选出 XHR 类型的请求。
刷新网页后,观察网络面板中的 url 字段,通过分析 Reponse 响应内容,可以定位到真正提供数据的接口 url 地址为:https://api.eol.cn/gkcx/api/。
目标数据以 Json 格式封装在响应体中。
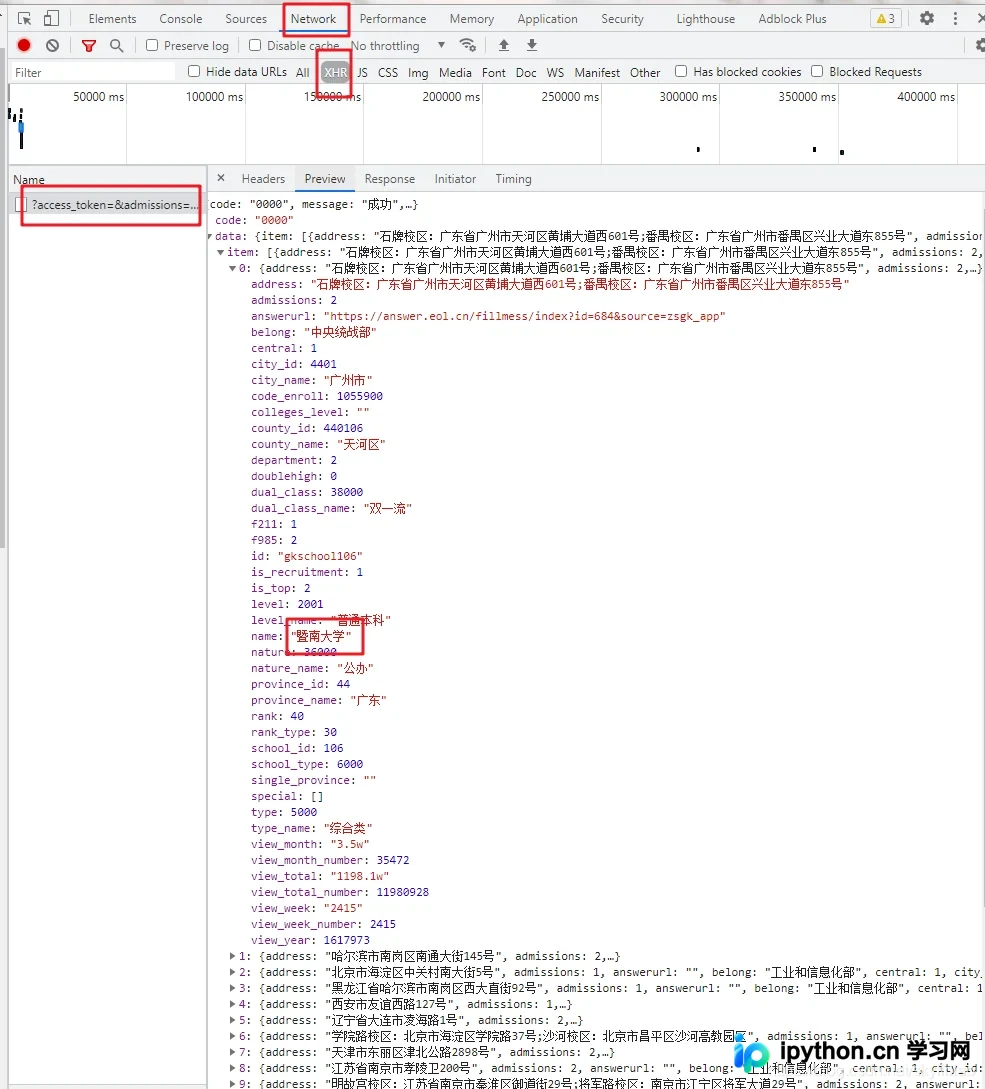
再次点击 Headers 标签页,仔细查看具体的请求参数结构。
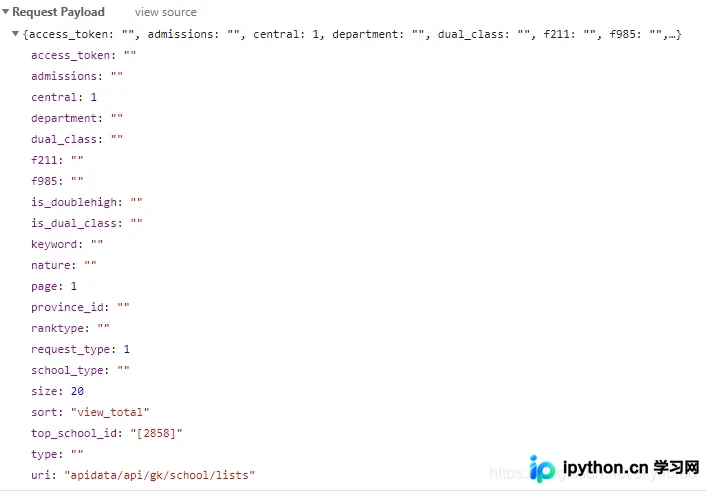
确认该接口的请求方法为 POST。
二、发送请求
确定目标URL后,即可利用 requests 库模拟浏览器行为发送请求,从而获取服务器返回的 Json 格式数据。具体实现代码如下:
# 导入包
import numpy as np
import pandas as pd
import requests
import json
from fake_useragent import UserAgent
import time

# 获取一页
def get_one_page(page_num):
    # 获取URL
    url = 'https://api.eol.cn/gkcx/api/'

    # 构造headers
    headers = {
        'User-Agent': UserAgent().random,
        'Origin': 'https://gkcx.eol.cn',
        'Referer': 'https://gkcx.eol.cn/school/search?province=&schoolflag=&recomschprop=',
    }

    # 构造data
    data = {
        'access_token': "",
        'admissions': "",
        'central': "",
        'department': "",
        'dual_class': "",
        'f211': "",
        'f985': "",
        'is_dual_class': "",
        'keyword': "",
        'page': page_num,
        'province_id': "",
        'request_type': 1,
        'school_type': "",
        'size': 20,
        'sort': "view_total",
        'type': "",
        'uri': "apigkcx/api/school/hotlists",
    }

    # 发起请求
    try:
        response = requests.post(url=url, data=data, headers=headers)
    except Exception as e:
        print(e)
        time.sleep(3)
        response = requests.post(url=url, data=data, headers=headers)
三、解析json数据
依据 Response 返回的 Json 数据结构,编写代码提取所需字段,解析逻辑如下:
# 解析获取数据
    school_data = json.loads(response.text)['data']['item']

    # 学校名
    school_name = [i.get('name') for i in school_data]
    # 隶属部门
    belong = [i.get('belong') for i in school_data]
    # 高校层次
    dual_class_name = [i.get('dual_class_name') for i in school_data]
    # 是否985
    f985 = [i.get('f985') for i in school_data]
    # 是否211
    f211 = [i.get('f211') for i in school_data]
    # 办学类型
    level_name = [i.get('level_name') for i in school_data]
    # 院校类型
    type_name = [i.get('type_name') for i in school_data]
    # 是否公办
    nature_name = [i.get('nature_name') for i in school_data]
    # 人气值
    view_total = [i.get('view_total') for i in school_data]
    # 省份
    province_name = [i.get('province_name') for i in school_data]
    # 城市
    city_name = [i.get('city_name') for i in school_data]
    # 区域
    county_name = [i.get('county_name') for i in school_data]

    # 保存数据
    df_one = pd.DataFrame({
        'school_name': school_name,
        'belong': belong,
        'dual_class_name': dual_class_name,
        'f985': f985,
        'f211': f211,
        'level_name': level_name,
        'type_name': type_name,
        'nature_name': nature_name,
        'view_total': view_total,
        'province_name': province_name,
        'city_name': city_name,
        'county_name': county_name,
    })

    return df_one
四、存入Excel
首先将解析后的数据加载到 Pandas 对象中以便进行后续数据分析,随后将其写入 Excel 文件进行持久化存储。
# 获取多页
def get_all_page(all_page_num):
    # 存储表
    df_all = pd.DataFrame()

    # 循环页数
    for i in range(all_page_num):
        # 打印进度
        print(f'正在获取第{i + 1}页的高校信息')
        # 调用函数
        df_one = get_one_page(page_num=i+1)
        # 追加
        df_all = df_all.append(df_one, ignore_index=True)
        # 休眠
        time.sleep(np.random.uniform(2))

    return df_all


# 运行函数
df_school = get_all_page(all_page_num=143)

# 读出数据
df_school.to_excel('./data/全国高校数据.xlsx', index=False)
五、运行代码
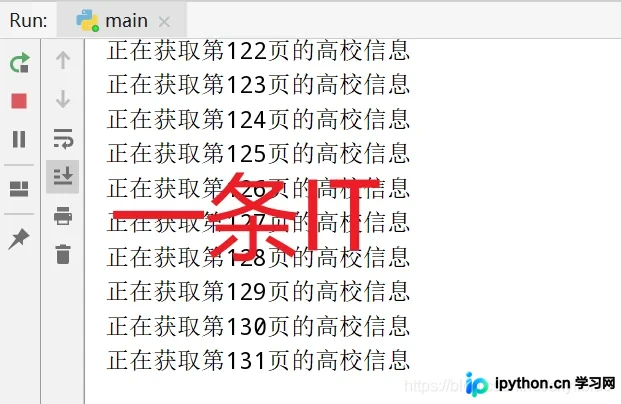
六、数据展示
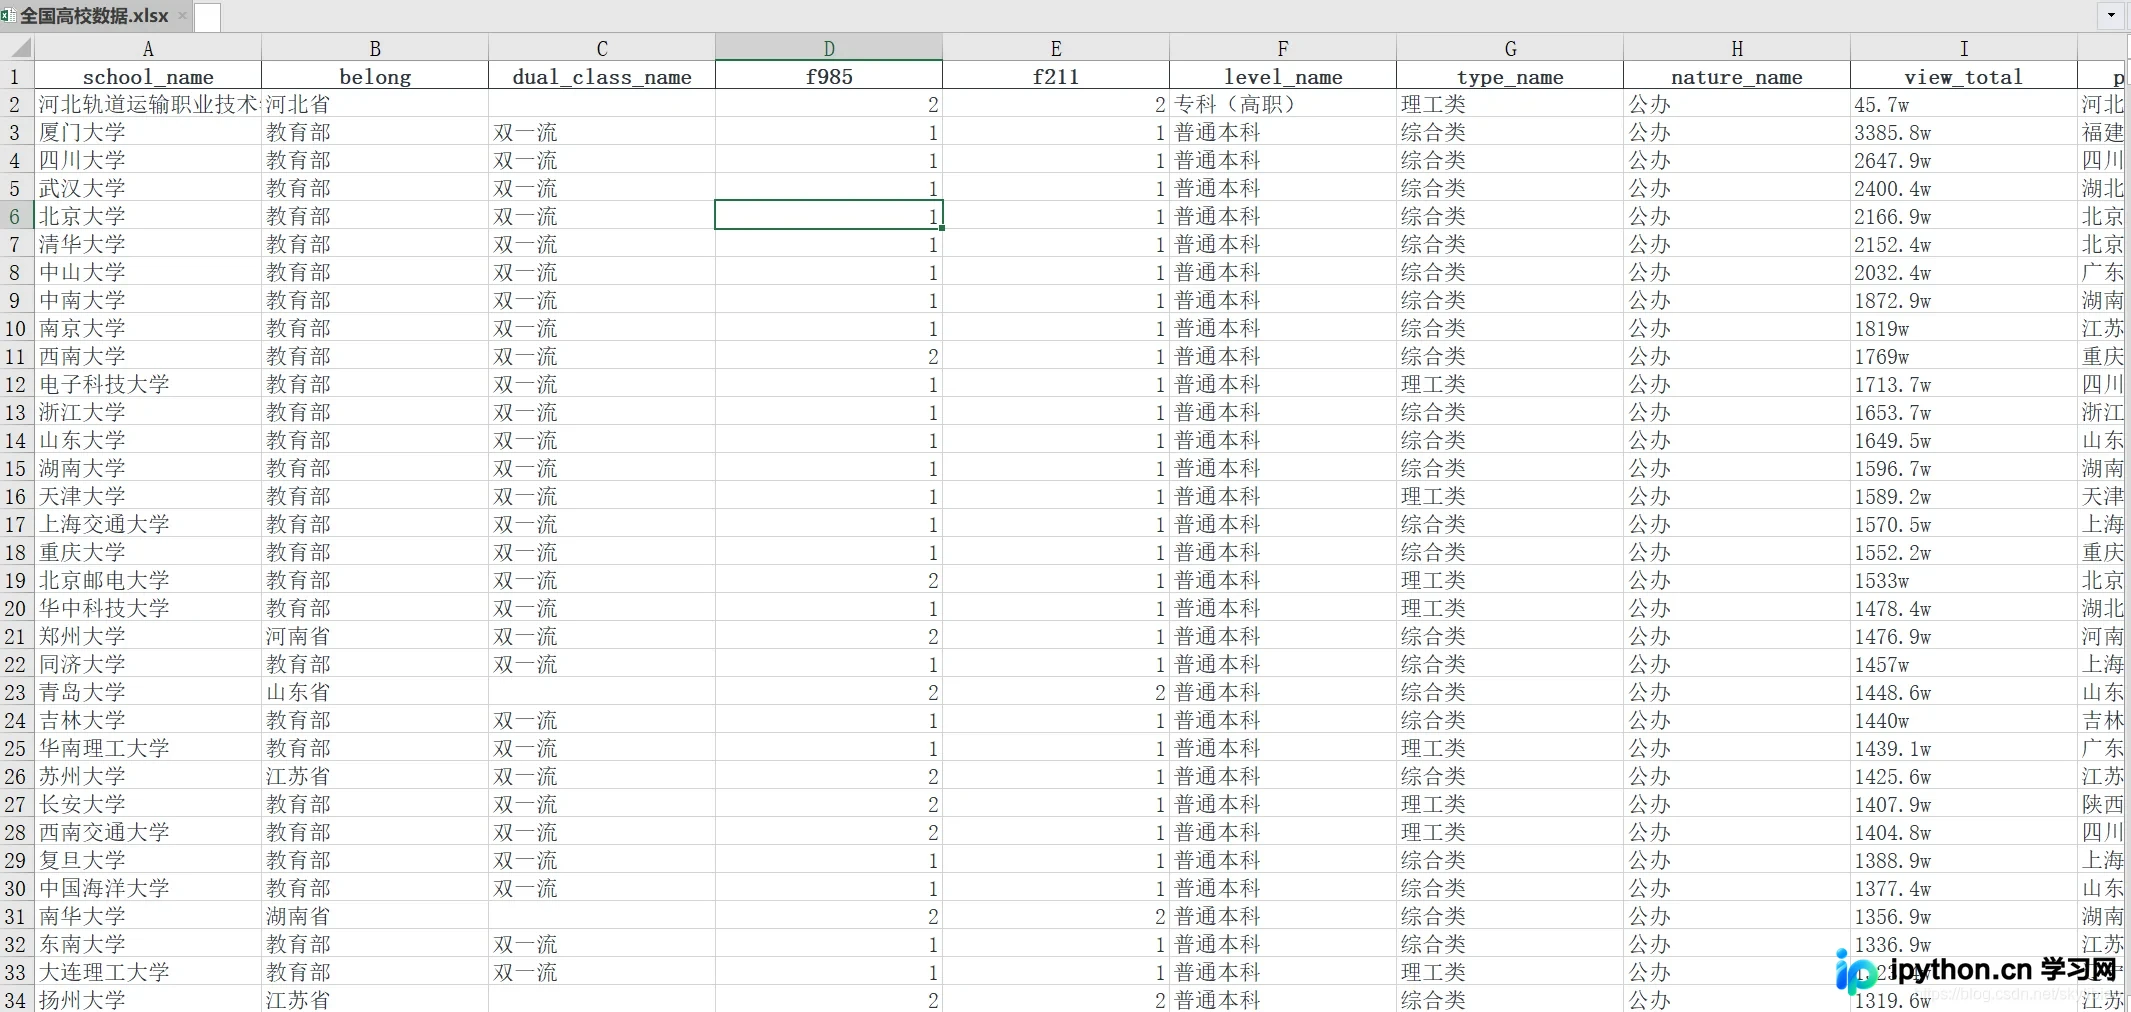
七、数据可视化
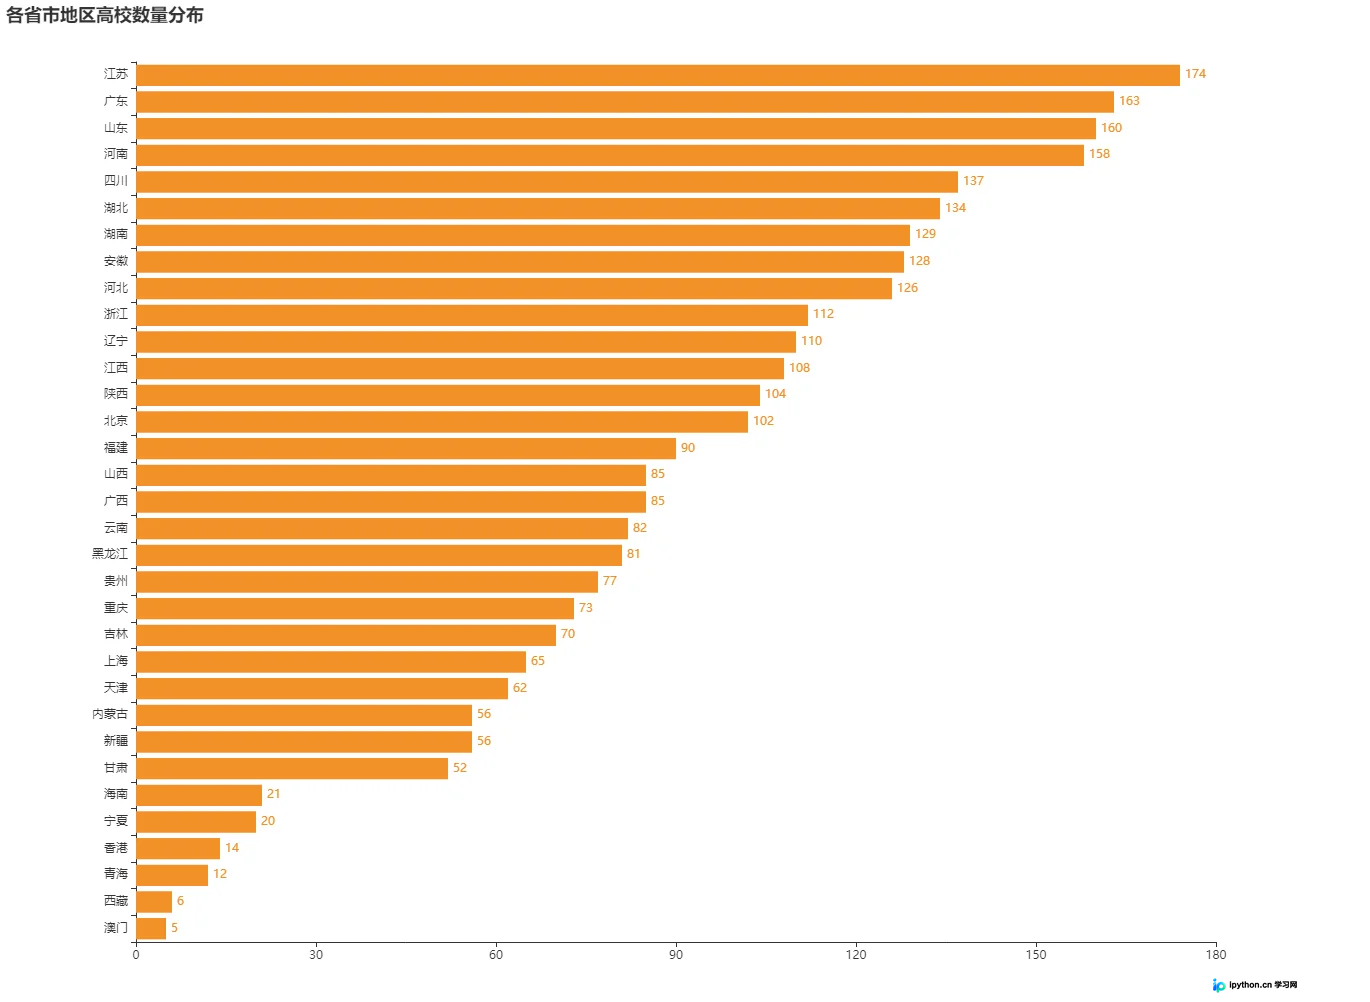
1.各省市地区高校数量分布 柱形图:
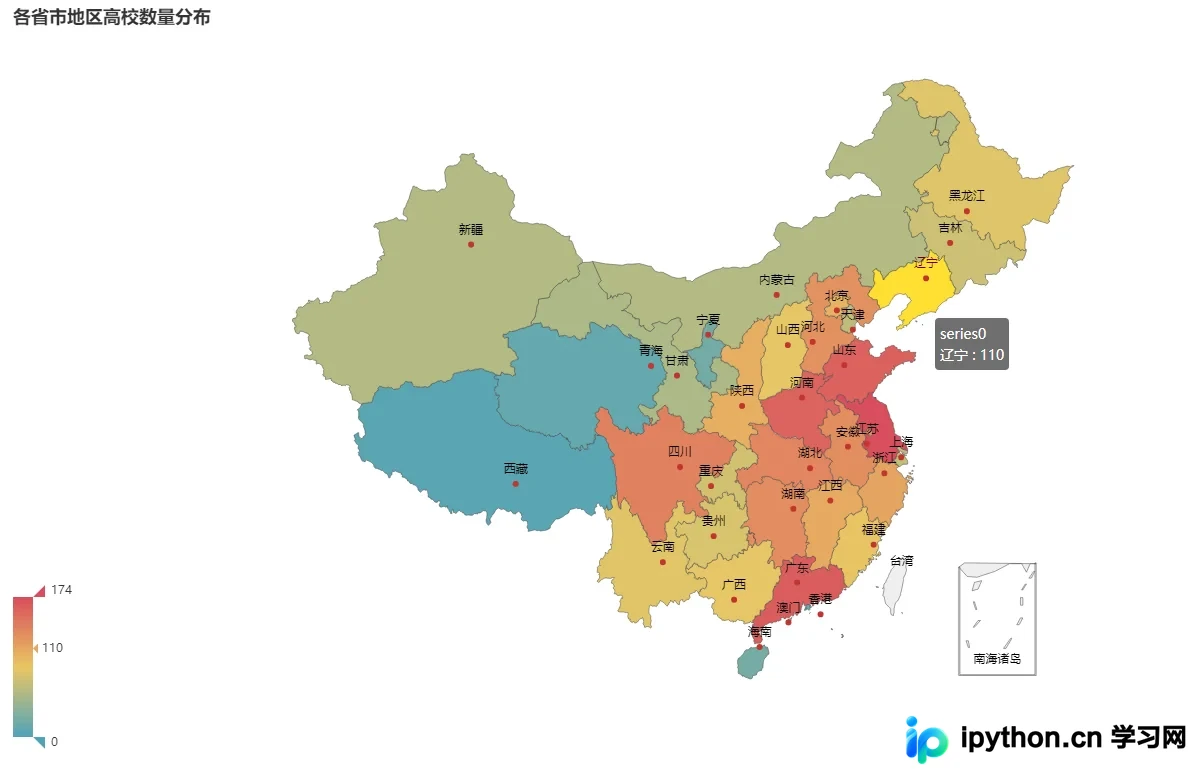
地图
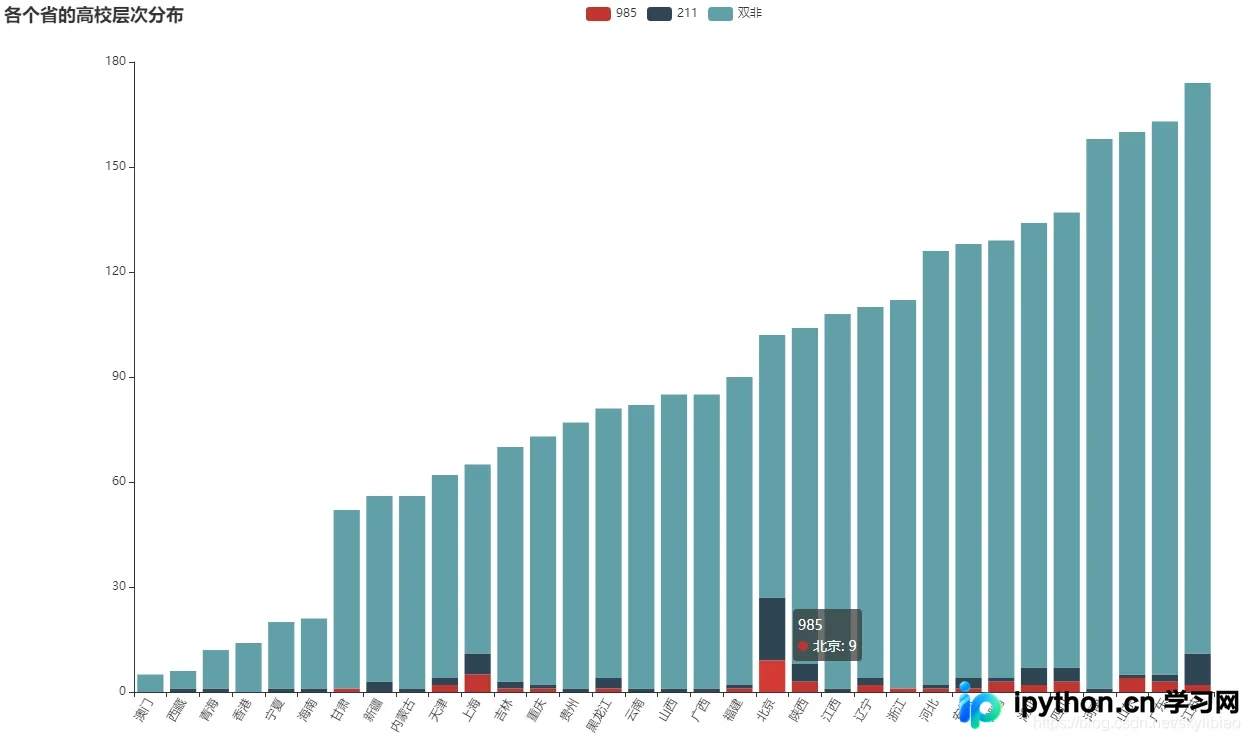
各个省的高校层次分布
全国高校类型分布
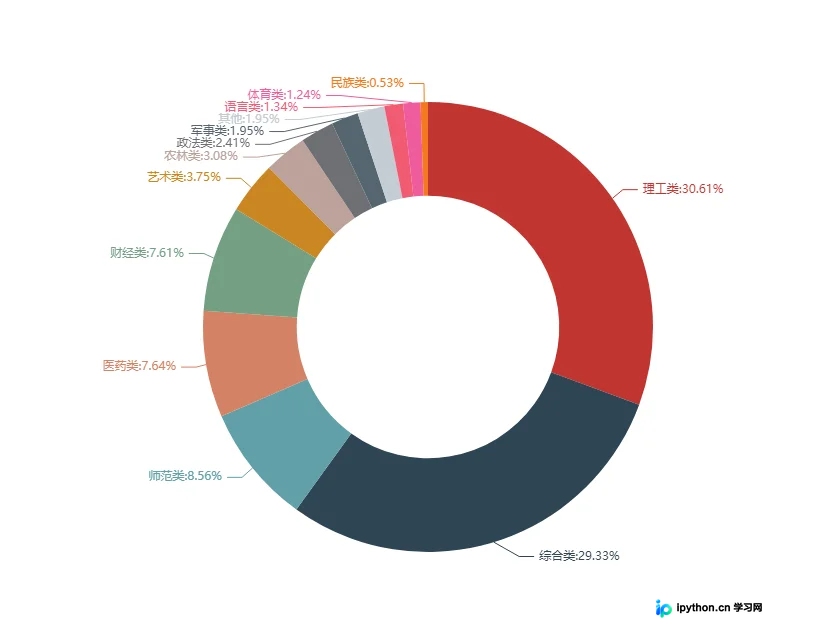
基于上述数据,我们可以对全国高校的整体情况建立初步认知。
至此,关于使用Python爬取各大高校数据并进行可视化展示以辅助选校的文章介绍完毕,更多相关Python爬取数据并可视化内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















