


Python codecs模块处理文件编码错误的解决方案

发布时间:2026-10-13 |
2人浏览过
本文解析Python中使用codecs模块读取文件时遇到的UnicodeDecodeError错误。当utf-8与gbk编码均无法正确解析文件,且出现乱码或特殊字符时,可通过在codecs.open中设置errors="ignore"参数来忽略无法解码的字节,从而正常读取文件内容。
Python codecs模块处理文件编码错误的解决方案
在使用Python的codecs模块进行文件读取操作时,可能会遇到编码错误导致程序中断的情况。
具体的报错信息通常表现为:UnicodeDecodeError: 'utf-8' codec can't decode byte 0xbe in position 0: invalid start byte,这表明文件内容无法被UTF-8编码正确解析。
针对包含中文的文件,尝试将编码方式切换为gbk通常可以解决此类问题,使文件读取恢复正常。
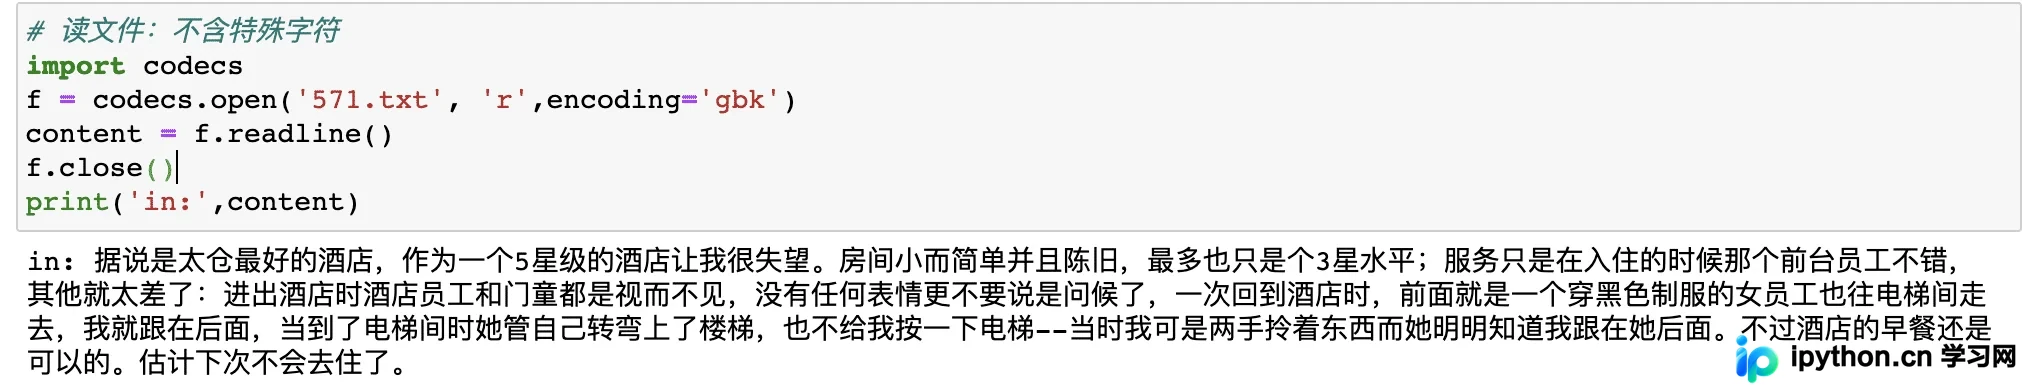
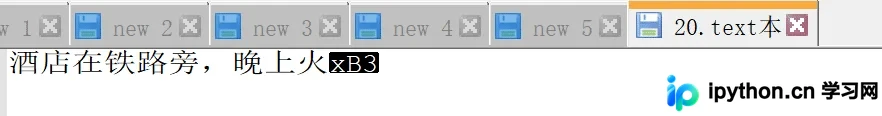
然而,在某些复杂场景下,无论是utf-8还是gbk编码都可能失效。例如使用Notepad++打开文件时,不仅显示乱码,还可能观察到小块黑色异常字符,这暗示文件中存在非标准编码数据。
面对上述情况,建议在调用codecs.open时增加errors="ignore"参数。该参数允许解码器忽略无法识别的字节,从而避免因个别字符编码错误而中断整个读取过程。
# 读文件:含特殊字符
import codecs
f = codecs.open('20.txt', 'rb',encoding='gbk', errors="ignore")
# 默认编码utf-8,中文是gbk
content = f.readline()
f.close()
print('in:',content)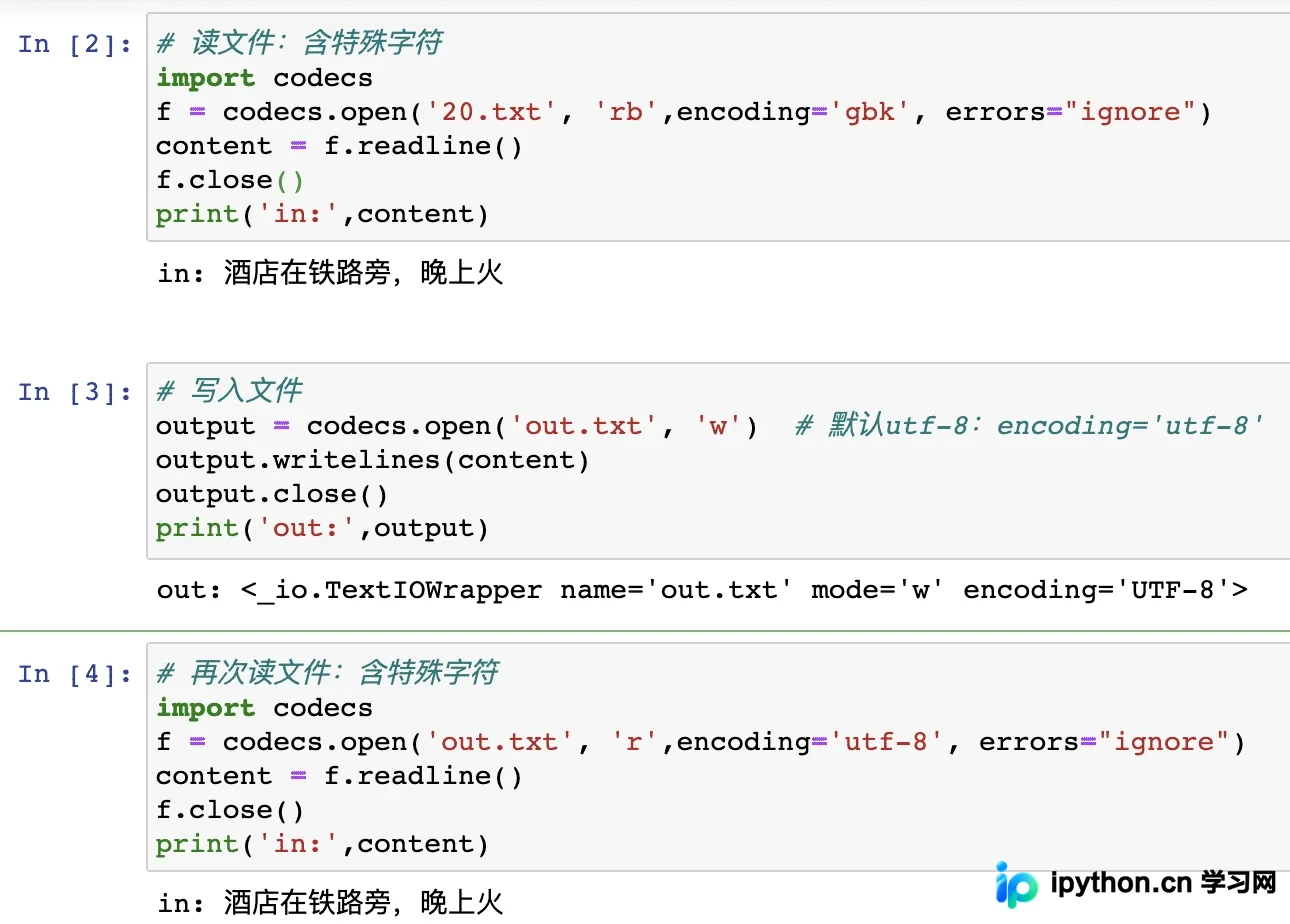
以上即为利用Python codecs模块处理文件编码异常的核心方法,希望能为相关技术学习提供实用参考。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















