


Python利用jieba与wordcloud库制作中文词云详解

发布时间:2026-10-13 |
1人浏览过
本文介绍如何使用Python的jieba库进行中文分词,并结合wordcloud库生成可视化词云。通过读取NSFC.txt文本文件,设置字体、停用词及图片尺寸等参数,最终输出名为world.png的词云图片。
Python中文词云生成代码实现
具体实现代码如下
import wordcloud
import jieba
font = r'C:\Windows\Fonts\simfang.ttf'
w = wordcloud.WordCloud(height = 700, width = 1000, font_path=font, \
            stopwords=['et','al', 'Crampin', 'and','the', 'Liu'], max_words=30)

with open('NSFC.txt', 'r') as f:
  txt = f.read()
txt = ' '.join(jieba.lcut(txt))
print(txt)
w.generate(txt)
w.to_file('world.png')
首先准备数据文件:在当前程序运行目录下放置一个名为NSFC.txt的中文文本文件。
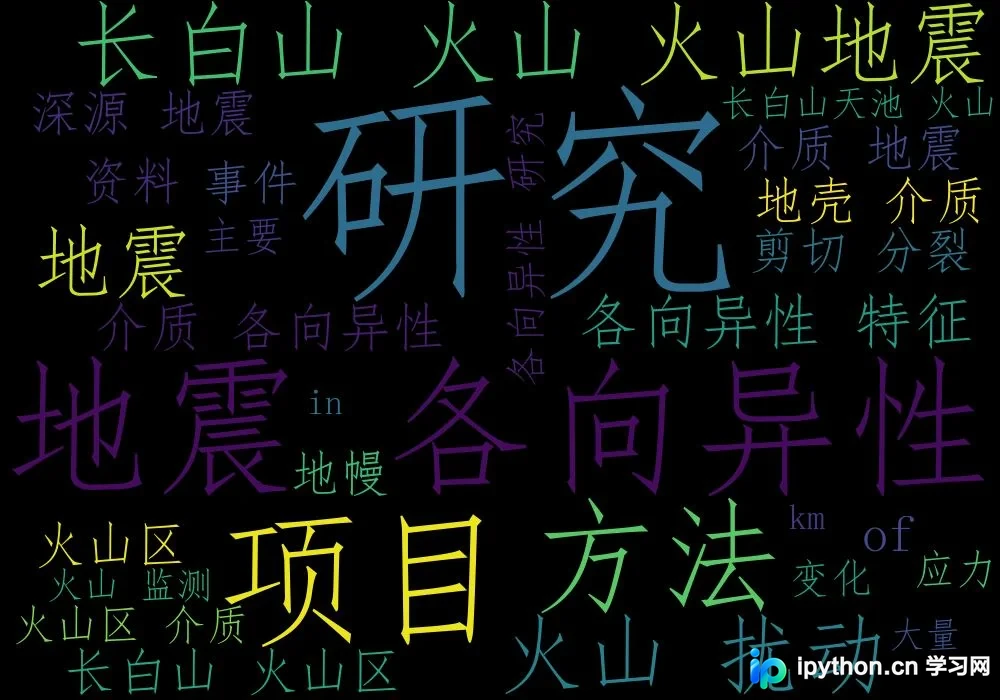
运行程序后,系统将对NSFC.txt中的中文内容进行统计处理,并生成图形文件以展示词云效果。
生成的词云图片效果如下图所示:
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















