


Python爬虫实战:批量抓取动漫截图教程

本文详细介绍使用Python爬虫批量获取动漫网站截图的完整流程。通过requests发送请求,利用正则表达式解析HTML提取图片链接与标题,结合os库管理文件存储,并引入time模块控制爬取频率以遵守网站规范。文章提供完整代码示例及分页处理技巧,帮助初学者快速掌握图片抓取实战技能。
引言与背景
引言
此前因居家闲暇,我在B站观看了一些Python爬虫教学视频。虽然未进行系统的理论深度学习,而是直接切入实战,但这种类似套用公式的学习方式也能实现基本的爬取功能。今天,我将分享一个具体的爬虫代码案例。
正文
不再多言,直接展示完整代码。
注:该代码存在一定缺陷。在爬取fate相关图片时偶尔会报错,因此我使用了try-except结构进行跳过处理。若有高手能指出错误原因并提供修正方案,我将深表感谢。
import requests as r
import re
import os
import time
file_name = "动漫截图"
if not os.path.exists(file_name):
 os.mkdir(file_name)

for p in range(1,34):
  print("--------------------正在爬取第{}页内容------------------".format(p))
  url = 'https://www.acgimage.com/shot/recommend?page={}'.format(p)
  headers = {"user-agent"
   : "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/80.0.3987.162 Safari/537.36"}

  resp = r.get(url, headers=headers)
  html = resp.text

  images = re.findall('data-original="(.*?)" ', html)
  names =re.findall('title="(.*?)"', html)
  #print(images)
  #print(names)
  dic = dict(zip(images, names))
  for image in images:
    time.sleep(1)
    print(image, dic[image])
    name = dic[image]
    #name = image.split('/')[-1]
    i = r.get(image, headers=headers).content
    try:
      with open(file_name + '/' + name + '.jpg' , 'wb') as f:
       f.write(i)
    except FileNotFoundError:
     continue
环境准备与目标分析
首先导入所需的库。
import requests as r
import re
import os
import time
接下来分析目标网址:https://www.acgimage.com/shot/recommend
下图展示了该网址页面的具体内容:
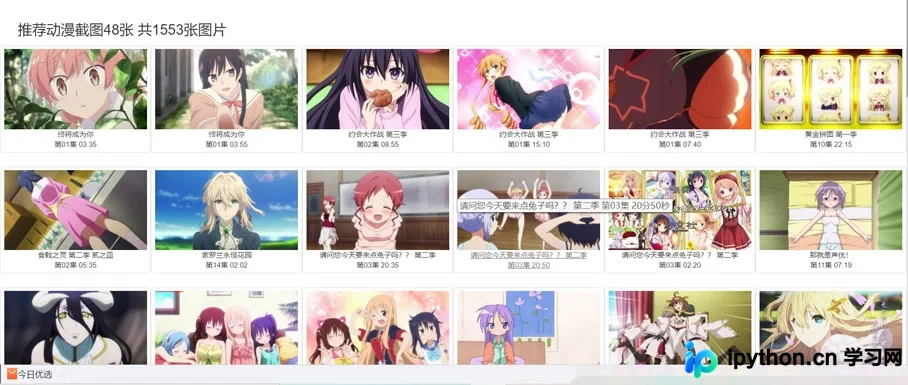
至此,URL已确定。
随后需要查找请求头headers。
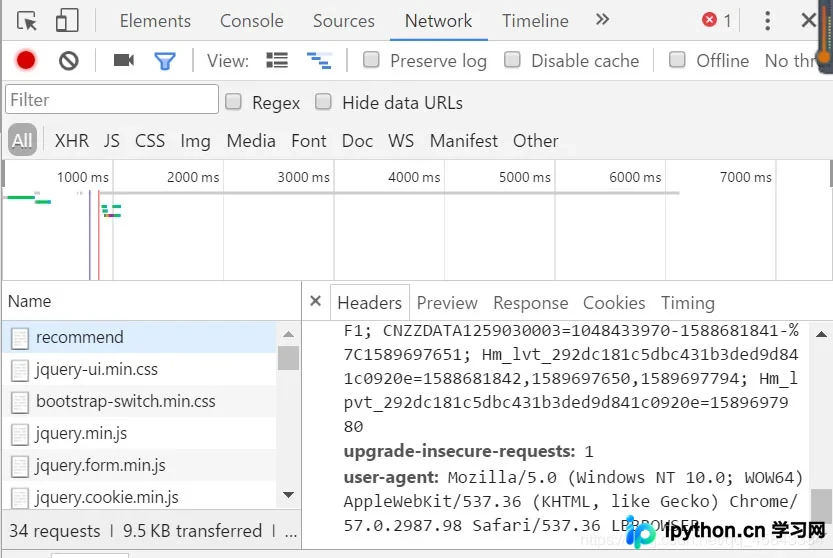
找到user-agent字段,将其值复制到headers字典中。
第一步准备工作完成。
核心代码实现
以下是代码的具体展示。
url = 'https://www.acgimage.com/shot/recommend?page={}'.format(p)
headers = {"user-agent"
   : "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/80.0.3987.162 Safari/537.36"
   }
接着需要检索目标图片的内容。
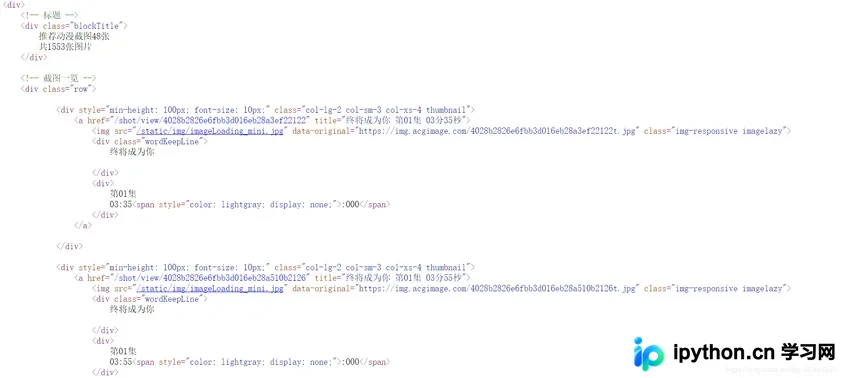
从上图可定位图片地址位于data-original=后的内容,以及图片名称位于title=后的内容。
利用正则表达式re模块进行检索即可。
images = re.findall('data-original="(.*?)" ', html)
names =re.findall('title="(.*?)"', html)
最后将获取到的数据保存即可。
i = r.get(image, headers=headers).content
with open(file_name + '/' + name + '.jpg' , 'wb') as f:
     f.write(i)
分页处理与细节优化
此外还有一些细节需要注意。
例如如何处理分页。
第一页的网址为:
https://www.acgimage.com/shot/recommend
第二页的网址为:https://www.acgimage.com/shot/recommend?page=2
通过修改page后的数字即可跳转到对应页面。
分页问题由此解决。
or p in range(1,34):
    url = 'https://www.acgimage.com/shot/recommend?page={}'.format(p)
将爬取到的图片存入自建文件夹zh中。
此处使用了os库进行文件操作。
 file_name = "动漫截图"
 if not os.path.exists(file_name):
   os.mkdir(file_name)
同时为了不影响目标网站的正常运行,使用了sleep函数。
虽然爬取速度因此变慢。
但这是应当遵守的网络道德。
time.sleep(1)以上即为我的整个爬虫过程。
仍希望各位大佬能帮我解决代码中的错误之处。
万分感谢。
总结
总结
到此,这篇关于Python爬虫实例之获取动漫截图的文章介绍完毕。更多相关Python获取动漫截图的内容,请搜索本站历史文章或继续浏览后续文章,希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















