


Python正则表达式实战:爬取京东商品数据详解

本文详细介绍如何使用Python正则表达式从京东网站抓取商品信息。通过构造包含关键词的URL,利用urllib库获取网页源码,并运用[\s\S]等正则模式精准提取商品数据。文章涵盖URL编码原理、正则匹配技巧及代码实现,帮助开发者掌握基础爬虫技能。
京东商品爬虫概述
京东(JD.com)作为中国领先的自营式电商平台,在2015年第一季度占据了国内自营B2C市场56.3%的份额。面对如此庞大的数据体量,本文将演示如何利用正则表达式,结合用户输入的关键词,构建一个基础的主题爬虫程序。
构建搜索URL与获取响应
首先访问京东首页,输入目标商品关键词,例如“狗粮”,即可获得搜索结果页的URL:https://search.jd.com/Search?keyword=%E7%8B%97%E7%B2%AE&enc=utf-8。其中,%E7%8B%97%E7%B2%AE是经过编码的“狗粮”二字。由此可见,只需对关键词进行相应的URL编码并拼接至搜索参数中,即可生成目标请求地址。获取该网页响应后,即可利用选择器进行后续的数据采集。
在京东官网中,狗粮相关信息的网页源码结构如下所示:
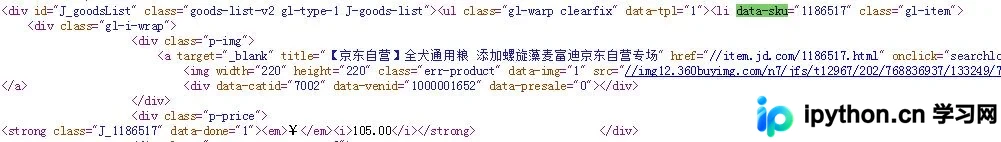
狗粮信息在京东官网上的网页源码
Python代码实现与URL编码
接下来直接展示代码实现,如下图所示。建议使用Python 3版本进行开发。通常URL编码遵循将字符转换为%xx格式的规则,且多基于UTF-8编码标准,具体实现可能与浏览器平台有关。在Python的urllib库中,提供了quote方法,可用于对字符串进行URL编码,从而访问对应的网页资源。
正则表达式原理与应用
正则表达式(Regular Expression,常简写为regex、regexp或RE)是一种强大的模式匹配与替换工具。在获取目标网页源码后,调用urllib中的urlopen函数打开页面,随后利用正则表达式对目标信息进行精确提取。
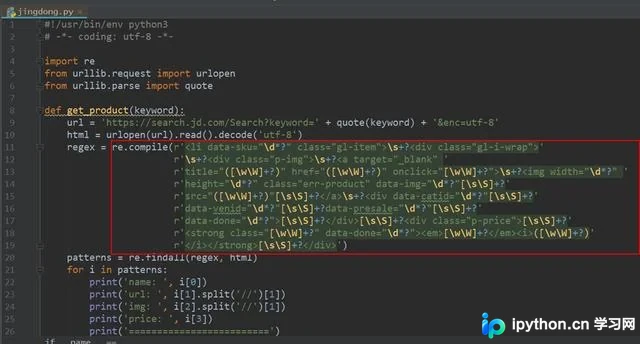
利用正则表达式实现对目标信息的精准采集
核心正则模式解析
虽然程序中的正则表达式编写较为复杂且占用多行,但核心主要依赖于[\w\W]+?和[\s\S]+?这两个模式。
[\s\S]或[\w\W]代表完全通配。其中,\s匹配所有空白字符(包括空格、换行符、制表符等),而\S则匹配非空白字符。两者结合即表示匹配所有字符,确保无一遗漏。此外,[]符号表示匹配其中包含的任意单个字符,且顺序不限。例如正则[ace]*表示匹配任意数量的a、c或e字母。
具体而言,[\s]匹配任意空白字符,[\S]匹配非空白字符。它们的组合[\s\S]或[\w\W]表示匹配所有字符,这与通配符“.”的效果类似,但“.”默认不匹配换行符。因此,当需要处理包含换行的文本时,使用[\s\S]或[\w\W]是更稳妥的选择。
最终程序的输出效果如下图所示:
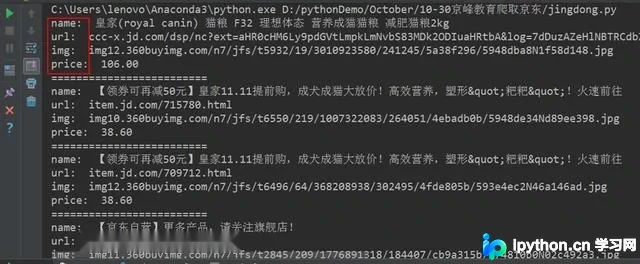
输出效果图
结果展示与扩展建议
通过上述方法,即可获取狗粮的商品信息。本文仅作为示例,仅匹配了四项基本信息且仅处理单页数据。如需获取更多数据,读者可自行调整正则表达式并设置多页抓取逻辑。后续文章将介绍如何使用BeautifulSoup库进行数据匹配,以实现更精准的数据获取。
正则表达式基础回顾
简要回顾正则表达式:它使用单个字符串来描述和匹配一系列符合特定语法规则的字符串。在许多文本编辑器中,正则表达式常用于检索和替换符合特定模式的文本。
正则表达式对初学者而言可能较为晦涩,但通过逐步学习是可以掌握的。无需死记所有参数,关键在于理解何时使用何种参数,并能熟练应用即可。
以上就是本文的全部内容,希望能为您的学习提供帮助,欢迎继续支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















