


Python使用BeautifulSoup解析京东商品数据实战

本文演示如何使用Python的BeautifulSoup库解析京东网页源码。通过构造包含keyword参数的搜索URL,利用urllib.quote进行编码,并解析HTML标签树提取商品名称、链接、图片及价格。文中特别指出处理空图片链接时使用get方法的技巧,对比正则表达式展示了BeautifulSoup的便捷性。
BeautifulSoup解析京东商品数据实战
本文将演示如何使用BeautifulSoup库实现京东商品信息的精准抓取。
HTML文档由尖括号定义的标签组成,标签间存在层级关系,构成标签树。Beautiful Soup库正是用于解析、遍历和维护这种“标签树”的功能库。
利用BeautifulSoup抓取京东网商品信息的具体步骤如下。
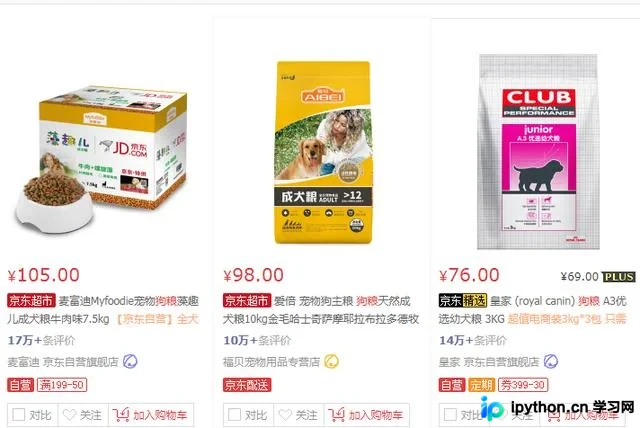
构建搜索URL与发起请求
首先访问京东网站,输入目标商品关键词并向服务器发送请求。以“狗粮”为例,生成的搜索URL为:https://search.jd.com/Search?keyword=%E7%8B%97%E7%B2%AE&enc=utf-8。该URL中的keyword参数对应输入的“狗粮”,经编码后生成目标URL。获取响应后,使用bs4选择器进行后续数据采集。
京东官网部分网页源码结构如下。
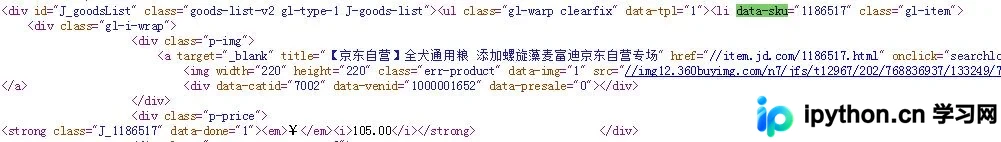
狗粮信息在京东官网上的网页源码
分析源码可知,目标信息存储于<li data-sku="*****" class="gl-item">标签内。接下来需逐层解析以提取所需数据。
源码解析与代码实现
具体实现代码如下。
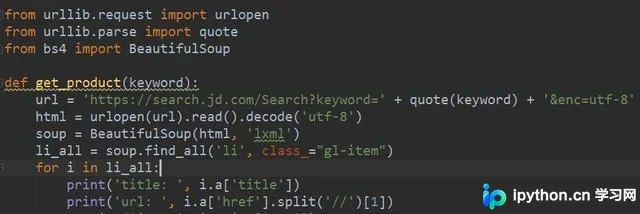
请求网页并获取源码
URL编码通常将字符转换为%xx格式,基于UTF-8标准,部分可能与浏览器平台相关。Python的urllib库提供了quote方法,可对URL字符串进行编码,从而访问对应网页。
随后使用BeautifulSoup提取商品名称、链接、图片和价格,具体代码见下图。
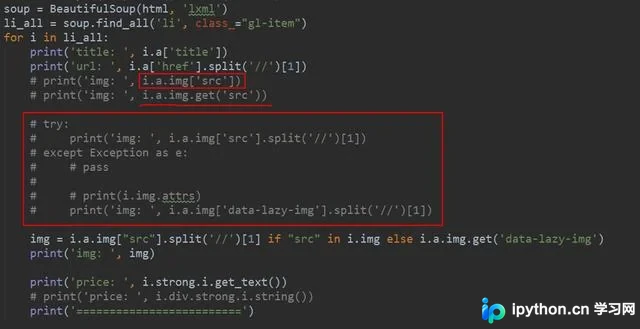
利用BeautifulSoup提取目标信息
异常处理与技巧总结
需注意部分图片链接可能为空。直接使用img['src']会因匹配不到值而报错,而使用get('src')若无匹配则返回None,不会报错。此外,也可通过try+except进行异常处理,匹配失败时pass。代码测速过程已在上述图中体现。使用get方法获取信息是bs4的一个实用技巧,建议读者掌握。
最终运行效果如下。
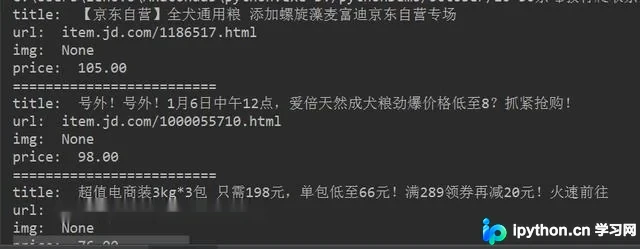
最终效果图
成功获取狗粮数据。
对比可见,利用BeautifulSoup获取目标信息比正则表达式更为简便。
本文内容仅供参考,希望能为读者提供有益帮助,欢迎支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















