


Python使用hdfs3模块操作HDFS详解

本文详细介绍如何使用Python的hdfs3模块替代命令行操作HDFS,实现更优雅的编程体验。内容涵盖文件读取与写入的基本用法、多节点高可用环境的配置方法,以及HDFileSystem提供的常用API列表,如文件复制、权限修改和目录遍历等,帮助开发者高效管理Hadoop分布式文件系统。
HDFS命令行与hdfs3模块对比
此前,我们通常依赖Hadoop命令行工具来执行HDFS相关操作,例如:
hdfs dfs -ls /user/spark/
hdfs dfs -get /user/spark/a.txt /home/spark/a.txt #从HDFS获取数据到本地
hdfs dfs -put -f /home/spark/a.txt /user/spark/a.txt #从本地覆盖式上传
hdfs dfs -mkdir -p /user/spark/home/datetime=20180817/
....
对于Python开发者而言,在代码中频繁调用系统命令来操作HDFS不仅代码冗长,而且从编程规范角度看并非最佳实践。为此,引入hdfs3模块可以显著提升代码的优雅性与可维护性:
hdfs3官方API文档地址:https://hdfs3.readthedocs.io/en/latest/api.html
>>> from hdfs3 import HDFileSystem
#链接HDFS
>>> hdfs = HDFileSystem(host='localhost', port=8020)
>>> hdfs.ls('/user/data')
>>> hdfs.put('local-file.txt', '/user/data/remote-file.txt')
>>> hdfs.cp('/user/data/file.txt', '/user2/data')
hdfs3基础操作:文件读写
文件读取示例
#txt文件全部读取
>>> with hdfs.open('/user/data/file.txt') as f:
...  data = f.read(1000000)
#使用pandas读取1000行数据
>>> with hdfs.open('/user/data/file.csv.gz') as f:
...  df = pandas.read_csv(f, compression='gzip', nrows=1000)
文件写入示例
>>> with hdfs.open('/tmp/myfile.txt', 'wb') as f: ... f.write(b'Hello, world!')
多节点环境配置
多节点连接配置
host = "nameservice1"
conf = {"dfs.nameservices": "nameservice1",
  "dfs.ha.namenodes.nameservice1": "namenode113,namenode188",
  "dfs.namenode.rpc-address.nameservice1.namenode113": "hostname_of_server1:8020",
  "dfs.namenode.rpc-address.nameservice1.namenode188": "hostname_of_server2:8020",
  "dfs.namenode.http-address.nameservice1.namenode188": "hostname_of_server1:50070",
  "dfs.namenode.http-address.nameservice1.namenode188": "hostname_of_server2:50070",
  "hadoop.security.authentication": "kerberos"
}
fs = HDFileSystem(host=host, pars=conf)
常用API功能详解
API参考
hdfs = HDFileSystem(host='127.0.0.1', port=8020)
hdfs.cancel_token(token=None) #未知,求大佬指点
hdfs.cat(path) #获取指定目录或文件的内容
hdfs.chmod(path, mode) #修改制定目录的操作权限
hdfs.chown(path, owner, group) #修改目录所有者,以及用户组
hdfs.concat(destination, paths) #将指定多个路径paths的文件,合并成一个文件写入到destination的路径,并删除源文件(The source files are deleted on successful completion.成功完成后将删除源文件。)
hdfs.connect() #连接到名称节点 这在启动时自动发生。 LZ:未知作用,按字面意思,应该是第一步HDFileSystem(host='127.0.0.1', port=8020)发生的
hdfs.delegate_token(user=None)
hdfs.df() #HDFS系统上使用/空闲的磁盘空间
hdfs.disconnect() #跟connect()相反,断开连接
hdfs.du(path, total=False, deep=False) #查看指定目录的文件大小,total是否把大小加起来一个总数,deep是否递归到子目录
hdfs.exists(path) #路径是否存在
hdfs.get(hdfs_path, local_path, blocksize=65536) #将HDFS文件复制到本地,blocksize设置一次读取的大小
hdfs.get_block_locations(path, start=0, length=0) #获取块的物理位置
hdfs.getmerge(path, filename, blocksize=65536) #获取制定目录下的所有文件,复制合并到本地文件
hdfs.glob(path) #/user/spark/abc-*.txt 获取与这个路径相匹配的路径列表
hdfs.head(path, size=1024) #获取指定路径下的文件头部分的数据
hdfs.info(path) #获取指定路径文件的信息
hdfs.isdir(path) #判断指定路径是否是一个文件夹
hdfs.isfile(path) #判断指定路径是否是一个文件
hdfs.list_encryption_zones() #获取所有加密区域的列表
hdfs.ls(path, detail=False) #返回指定路径下的文件路径,detail文件详细信息
hdfs.makedirs(path, mode=457) #创建文件目录类似 mkdir -p
hdfs.mkdir(path) #创建文件目录
hdfs.mv(path1, path2) #将path1移动到path2
open(path, mode='rb', replication=0, buff=0, block_size=0) #读取文件,类似于python的文件读取
hdfs.put(filename, path, chunk=65536, replication=0, block_size=0) #将本地的文件上传到,HDFS指定目录
hdfs.read_block(fn, offset, length, delimiter=None) #指定路径文件的offset指定读取字节的起始点,length读取长度,delimiter确保读取在分隔符bytestring上开始和停止
>>> hdfs.read_block('/data/file.csv', 0, 13)
b'Alice, 100\nBo'
>>> hdfs.read_block('/data/file.csv', 0, 13, delimiter=b'\n')
b'Alice, 100\nBob, 200'
hdfs.rm(path, recursive=True) #删除指定路径recursive是否递归删除
hdfs.tail(path, size=1024) #获取 文件最后一部分的数据
hdfs.touch(path) #创建一个空文件
hdfs.walk(path) #遍历文件树
HDFS批量创建文件夹与文件技巧
补充知识:HDFS命令行批量创建文件夹和文件的方法
批量创建测试文件夹的命令如下:
hadoop fs -mkdir -p /user/hivedata/temp/201912311001/d={27..30}/h={10..17}/m5={5,15,25}/
批量创建测试文件的命令如下:
hadoop fs -touchz /user/hivedata/temp/201912311001/d={27..30}/h={10..17}/m5={5,15,25}/{0..5}.orc
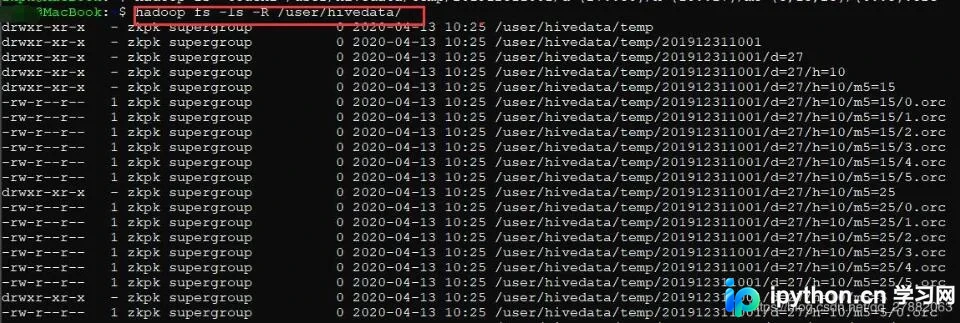
执行后的目录结构效果如下:
hadoop fs -ls -R /user/hivedata/
以上关于Python使用hdfs3模块操作HDFS的详解内容到此结束,希望能为读者提供有价值的参考,并欢迎大家继续支持本站获取更多技术分享。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















