


TensorFlow中高效实现LeakyReLU及其变体详解

本文详细介绍在TensorFlow中高效实现LeakyReLU的方法,通过替换abs()为tf.abs()优化代码。同时深入解析ReLU、Leaky ReLU、PReLU和RReLU四种激活函数的原理、公式及适用场景,对比它们在解决梯度消失和加速收敛方面的差异,为模型训练提供理论支持与实践参考。
TensorFlow中LeakyReLU的高效实现
该思路源自GitHub,展现了极具创意的实现方式,令人赞叹何时能写出如此精妙的代码。
原始教程地址:简易高效的LeakyReLu实现
具体代码实现如下:
我对原代码进行了适配改进,鉴于在TensorFlow环境中使用,将原有的abs()函数替换为tf.abs()以确保兼容性。
import tensorflow as tf
def LeakyRelu(x, leak=0.2, name="LeakyRelu"):
   with tf.variable_scope(name):
     f1 = 0.5 * (1 + leak)
     f2 = 0.5 * (1 - leak)
     return f1 * x + f2 * tf.abs(x) # 这里和原文有不一样的,我没试验过原文的代码,但tf.abs()肯定是对的
激活函数分类与优势分析
补充背景知识:激活函数主要分为饱和与非饱和两类。
常见的sigmoid和tanh属于“饱和激活函数”,而ReLU及其衍生版本则属于“非饱和激活函数”。
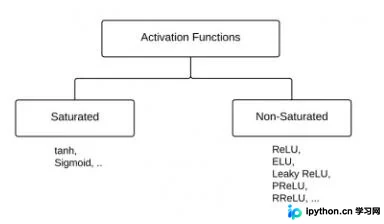
采用“非饱和激活函数”主要具备两大优势:
第一,能够有效缓解“梯度消失”问题。
第二,有助于加快模型的收敛速度。
Sigmoid函数负责将实值输入压缩至[0,1]区间。
其数学表达式为:σ(x) = 1 / (1 + exp(−x))
tanh函数则将实值输入压缩至[-1, 1]区间。
其数学表达式为:tanh(x) = 2σ(2x) − 1
主流激活函数详解:ReLU、ELU与Leaky ReLU
关于ReLU(修正线性单元)。
ReLU函数定义为输入x的最大值(x,0),即将矩阵x中所有负值置零,保持正值不变。该计算通常在卷积后进行,与tanh和sigmoid同属“非线性激活函数”,由Geoff Hinton首次提出。
关于ELUs(指数线性单元)。
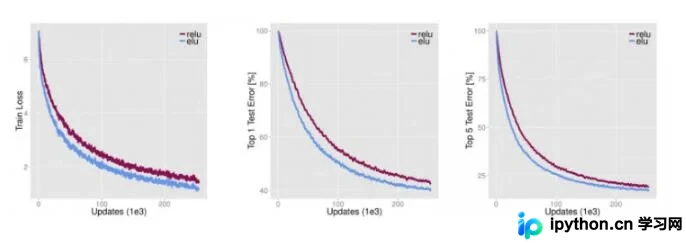
ELUs旨在使激活函数的平均值接近零,从而加速学习过程,并通过正值标识避免梯度消失。研究表明,ELUs在分类精度上往往优于ReLUs。
关于Leaky ReLUs。
与ReLU将所有负值置零不同,Leaky ReLU为所有负值赋予一个非零斜率。该激活函数最早在2013年的声学模型中提出,其数学表示为:
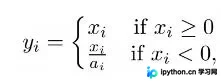
其中ai是区间(1,+∞)内的固定参数。
进阶变体:PReLU与RReLU机制
参数化修正线性单元(PReLU)。
PReLU可视为Leaky ReLU的变体,其负值部分的斜率由数据决定而非预设。作者指出,在ImageNet分类任务(2015,Russakovsky等)中,PReLU是超越人类分类水平的关键因素。
随机纠正线性单元(RReLU)。
RReLU同样是Leaky ReLU的变体,其负值斜率在训练阶段是随机的,而在测试阶段固定。RReLU的特点在于,训练中的aji是从均匀分布U(I,u)中随机抽取的数值,具体形式如下:
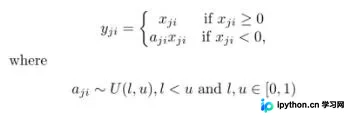
各类激活函数对比总结
总结对比。
下图展示了ReLU、Leaky ReLU、PReLU和RReLU的对比情况:
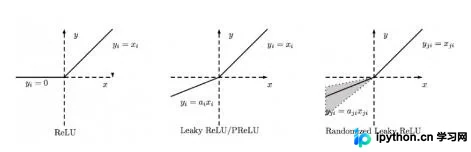
在PReLU中,ai根据数据动态变化;
在Leaky ReLU中,ai为固定值;
在RReLU中,aji是在给定范围内随机抽取的值,该值在测试环节固定下来。
以上就是在TensorFlow中实现leakyRelu操作的详细解析,希望能为读者提供参考,欢迎支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















