


JS能做什么:从前端交互到Node.js后端的应用场景

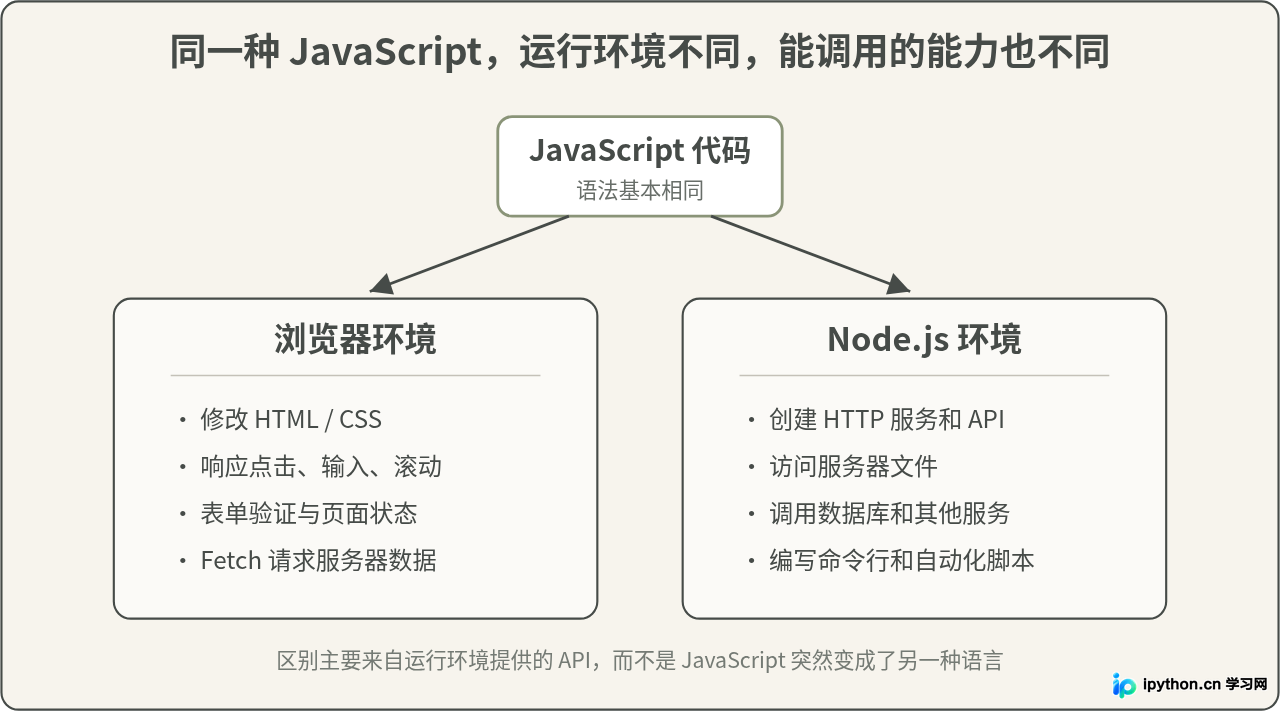
JavaScript,通常简称 JS,并不只是用来给网页添加按钮点击效果。运行在浏览器中时,它可以读取和修改页面内容、处理用户操作、校验表单、请求服务器数据;运行在 Node.js 中时,它又可以创建 HTTP 服务、编写接口、访问文件、连接数据库以及执行自动化脚本。理解 JS 能做什么,关键不是死记功能列表,而是先分清它运行在哪里,以及这个运行环境向它提供了哪些能力。
一、JS在浏览器中最常见的用途:让静态页面产生交互
如果网页只有 HTML 和 CSS,它依然可以展示文字、图片、表格和布局,但面对“用户点了一下以后怎么办”“输入内容以后如何即时检查”“不刷新页面怎样加载新数据”这类问题,就需要 JavaScript 参与。
浏览器中的 JS 可以通过 DOM,也就是文档对象模型,找到页面元素,读取它们的状态,然后修改文本、属性、样式或结构。这也是前端 JavaScript 最基础的一类用途。
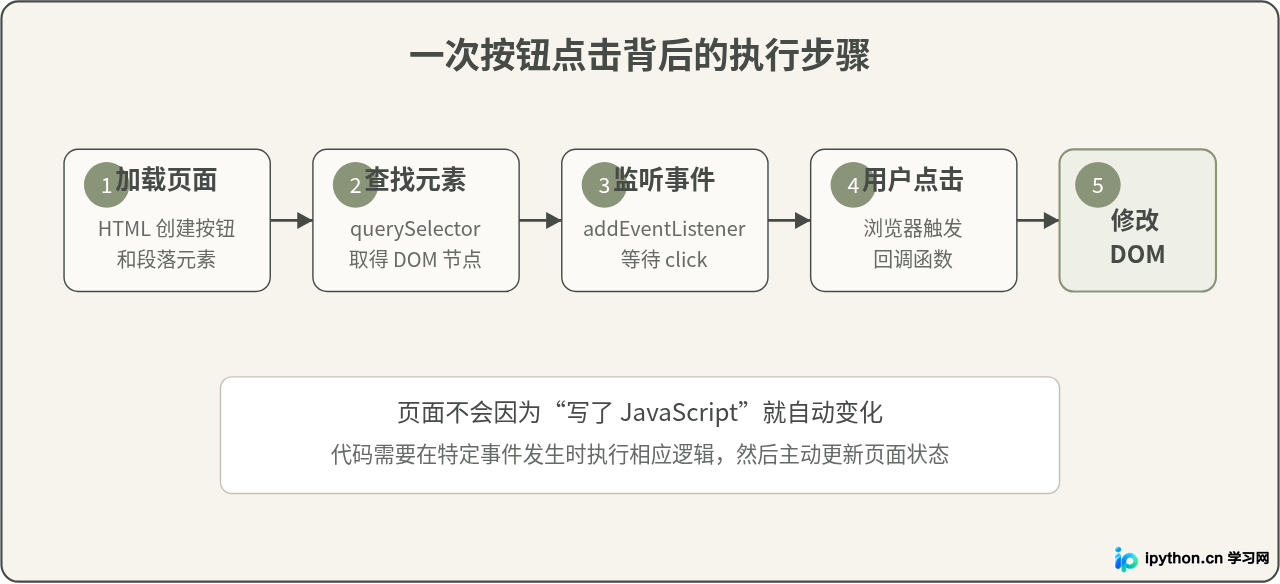
1. 点击按钮后修改页面内容
下面是一个可以直接保存为 index.html 并用浏览器打开的完整例子。用户点击按钮以后,JS 找到指定段落并修改其中的文字。
<!DOCTYPE html>
<html lang="zh-CN">
<head>
    <meta charset="UTF-8">
    <title>JavaScript 交互示例</title>
</head>
<body>
    <p id="message">这里的内容还没有改变。</p>
    <button id="changeButton">修改内容</button>

    <script>
        const button = document.querySelector('#changeButton');
        const message = document.querySelector('#message');

        button.addEventListener('click', function () {
            message.textContent = '按钮已经被点击,页面内容由 JavaScript 修改。';
        });
    </script>
</body>
</html>
这里的处理过程可以拆成三个动作:找到元素、监听事件、在事件发生后修改页面。以后遇到菜单展开、标签页切换、弹窗显示、图片预览等功能,本质上仍然会反复使用这个思路。
2. 根据用户输入即时更新页面
JS 还可以监听输入框内容变化。例如搜索建议、字数统计、密码强度提示和商品数量计算,都可以在用户输入时立即执行。
<input id="name" type="text" placeholder="请输入名字">
<p id="preview"></p>

<script>
    const nameInput = document.querySelector('#name');
    const preview = document.querySelector('#preview');

    nameInput.addEventListener('input', function () {
        preview.textContent = `你好,${nameInput.value}`;
    });
</script>
这里没有向服务器发送请求,所有逻辑都可以直接在浏览器里执行。如果只是控制页面显示状态,这通常已经足够。
二、JS可以处理表单,但前端校验不能代替后端校验
表单验证是 JavaScript 很典型的应用场景。提交注册表单之前,可以先检查邮箱有没有填写、密码长度是否满足要求、两次密码是否一致。这样能够在用户提交之前给出即时提示。
<form id="registerForm">
    <input id="username" type="text" placeholder="用户名">
    <button type="submit">注册</button>
</form>

<p id="errorMessage"></p>

<script>
    const form = document.querySelector('#registerForm');
    const username = document.querySelector('#username');
    const errorMessage = document.querySelector('#errorMessage');

    form.addEventListener('submit', function (event) {
        if (username.value.trim().length < 3) {
            event.preventDefault();
            errorMessage.textContent = '用户名至少需要 3 个字符。';
        }
    });
</script>
这里有一个容易混淆的说法:“既然 JS 已经在前端验证了数据,服务器就不需要再验证。”这只有在讨论用户体验时有一部分道理,因为前端校验确实可以减少明显错误。
但从数据可靠性和安全角度看,这个结论不成立。浏览器端代码运行在用户设备上,客户端请求也可以绕过网页直接构造,所以后端仍然必须验证收到的数据。比较合理的分工是:前端验证用于快速提示,后端验证负责最终判断。
三、JS可以在不刷新整个页面的情况下请求服务器数据
现代网页中的 JavaScript 经常需要和服务器通信。浏览器提供的 fetch() 可以发起 HTTP 请求,获取 JSON、文本或其他数据,然后根据结果更新当前页面。
假设服务器提供一个 /api/user 接口,返回如下 JSON:
{
    "name": "张明",
    "level": "普通用户"
}
浏览器端可以这样读取:
async function loadUser() {
    const response = await fetch('/api/user');

    if (!response.ok) {
        throw new Error(`请求失败:${response.status}`);
    }

    const user = await response.json();

    document.querySelector('#userName').textContent = user.name;
    document.querySelector('#userLevel').textContent = user.level;
}

loadUser().catch(function (error) {
    console.error(error);
});
这类方式适合用户中心、评论加载、商品列表、搜索结果、消息提醒等需要动态获取服务器数据的页面。页面不必为了更新一小块内容而重新加载整个 HTML。
fetch() 这一行代码决定的,服务器返回的响应头同样重要。
四、JS还能在浏览器中管理页面状态和复杂应用
当页面交互增加以后,JS 的任务会从简单的“点一下改文字”发展为管理整套页面状态。例如一个购物车页面可能需要同时记录商品、数量、价格、勾选状态和总金额。
const cart = [
    { name: '键盘', price: 299, quantity: 1 },
    { name: '鼠标', price: 159, quantity: 2 }
];

const total = cart.reduce(function (sum, item) {
    return sum + item.price * item.quantity;
}, 0);

console.log(total);
示例输出:
这里展示的是 JavaScript 本身处理数据的能力。真正的购物车还需要把计算结果显示在页面上,必要时再与服务器同步。React、Vue 等前端框架可以帮助组织复杂界面,但“JS 只能依靠框架才能开发网页”并不准确。框架底层依然建立在 JavaScript 和浏览器提供的能力之上。
五、Node.js让JavaScript离开浏览器运行
浏览器并不是 JavaScript 唯一的运行环境。Node.js 可以在浏览器之外执行 JavaScript,因此同一种语言可以继续承担服务器端、命令行和自动化任务。
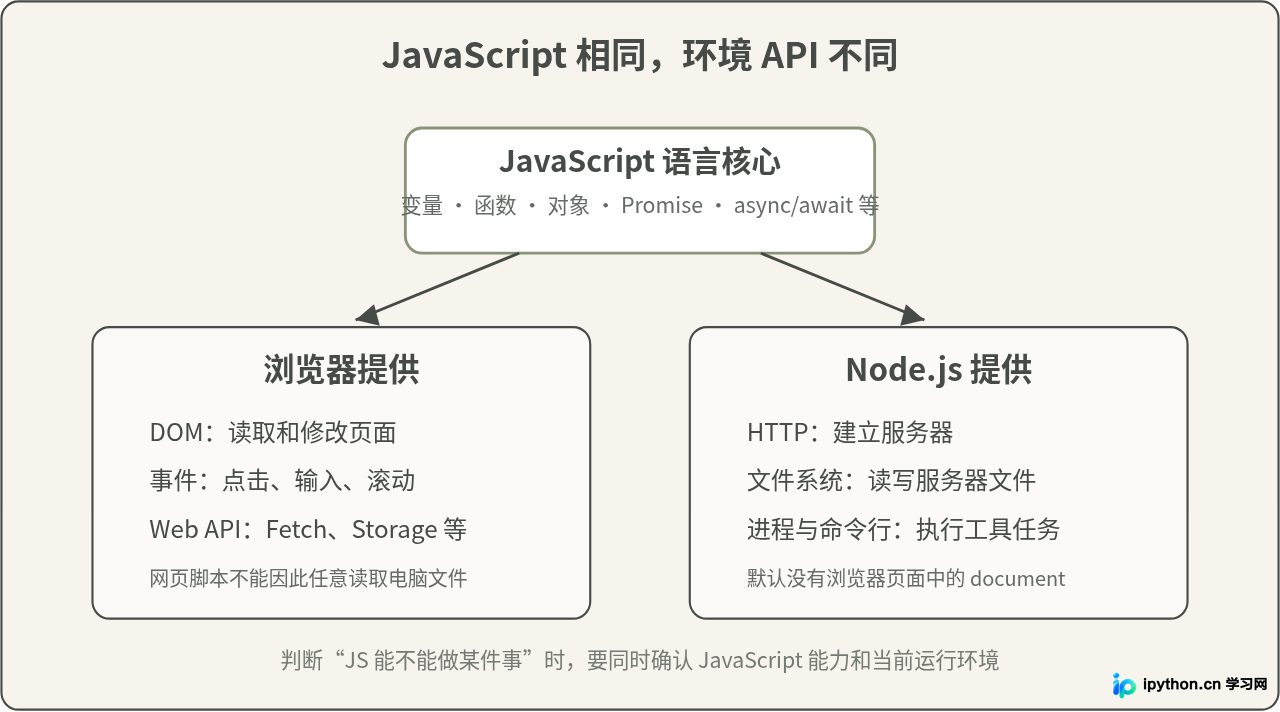
这里需要区分两个概念:JavaScript 是语言,Node.js 是 JavaScript 的一种运行环境。类似 document.querySelector() 这样的 DOM API 由浏览器提供,因此普通 Node.js 程序中并不存在 document;反过来,Node.js 提供的文件系统等服务器能力,也不是普通网页脚本可以随意使用的。
六、使用Node.js创建一个最简单的后端接口
Node.js 的典型用途之一是创建 Web 服务。下面不依赖第三方框架,只使用 Node.js 自带的 node:http 模块创建一个可以访问的接口。
在已经安装 Node.js 的环境中新建 server.js:
const http = require('node:http');

const server = http.createServer(function (request, response) {
    if (request.url === '/api/user' && request.method === 'GET') {
        const user = {
            name: '张明',
            level: '普通用户'
        };

        response.writeHead(200, {
            'Content-Type': 'application/json; charset=utf-8'
        });

        response.end(JSON.stringify(user));
        return;
    }

    response.writeHead(404, {
        'Content-Type': 'text/plain; charset=utf-8'
    });

    response.end('Not Found');
});

server.listen(3000, function () {
    console.log('Server running at http://localhost:3000');
});
在终端进入 server.js 所在目录,然后执行:
node server.js示例输出:
此时访问 http://localhost:3000/api/user,服务器会返回:
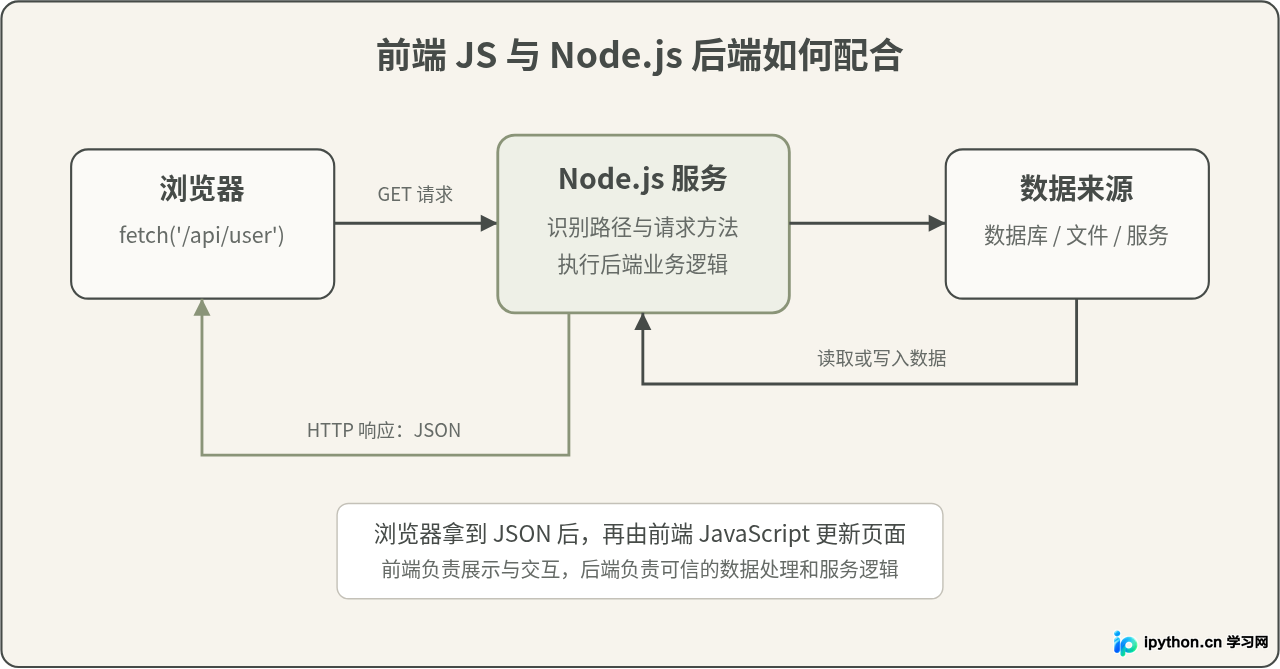
{"name":"张明","level":"普通用户"}这个例子虽然很小,却已经包含后端服务的核心流程:客户端发送 HTTP 请求,Node.js 判断请求路径和方法,执行服务器端逻辑,然后产生 HTTP 响应。
七、Node.js后端不只是返回一段JSON
真实项目中的 Node.js 后端通常还会承担更多工作。HTTP 请求只是入口,收到请求之后还可能进行参数检查、权限判断、数据库操作和第三方服务调用。
1. 编写REST API或其他HTTP接口
例如一个文章系统可能提供这些接口:
GET /api/articles:读取文章列表;GET /api/articles/100:读取编号为 100 的文章;POST /api/articles:创建文章;PUT /api/articles/100:修改文章;DELETE /api/articles/100:删除文章。
Node.js 可以接收这些请求,再根据业务规则决定如何处理。实际项目通常会使用成熟的 Web 框架和数据库驱动来组织代码,而不是把全部路径判断堆在一个文件里。
2. 连接数据库
Node.js 程序可以通过对应的驱动或客户端库访问 MySQL、PostgreSQL、Redis、MongoDB 等数据服务。浏览器一般不会直接连接业务数据库,而是请求后端接口,再由后端根据用户身份和权限处理数据库操作。
一个典型流程是:
- 浏览器提交登录信息;
- Node.js 后端验证参数;
- 后端查询用户数据;
- 验证身份后生成相应会话或凭据;
- 把允许返回的结果发送给浏览器。
这也是为什么“前端已经有 JS,所以让前端直接连接数据库更简单”看起来很方便,实际却通常不适合作为普通 Web 系统的架构。数据库账号和核心权限不能依赖浏览器端代码保密,数据访问也需要由可信的服务器端进行控制。
3. 读写服务器文件
Node.js 可以使用文件系统 API 读取和写入服务器上的文件。例如下面的程序读取当前目录中的 config.json:
const fs = require('node:fs/promises');

async function readConfig() {
    const content = await fs.readFile('./config.json', 'utf8');
    const config = JSON.parse(content);

    console.log(config);
}

readConfig().catch(console.error);
这类能力可以用于配置读取、日志处理、静态文件生成和构建工具。但文件路径、访问权限以及输入内容都需要谨慎处理,尤其不能把用户提交的任意路径直接交给文件读取接口。
八、Node.js也适合写命令行和自动化脚本
JS 进入 Node.js 后并不一定要开发网站。它还可以像其他脚本语言一样处理本地任务,例如批量修改文件、分析 JSON、调用接口、生成静态页面或者编写项目构建工具。
例如目录中有一组文件,希望列出所有以 .js 结尾的文件,可以写:
const fs = require('node:fs/promises');

async function listJavaScriptFiles() {
    const files = await fs.readdir('./');

    const jsFiles = files.filter(function (file) {
        return file.endsWith('.js');
    });

    console.log(jsFiles);
}

listJavaScriptFiles().catch(console.error);
因此,如果一个任务的核心是“读取一些数据 → 按规则处理 → 输出结果”,Node.js 同样可以胜任,不要求这个任务一定与网页有关。
九、前端JavaScript和Node.js后端应该如何分工
当一个项目同时使用浏览器 JavaScript 和 Node.js 时,可以用一个简单原则判断代码应该放在哪里:和页面展示、即时交互有关的逻辑主要放前端;必须可信执行、涉及核心数据和服务器资源的逻辑放后端。
| 需求 | 通常执行位置 | 原因 |
|---|---|---|
| 点击按钮展开菜单 | 浏览器前端 | 属于当前页面交互,不必请求服务器 |
| 输入密码时提示格式 | 浏览器前端 | 可以即时给用户反馈 |
| 判断登录密码是否正确 | 后端 | 最终身份验证不能信任客户端自行判断 |
| 从数据库读取文章 | 后端 | 数据库连接和数据权限需要在服务器控制 |
| 把接口返回的文章显示到页面 | 浏览器前端 | 属于数据展示和界面更新 |
| 批量读取服务器目录中的文件 | Node.js | 需要服务器或本地文件系统能力 |
十、几个关于“JS能做什么”的常见混淆
JavaScript是不是只能做网页?
不是。它最广为人知的运行环境是浏览器,但借助 Node.js 等运行环境,JavaScript 也可以运行在服务器和命令行环境中。因此,“JavaScript 是网页脚本语言”可以帮助初学者理解它的常见用途,但如果把它理解为“只能在网页中运行”,范围就过窄了。
用了Node.js以后,前端和后端代码是不是完全一样?
语法可以高度一致,但可用 API 和代码职责并不相同。浏览器代码常见 document、DOM 事件和页面元素;Node.js 后端更常接触 HTTP、文件系统、数据库和服务器环境变量。
例如下面的代码依赖浏览器 DOM:
document.querySelector('#title').textContent = '新的标题';而下面的代码依赖 Node.js 文件系统:
const fs = require('node:fs');
const content = fs.readFileSync('./data.txt', 'utf8');
它们都使用 JavaScript 语法,但不能因此认为运行环境可以直接互换。
Node.js能不能完全替代其他后端语言?
Node.js 能够开发很多类型的后端服务,但“能实现”不等于所有项目都应该使用同一种技术。现有团队技术栈、第三方库、部署环境、性能特征和已有系统都可能影响选择。理解 JS 的应用范围,重点在于知道 Node.js 让 JavaScript 具备了开发后端系统的条件,而不是把它理解为其他后端技术都失去用途。
十一、把JS的应用场景连起来理解
初学 JavaScript 时,不必把 DOM、Fetch、Node.js、HTTP、数据库看成彼此无关的知识点。可以按照一个完整 Web 应用的数据流来理解它们:
- 用户在网页上点击按钮或填写内容;
- 浏览器中的 JavaScript 捕获事件;
- 需要服务器数据时,通过 HTTP 发起请求;
- Node.js 接收请求并执行后端逻辑;
- 后端根据需要读取数据库、文件或其他服务;
- Node.js 把处理结果以 JSON 等形式返回;
- 浏览器中的 JavaScript 读取结果并更新 DOM;
- 用户在当前页面看到新的内容。
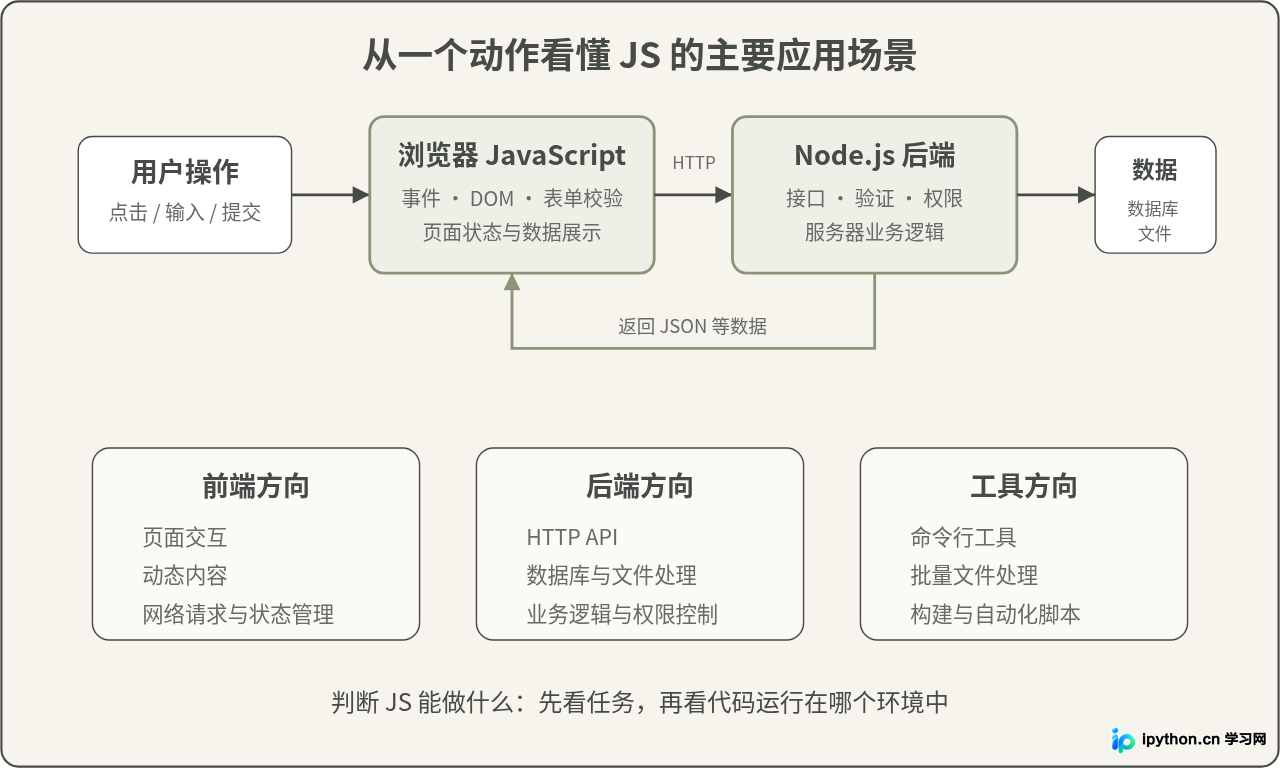
总结
JS 能做的事情远不止网页上的按钮动画。运行在浏览器里,它主要负责页面交互、DOM 操作、表单即时验证、状态管理以及向服务器请求数据;运行在 Node.js 中,它可以创建 HTTP 服务、开发后端接口、处理数据库和文件,并承担命令行与自动化任务。
真正需要掌握的不是一张不断扩大的“JavaScript 功能列表”,而是运行环境这个判断方法。遇到一个新需求时,可以先问两个问题:这段代码准备运行在浏览器还是 Node.js 中?当前环境有没有提供完成这个任务所需的 API?弄清这两点以后,很多“JS 到底能不能做”的问题都会变得清楚。
如果从学习顺序来看,可以先掌握变量、函数、数组、对象和异步操作等 JavaScript 基础,再练习 DOM 与事件,接着学习 fetch() 和 HTTP 请求。理解浏览器端的数据流以后,再进入 Node.js 的 HTTP、文件系统、接口开发和数据库操作,会更容易把前端与后端连接成一套完整的 Web 应用。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















