


Django在线创建索引:零停机迁移实战指南

本文详解如何在Django中实现数据库索引的在线创建,确保生产环境零停机。通过解析Django迁移机制,介绍使用RunSQL执行CONCURRENTLY语句及SeparateDatabaseAndState分离状态与数据库操作的高级技巧,解决大表索引创建时的锁表问题。
Django在线创建索引:零停机迁移实战指南
Django框架在管理数据库结构变更方面表现卓越,但其提供的灵活性存在一定边界。为了深入理解Django迁移机制的局限,我们将探讨一个经典场景:如何在保持服务不间断的前提下,在Django项目中创建数据库索引。
通过本教程,你将掌握以下核心技能:
理解Django生成新迁移文件的触发机制与时机;
学会检查Django生成的迁移命令及其实际执行逻辑;
掌握安全修改迁移文件以满足特定生产需求的方法。
本教程定位为中级难度,预设读者已具备Django迁移(Migration)的基础知识。
Django迁移中创建索引的挑战
Django迁移中创建索引的挑战
随着应用数据量的增长,添加索引是提升性能的常见手段。索引能显著加速查询速度,使应用程序运行更加流畅且响应迅速。
然而,在大多数传统数据库系统中,添加索引需要对目标表施加独占锁。在索引构建期间,这种独占锁会阻止所有数据修改操作(DML),包括UPDATE、INSERT和DELETE。
数据库在执行某些操作时会隐式获取锁。例如,当用户登录应用时,Django会更新auth_user表中的last_login字段。执行此更新前,数据库需在该行获取锁。若该行已被其他连接锁定,系统将抛出数据库异常。
在迁移期间若需保持系统高可用,表锁定将引发严重问题。表体积越大,创建索引耗时越长,系统不可用或用户无响应的窗口期也相应延长。
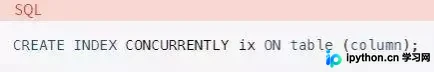
部分数据库厂商提供了无需锁定表即可创建索引的方案。例如,在PostgreSQL中,可通过CONCURRENTLY关键字实现非阻塞索引创建:
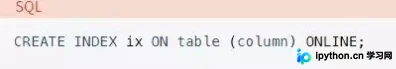
在Oracle数据库中,ONLINE选项允许在创建索引的同时执行DML操作:
遗憾的是,Django在自动生成迁移时并未使用这些特殊关键字。若直接运行默认生成的迁移,数据库仍会获取表上的独占锁,并阻止DML操作,导致潜在的服务中断。
并发创建索引存在特定注意事项。提前了解数据库后端的特性至关重要。例如,PostgreSQL中并发创建索引耗时更长,因为它需要执行额外的表扫描操作。
在本教程中,我们将演示如何利用Django迁移机制,在大型数据表上创建索引,同时确保系统全程无停机。
前置要求:建议使用PostgreSQL作为数据库后端,Django 2.x版本及Python 3环境。
当然,其他数据库后端也可使用。遇到PostgreSQL特有SQL语法时,请根据所用数据库后端的语法进行相应调整。
环境设置与问题复现
环境设置
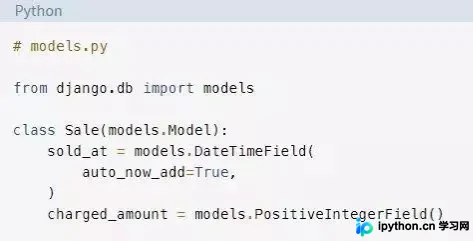
我们将在一个名为app的应用中使用一个虚构的Sale模型。在真实场景中,Sale这类模型通常对应数据库中的主表,数据量巨大:
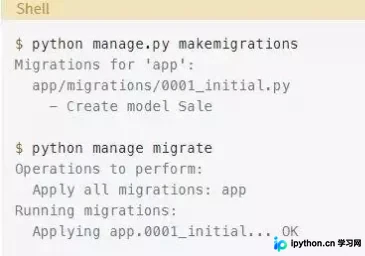
创建数据表,生成初始迁移文件并应用该迁移:
一段时间后,sales表数据量激增,用户反馈查询速度缓慢。通过监控数据库,你发现大量查询涉及sold_at列。为提升性能,决定为该列添加索引。
为实现这一目标,需对模型进行如下修改:
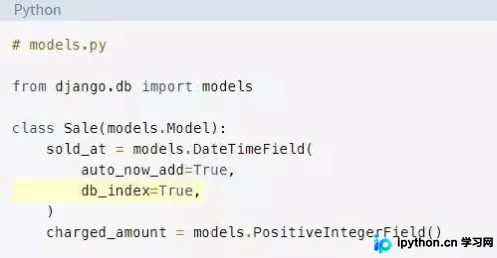
若直接运行此迁移,Django将在表上创建索引并施加独占锁,直至索引构建完成。对于超大表,这一过程可能耗时良久,我们必须避免服务停机。
在本地开发环境中,由于数据集小且并发连接少,此迁移可能瞬间完成。但在生产环境中,面对海量数据和高并发连接,获取锁及创建索引的过程可能持续较长时间。
接下来的步骤中,我们将修改Django自动生成的迁移文件,以实现无停机的索引创建。
方法一:伪造迁移(Fake Migration)
方法一:伪造迁移(Fake Migration)
第一种方案是手动创建索引。我们将生成迁移文件,但不让Django自动应用它。相反,我们直接在数据库中执行SQL语句,然后告知Django迁移已执行完毕。
首先,生成迁移文件:
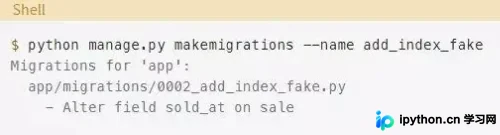
使用sqlmigrate命令查看Django计划执行的SQL语句:
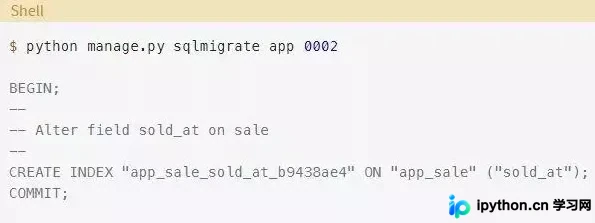
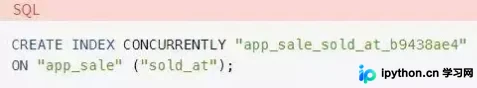
由于我们需要非阻塞创建索引,需修改该命令。添加CONCURRENTLY关键字后,在数据库中手动执行:
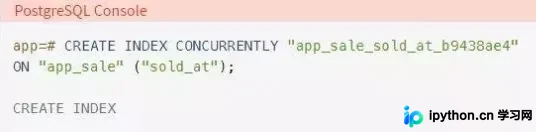
注意,执行过程中未出现BEGIN和COMMIT语句。省略这些关键字意味着命令将在非事务环境下执行。关于数据库事务的更多细节,我们将在后文讨论。
执行完毕后,若尝试应用迁移,将收到如下错误提示:
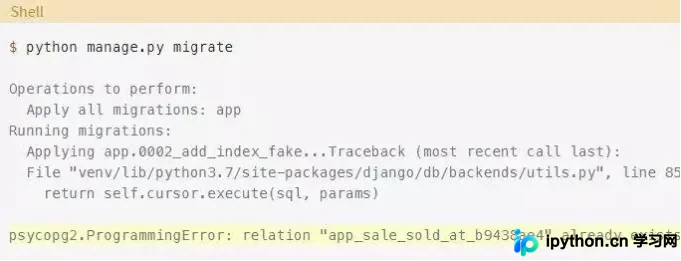
Django提示索引已存在,无法继续迁移。这是因为我们已在数据库中直接创建了索引,现在需让Django认可该迁移已执行。
如何伪造迁移
Django提供了内置机制,可将迁移标记为已执行而无需实际运行。使用此选项时,需在应用迁移时添加—fake标志:
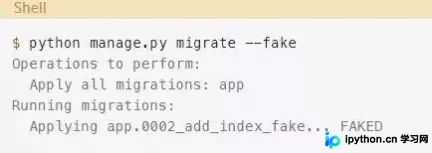
此次Django未报错。实际上,Django并未应用任何迁移,仅将其状态标记为已执行(FAKED)。
伪造迁移时需考虑以下问题:
手动命令必须与Django生成的SQL等价:需确保执行的命令与Django生成的SQL完全一致。利用sqlmigrate生成参考SQL。若命令不匹配,可能导致数据库状态与模型状态不一致。
其他未应用的迁移也将被伪造:若存在多个未应用迁移,它们均会被标记为已执行。在应用迁移前,务必确保仅目标迁移未被应用,否则可能导致结果不一致。也可指定具体要伪造的迁移文件。
需要直接访问数据库:此方法要求直接在数据库中运行SQL,这在某些场景下并非必要。此外,在生产数据库中直接执行命令存在风险,应尽量避免。
自动化部署流程可能需要调整:若使用CI/CD等自动化工具,需修改部署流程以支持伪迁移。这并非总是理想方案。
清理环境
在继续下一节前,需将数据库恢复至初始迁移后的状态。执行以下迁移回滚至初始状态:
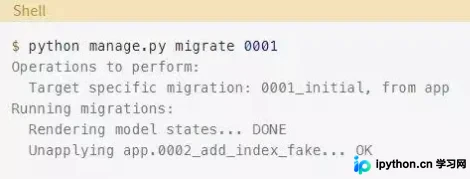
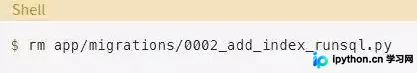
由于Django未应用第二次迁移的更改,现在可安全删除该迁移文件:
为确保操作无误,检查迁移状态:
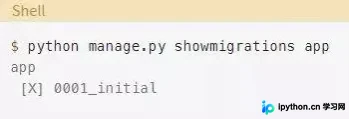
初始迁移应用后,系统中已无未应用的迁移文件。
方法二:在迁移中执行原始SQL
方法二:在迁移中执行原始SQL
上一节中,我们直接在数据库执行SQL并伪造迁移,虽完成任务但非最佳实践。
Django提供了RunSQL操作,允许在迁移中执行原始SQL。让我们尝试使用此方法替代直接数据库操作。
首先,生成一个新的空迁移:
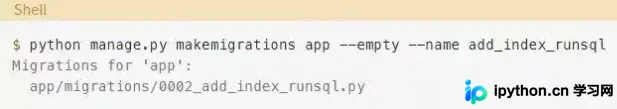
接下来,编辑迁移文件并添加RunSQL操作:
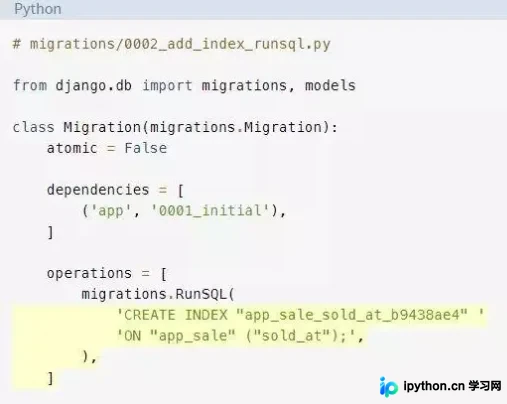
运行迁移时,将看到以下输出:
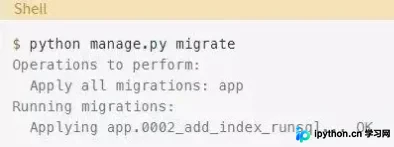
看似正常,但存在一个问题。再次尝试生成迁移:
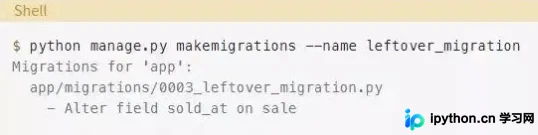
Django再次生成了相同的迁移。原因何在?
清理环境
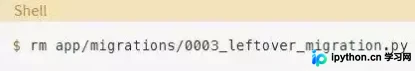
在解答上述问题前,需清理并撤销对数据库的更改。首先删除最后一次迁移。因该迁移未被应用,可安全删除:
接下来,列出app应用的迁移文件:
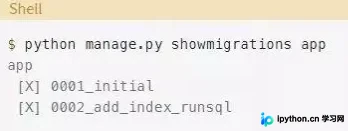
第三次迁移已存在,但仅应用了第二次迁移。我们希望回到初始迁移后的状态。尝试如上一节所示回滚至初始状态:
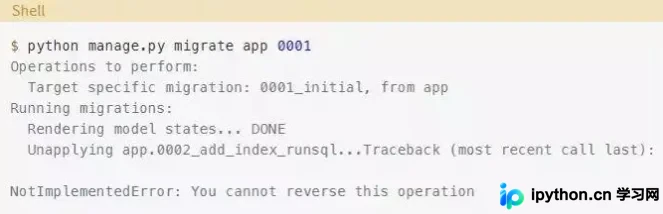
Django无法执行逆向迁移。
逆向迁移操作
执行逆向迁移时,Django会对每个操作执行相反动作。本例中,添加索引的反面是删除索引。正如前文所述,当迁移可逆时,可取消应用。如同Git中的checkout,对较早迁移执行migrate命令即可进行逆向迁移。
许多内置迁移操作已定义反向操作。例如,添加字段的反向是删除对应列,创建模型的反向是删除相应表。
部分迁移操作不可逆。例如,删除字段或模型无反向操作,因为迁移应用后数据即消失。
上一节使用了RunSQL操作。尝试逆向迁移时遇到错误,提示某操作不可逆。Django默认无法反转原始SQL,因其不知晓该操作的具体内容,故无法自动生成反向操作。
如何使迁移可逆
如何使迁移可逆
要使迁移可逆,其中所有操作必须可逆。仅逆转部分迁移是不可能的,单个不可逆操作将使整个迁移不可逆。
要使RunSQL操作可逆,需提供反转时执行的SQL。反向SQL通过reverse_sql参数提供。
添加索引的反面是删除索引。为使迁移可逆,请提供reverse_sql参数以删除索引:
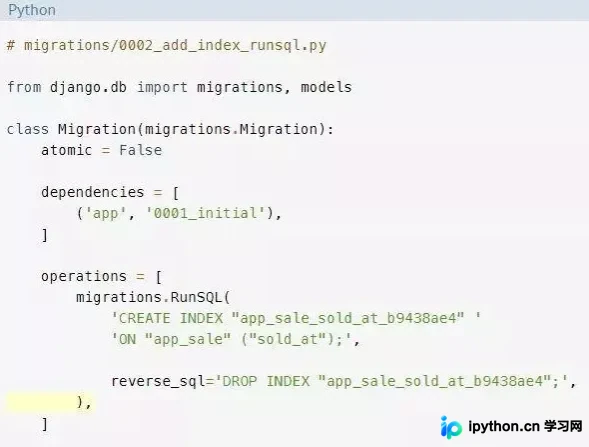
现在尝试反转迁移:
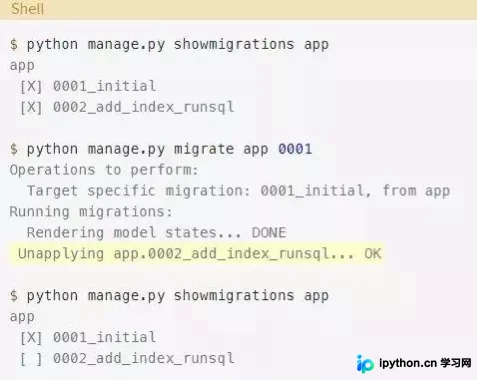
我们对第二次迁移进行了反转,Django删除了索引。现在可安全删除迁移文件:
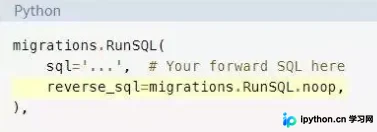
始终提供reverse_sql是良好实践。若反转原始SQL操作无需其他动作,可使用特殊哨兵语句migrations.noop。
RunSQL.noop将该操作标记为可逆。
理解模型状态与数据库状态
理解模型状态与数据库状态
在前文尝试使用RunSQL手动创建索引时,Django反复生成相同迁移,尽管索引已在数据库中创建。要理解Django的行为,需先了解其生成新迁移的决策机制。
Django何时生成新迁移
在生成和应用迁移过程中,Django同步数据库状态与模型状态。例如,向模型添加字段时,Django向表添加列;从模型删除字段时,Django从表删除列。
为实现模型与数据库同步,Django维护表示模型状态的对象。为使数据库与模型同步,Django生成迁移操作。迁移操作转换为特定供应商可执行的SQL。所有迁移操作执行完毕后,数据库与模型应保持一致。
为获取数据库状态,Django聚合所有历史迁移操作。当聚合状态与模型状态不一致时,Django生成新迁移。
前例中,你使用原始SQL创建索引。因未使用标准迁移操作,Django无法知晓索引已创建。
当Django聚合所有迁移并与模型状态比较时,发现缺少索引。因此,即使手动创建了索引,Django仍认为其缺失并生成新迁移。
如何在迁移中分离数据库与状态
如何在迁移中分离数据库与状态
因Django无法按预期方式创建索引,需提供自定义SQL,同时告知Django索引已创建。
换言之,需在数据库中执行操作,并为Django提供迁移操作以同步其内部状态。为此,Django提供了SeparateDatabaseAndState特殊迁移操作。此操作鲜为人知,仅建议在特殊场景下使用。
编辑迁移比从头编写更容易。首先以常规方式生成迁移:
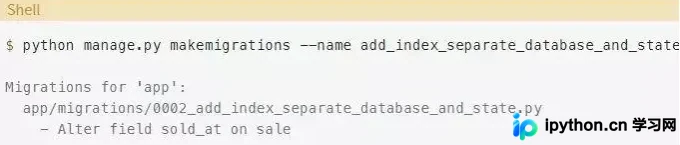
这是Django生成的迁移内容,与前例相同:
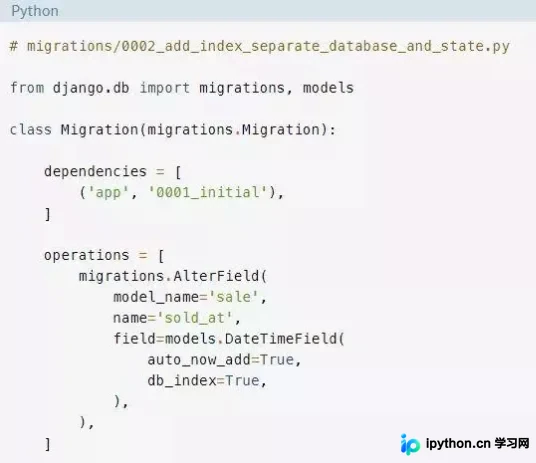
Django在字段sold_at上生成了AlterField操作。该操作创建索引并更新状态。我们希望保留此操作,但在数据库中提供不同命令执行。
同样,获取该命令可使用Django生成的SQL:
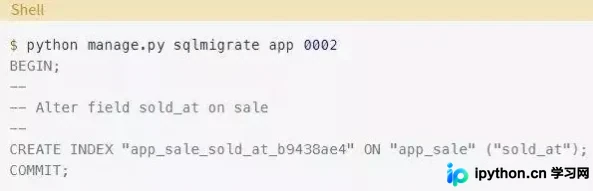
在合适位置添加CONCURRENTLY关键字:
接着,编辑迁移文件,使用SeparateDatabaseAndState提供修改后的SQL命令并执行:
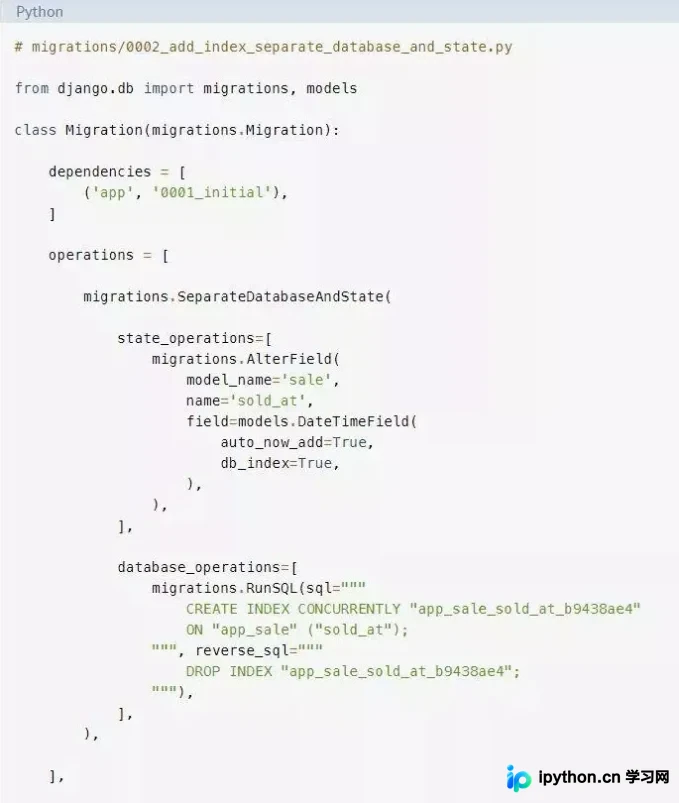
迁移操作SeparateDatabaseAndState接受两个操作列表:
1. state_operations:应用于内部模型状态的操作,不影响数据库。
2. database_operations:应用于数据库的操作。
我们在state_operations中保留了Django生成的原始操作。使用SeparateDatabaseAndState时,通常应如此操作,注意向字段提供db_index=True参数。此迁移操作将告知Django字段上存在索引。
我们使用了Django生成的SQL并添加了CONCURRENTLY关键字。通过特殊操作RunSQL在迁移中执行原始SQL。
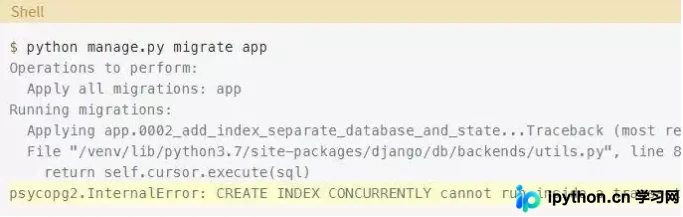
若尝试运行此迁移,将看到以下输出:
非原子迁移处理
非原子迁移
在SQL中,CREATE、DROP、ALTER和TRUNCATE操作称为数据定义语言(DDL)。在支持事务性DDL的数据库(如PostgreSQL)中,Django默认在数据库事务中执行迁移。然而,根据上述错误,PostgreSQL不能在事务块中并发创建索引。
为在迁移中并发创建索引,需告知Django不要在数据库事务中执行迁移。通过将atomic设置为False,将迁移标记为非原子(non-atomic):
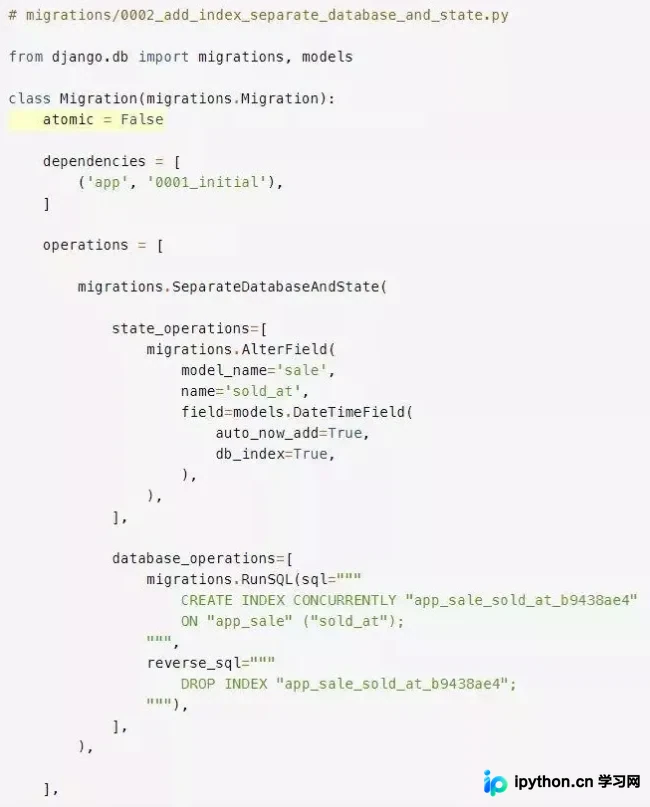
将迁移标记为非原子后,即可运行迁移:
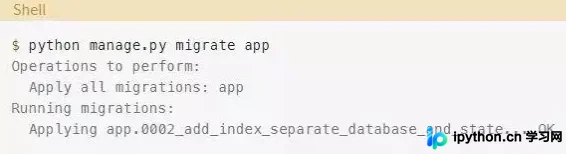
你刚刚执行了迁移,且未引起任何停机。
使用SeparateDatabaseAndState时的注意事项
数据库操作必须与状态操作等价:数据库与模型状态不一致可能引发诸多问题。良好开端是保留Django在state_operations中生成的操作,并编辑sqlmigrate输出用于database_operations。
非原子迁移在发生错误时不能回滚:若迁移过程中出错,无法回滚。必须手动回滚迁移或完成它。保持非原子迁移中执行的操作最小化是明智之举。若迁移中有其他操作,请将其移至新迁移中。
迁移可能是特定于供应商的:Django生成的SQL针对项目中使用的数据库后端。在其他后端运行可能有效,但不保证。若需支持多个数据库后端,需对此方法进行适当调整。
总结与最佳实践
总结
本教程从大型数据表和问题入手。我们希望应用对用户更快,且在不引起停机的情况下实现这一目标。
教程结束时,我们尝试生成并安全修改Django迁移以实现目标。在此过程中,我们遇到不同问题,并利用migration框架提供的内置工具成功解决。
本教程中,你学习了以下内容:
- Django迁移内部如何利用模型和数据库状态工作,以及何时生成新迁移;
- 如何使用RunSQL操作在迁移中执行自定义SQL;
- 什么是可逆迁移,以及如何使RunSQL操作可逆;
- 什么是原子迁移,以及如何根据需要更改默认行为;
- 如何在Django中安全执行复杂迁移。
模型与数据库状态的分离是重要概念。理解并掌握其用法后,你可突破内置迁移操作的许多限制。想到的用例包括添加已在数据库中创建的索引,以及为DDL命令提供特定供应商参数。
到此这篇关于Django如何在不停机的情况下创建索引的文章就介绍到这了,更多相关不停机状态下使用Django创建索引内容请搜索本站以前的文章或继续浏览下面的相关文章,希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















