


Python学了能干嘛?5大核心就业方向与岗位薪资前景

掌握Python语法并不等于拥有求职竞争力。很多初学者学完了基本的数据类型、循环和面向对象,却发现面对企业招聘需求依然无从投递。Python本质上是一门通用胶水语言,它的实际商业价值完全取决于你绑定的应用领域。本文将直接拆解Python目前最核心的5大就业方向、对应的技术栈壁垒、真实的岗位薪资分级以及从零到就业的学习落地路径。
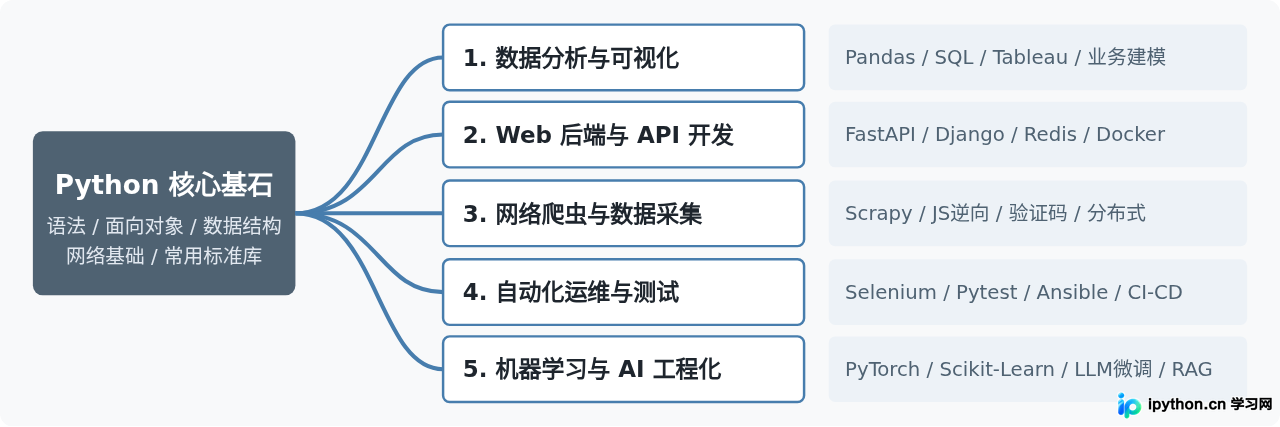
方向一:数据分析与商业智能(BI)
数据分析是目前非计算机专业和跨专业求职者选择最多的方向。企业每天产生海量业务数据,需要有人将其转化为管理决策依据。该岗位并不单纯写代码,核心是用代码提取、清洗和验证商业指标。
1. 核心技术栈要求
- 数据清洗与统计:必须熟练运用
pandas和numpy。掌握缺失值填充、分组聚合(GroupBy)、透视表与时间序列处理。 - 底层数据库:精通 SQL(MySQL/PostgreSQL/ClickHouse)。绝大部分商业场景中,数据首先存放在数仓或数据库中,SQL 是获取数据的前提。
- 图表呈现:使用
Matplotlib、Seaborn输出探索性分析图,或结合 BI 工具(Tableau、Power BI、FineBI)搭建自动刷新看板。
2. 代码场景示例:电商用户行为漏斗转化计算
以下示例演示如何用 pandas 计算不同业务流程的流失率,这是数据分析岗位的常规日常操作:
import pandas as pd

# 模拟原始访问与转化数据
data = {
    'user_id': [101, 102, 103, 104, 105],
    'view_item': [1, 1, 1, 1, 1],
    'add_cart': [1, 1, 0, 1, 0],
    'pay_order': [1, 0, 0, 1, 0]
}

df = pd.DataFrame(data)

# 汇总各环节独立用户量
views = df['view_item'].sum()
carts = df['add_cart'].sum()
pays = df['pay_order'].sum()

print(f"浏览用户数: {views}")
print(f"加购用户数: {carts} (加购转化率: {carts/views:.1%})")
print(f"成交用户数: {pays} (支付转化率: {pays/carts:.1%})")
# 示例输出:
# 浏览用户数: 5
# 加购用户数: 3 (加购转化率: 60.0%)
# 成交用户数: 2 (支付转化率: 66.7%)
方向二:Web 后端与微服务 API 开发
尽管在中大型互联网企业中 Java 占据主导地位,但凭借开发速度极快、生态丰富的特点,Python 在中小型产品研发、海外软件团队、快速原型验证以及 AI 模型服务部署中占据不可替代的地位。
1. 核心技术栈要求
- 主流框架:目前首选为异步高性能框架
FastAPI,中大型管理后台依然常用Django,轻量微服务常用Flask。 - 数据持久化与缓存:熟练使用 ORM(SQLAlchemy 或 Tortoise-ORM),深入掌握 Redis 做数据缓存与消息队列。
- 容器化与部署:掌握 Linux 基本操作、Docker 容器打包、Nginx 反向代理与 Gunicorn/Uvicorn 进程管理。
asyncio)和网络协议(HTTP/HTTPS/WebSocket)。现代 Python 服务端面试极其看重高并发与 I/O 多路复用知识。
方向三:网络爬虫与分布式数据抓取
数据采集是为数仓、大模型训练语料库、竞品监控与金融量化提供原材料的工种。过去简单的抓包解析已无法满足现代企业需求,现在的爬虫工程师本质上是“逆向工程与攻防工程师”。
1. 核心技术栈要求
- 网络协议与请求库:掌握 HTTP/2、HTTPS 握手过程,熟练使用
httpx、requests。 - 抓取框架:工业级框架首选
Scrapy,配合Scrapy-Redis实现多机器分布式调度。 - 反爬与逆向:掌握浏览器开发者工具(DevTools),具备基本的 JavaScript 逆向能力(断点调试、扣代码、加密算法还原),熟练配置自动化指纹浏览器(Playwright、Selenium)。
robots.txt 协议及数据安全相关法律法规,严禁抓取涉及用户隐私、未公开商业机密或绕过支付鉴权的数据。
方向四:自动化运维与软件测试开发(DevOps / QA)
纯靠手工点点点的功能测试和机械敲命令的系统运维正在迅速被淘汰。测试开发(Test Automation Engineer)和运维自动化工程师不仅需求稳定,且待遇逐步与业务研发拉齐。
1. 核心技术栈要求
- 自动化测试:掌握单元测试框架
pytest,Web 自动化框架Selenium/Playwright,接口测试与性能压测工具Locust。 - 基础设施自动化:熟练编写脚本调用云厂商 API,掌握
Ansible自动化配置,以及使用 Python 编写 Kubernetes、Prometheus 监控巡检扩展插件。 - CI/CD 流程:结合 GitLab CI、Jenkins 构建自动打包、自动测试并部署上线的闭环流水线。
方向五:人工智能、机器学习与大模型工程化(AI Engineering)
Python 是人工智能领域绝对的通用接口。但初学者需注意:纯理论的算法研发岗位(如模型架构发明、前沿多模态科研)通常硬性要求名校硕博背景,而本专科及转码学员切入该领域最现实的路径是“AI 提示词与工程落地工程师(AI Engineer / RAG 开发)”。
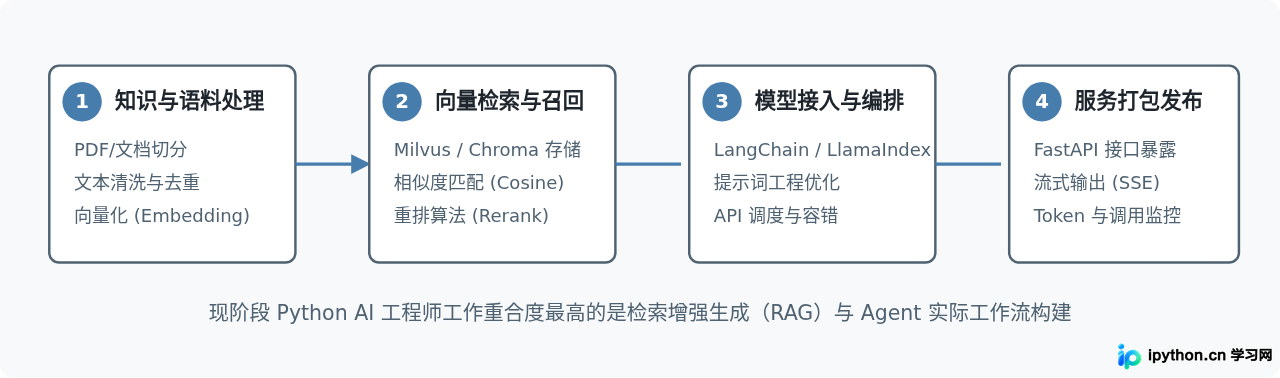
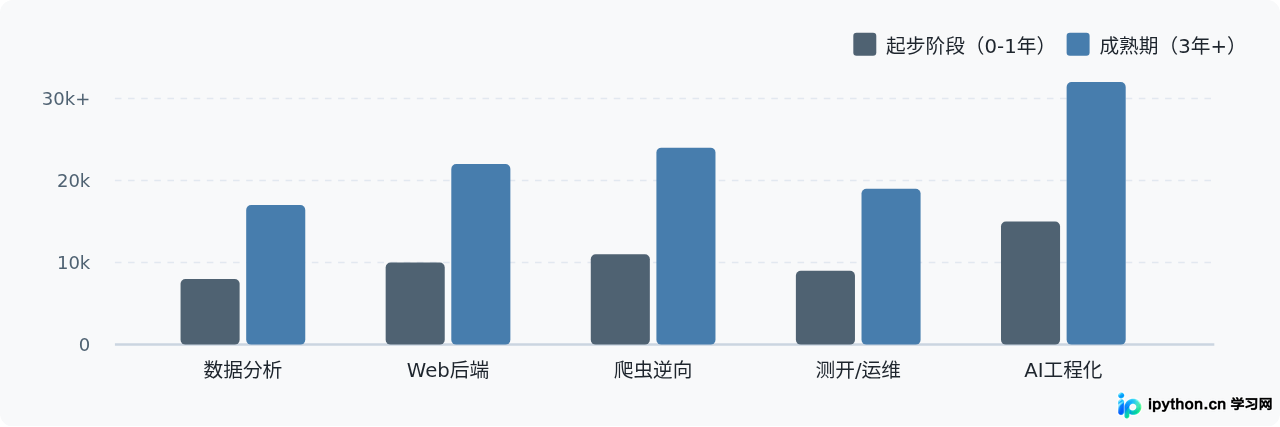
岗位薪资与发展空间综合对比
薪酬直接挂钩于技术壁垒与业务替代成本。初级岗位(0-1年经验)通常处于薪资打底期,真正拉开差距的是2-3年后对于框架底层机制、业务理解深度和系统架构设计的能力。
| 就业方向 | 初级起薪 (月薪) | 熟练阶段 (2-4年经验) | 学历与门槛要求 | 行业竞争重点 |
|---|---|---|---|---|
| 数据分析 / BI | 6K - 9K | 12K - 20K | 大专可投,本科居多 | 业务洞察力、指标口径理解、SQL |
| Web 后端开发 | 7K - 11K | 15K - 25K | 本科优先(软工/计科居多) | 高并发能力、数据库调优、微服务架构 |
| 网络爬虫开发 | 8K - 12K | 16K - 28K | 大专及以上 | JS逆向、APP脱壳、分布式调度反爬 |
| 自动化测试 / 运维 | 7K - 10K | 14K - 22K | 大专及以上 | 测试平台开发、CI/CD 链路、稳定性保障 |
| AI 与大模型工程 | 12K - 18K | 22K - 40K+ | 本科底线,通常要求硕士 | 算力优化、向量检索、Agent体系设计 |
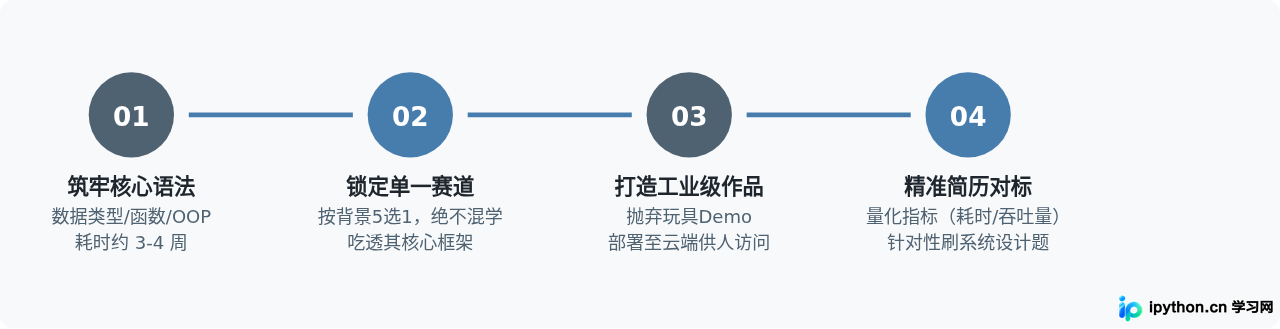
新手破局:从基础到拿Offer的4步落地法
学完基础后最忌讳“全面铺开”。合理的做法是在掌握核心语法后,立即选定单一方向做纵深强化,用真实项目代替纸上谈兵。
-
第一阶段:控制语法学习范围。初学阶段不要去死磕元类(metaclass)、异步底层调度这些抽象机制,把精力集中在列表推导式、字典处理、文件读写、函数传参及常用模块(
os、json、datetime)上即可。 -
第二阶段:依据个人背景选择单一出口。
- 具备商科、文科、财务或运营背景:直接选“数据分析”,业务逻辑是你的天然护城河。
- 工科、自动化、计算机或网络运维背景:优先选“测试开发”或“自动化运维”,技术要求均衡,上手快且需求平稳。
- 对技术细节狂热、乐于研究加解密:切入“爬虫开发”,产出极具确定性。
- 数理基础良好、有理工科研究生背景:重点攻坚“AI大模型工程化”,享受当前产业结构带来的发展红利。
- 第三阶段:坚决淘汰教材里的“玩具案例”。类似“图书管理控制台程序”、“天气预报爬取打印”等案例已在HR简历池中完全失效。你需要的是具备工业特征的项目:包含鉴权校验、异常重试机制、数据库连接池、日志落盘,并真正打包进 Docker 部署到公网服务器上、提供对外访问接口的作品。
- 第四阶段:简历用“量化成果”取代“熟练掌握”。将“熟练使用 requests 抓取数据”修改为“设计分布式抓取方案,突破某电商平台 JS 签名加密,单日稳定入库结构化数据 50 万条,通过布隆过滤器去重降低 40% 重复 I/O”。面试官看重的是工程落地和解决问题能力,而非单纯背诵语法。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















