


Python有哪些主流发展方向及应用领域
深入解析Python目前在工业界的核心主流发展方向与实际应用领域,全面拆解Web后端、数据科学、人工智能与自动化运维的技术栈选型、学习进阶步骤与差异对比。
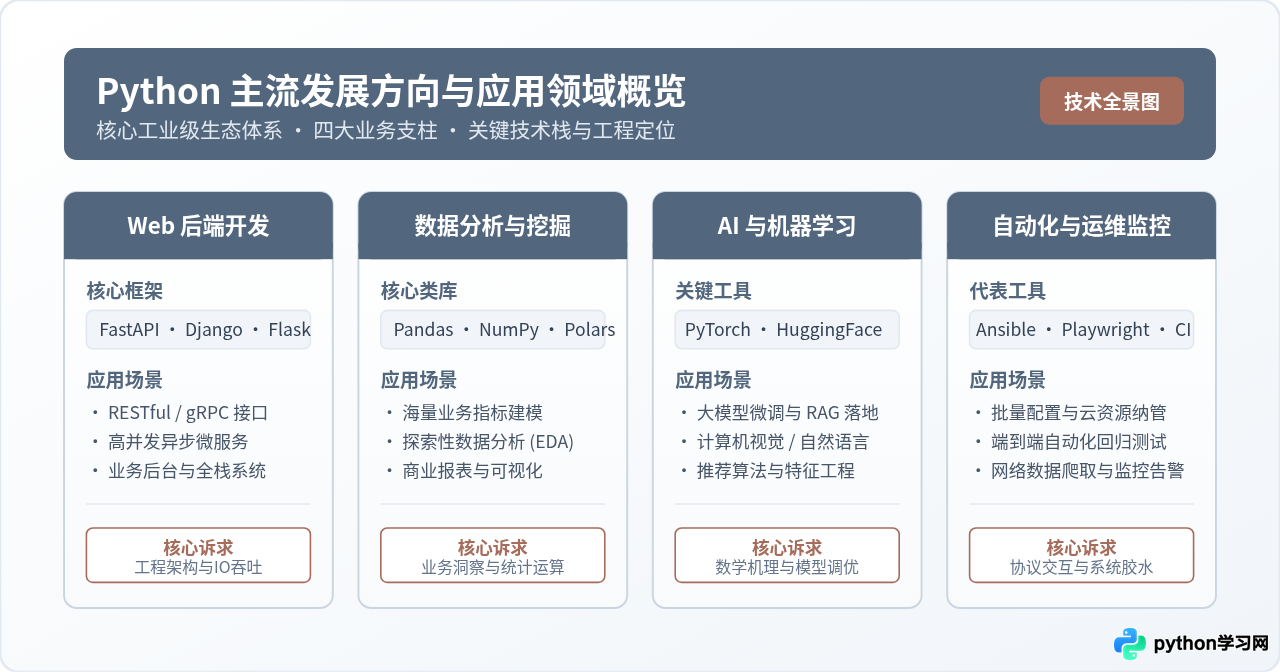
一、四大主流工业发展方向解析
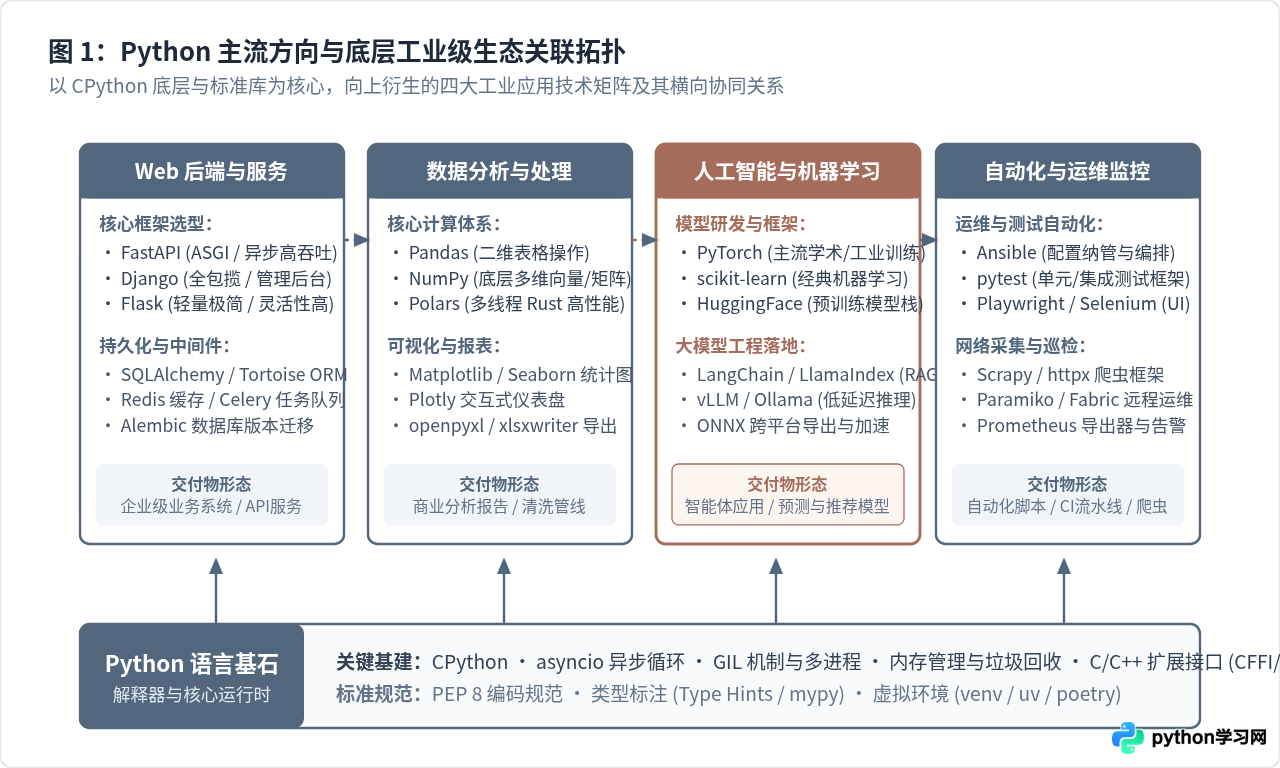
Python 凭借清晰的语法表达能力与强大的 C/C++ 扩展接口(CFFI、pybind11),在多个技术栈中占据了核心胶水语言与主语言地位。以下分别解析这四个方向的解决场景、核心技术栈及实际代码形态。
1. Web 后端开发与 API 服务
Python 在 Web 领域的重心已从早期的全包揽模板渲染(如 Django MTV 架构),全面转向高性能异步 API、微服务与高并发 I/O 网关。随着 Python 3.7+ 普及 asyncio 以及 ASGI(Asynchronous Server Gateway Interface)规范的成熟,现代 Python Web 开发能够以极低的资源开销维持上万级别的并发长连接。
- 核心框架选型:
FastAPI:基于 Starlette 和 Pydantic,提供原生异步支持、自动生成 OpenAPI(Swagger)契约与极高性能的类型校验。Django:包含完整的 ORM、权限认证、管理后台(Admin)与中间件体系,适合业务复杂度高、需要快速构建交付后台系统的中大型项目。Flask:极简微内核架构,依赖社区扩展(如 Flask-SQLAlchemy),常用于轻量级工具服务或算法推理接口封装。
- 工程配套基建:异步 ORM(SQLAlchemy 2.0+ / Tortoise-ORM)、数据库版本管理(Alembic)、分布式任务队列(Celery / Redis)、异步服务器(Uvicorn / Gunicorn)。
from fastapi import FastAPI, HTTPException, status
from pydantic import BaseModel, Field
from typing import Optional

app = FastAPI(title="用户任务处理服务")

class TaskCreateRequest(BaseModel):
    task_name: str = Field(..., min_length=3, max_length=50, description="任务唯一标识名称")
    priority: int = Field(default=1, ge=1, le=5, description="优先级 1-5")
    description: Optional[str] = None

class TaskResponse(BaseModel):
    task_id: int
    task_name: str
    status: str

@app.post("/api/v1/tasks", response_model=TaskResponse, status_code=status.HTTP_201_CREATED)
async def create_task(payload: TaskCreateRequest):
    # 模拟真实异步 I/O 写入数据库或消息队列
    if payload.task_name == "forbidden_task":
        raise HTTPException(status_code=400, detail="非法任务名称")

    generated_id = 1024
    return TaskResponse(
        task_id=generated_id,
        task_name=payload.task_name,
        status="queued"
    )
2. 数据分析与数据科学 (Data Science)
数据分析方向负责从海量异构业务数据中提炼商业洞察、构建数仓指标并执行探索性数据分析(EDA)。该方向以矩阵运算和表格化操作为基础,底层核心运算库多采用 C/Fortran/Rust 编写,Python 作为高层语法提供直观的链式调用。
- 核心计算库:
NumPy:提供高性能的 N 维数组对象(ndarray)及广播机制,是所有 Python 科学计算的基石。Pandas:提供Series与DataFrame二维表格数据结构,擅长数据清洗、缺失值处理、时间序列重采样与透视聚合。Polars:基于 Rust 的下一代 DataFrame 库,支持多线程并行与惰性求值(Lazy Execution),在大数据集下显著降低内存开销。
- 可视化与报告:
Matplotlib(底层绘图)、Seaborn(统计图表封装)、Plotly(交互式仪表盘)、openpyxl(Excel 自动化交互)。
import pandas as pd
import numpy as np

# 构造模拟订单数据集
raw_data = {
    "order_id": ["A101", "A102", "A103", "A104", "A105"],
    "channel": ["线上", "线下", "线上", "线上", "线下"],
    "amount": [128.5, 45.0, np.nan, 310.0, 95.0],
    "discount": [0.9, 1.0, 0.8, 0.85, 1.0]
}

df = pd.DataFrame(raw_data)

# 1. 缺失值填充(使用渠道均值替代)
df["amount"] = df["amount"].fillna(df.groupby("channel")["amount"].transform("mean"))

# 2. 衍生实收金额指标并执行聚合汇总
df["actual_payment"] = df["amount"] * df["discount"]
channel_summary = df.groupby("channel").agg(
    order_count=("order_id", "count"),
    total_revenue=("actual_payment", "sum"),
    avg_order_value=("actual_payment", "mean")
).reset_index()

# 示例输出汇总结果
# channel  order_count  total_revenue  avg_order_value
#   线上           3         479.25           159.75
#   线下           2         140.00            70.00
3. 人工智能与机器学习 / 深度学习
Python 是当今全球人工智能与深度学习研究及工程化的统治级语言。从经典的判别式模型(分类、回归、推荐)到目前的大语言模型(LLM)、多模态模型与智能体系统(AI Agent),Python 串联了从数据预处理、模型微调(Fine-tuning)、向量检索引擎到低延迟推理服务的全链路。
- 深度学习与算法研发:
PyTorch:动态计算图设计、成熟的自动微分引擎(Autograd)以及优秀的生态工具链,已成为学术界与工业界模型研发的主流标准。scikit-learn:集成经典的随机森林、支持向量机(SVM)、K-means 聚类等统计学习算法,适合中小规模结构化数据挖掘。
- 现代大模型与 Agent 应用开发:
Hugging Face (Transformers / PEFT / Datasets):提供主流开源模型(LLaMA、Qwen、DeepSeek 等)的加载、LoRA 高效参数微调与评估套件。LangChain / LlamaIndex:负责构建检索增强生成(RAG)管道、向量数据库(Chroma、Milvus)交互与外部工具调用调度。vLLM / Ollama:针对生产环境的高并发、低显存 PagedAttention 推理加速中间件。
import torch
import torch.nn as nn

class BinaryClassifier(nn.Module):
    def __init__(self, input_dim: int, hidden_dim: int):
        super().__init__()
        self.network = nn.Sequential(
            nn.Linear(input_dim, hidden_dim),
            nn.ReLU(),
            nn.Linear(hidden_dim, 1),
            nn.Sigmoid()
        )

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return self.network(x)

# 实例化模型并设置推理模式
model = BinaryClassifier(input_dim=8, hidden_dim=16)
model.eval()

# 模拟 2 个批次的特征向量 (Batch Size = 2, Features = 8)
dummy_features = torch.randn(2, 8)
with torch.no_grad():
    predictions = model(dummy_features)

# 输出形状: torch.Size([2, 1]),数值区间 [0.0, 1.0]
4. 自动化运维、网络爬虫与系统测试
Python 在运维、抓取与质量保障领域被称为“超级胶水”。其丰富的系统底层接口(os、subprocess、socket)与网络协议库使得开发者能以极短代码完成复杂的系统级自动化任务。
- 自动化运维与基础设施 (DevOps / SRE):使用
Ansible进行无代理跨节点批量配置纳管;通过Paramiko/Fabric执行远程 SSH 批量自动化运维;编写自定义 Prometheus Exporter 实现业务指标探测。 - 自动化测试 (QA Engineering):以
pytest为核心编写单元测试、Mock 打桩与参数化集成测试;使用Playwright或Selenium实现跨浏览器端到端(E2E)UI 流程自动化。 - 网络数据采集与解析:通过
httpx/requests模拟 HTTP 请求,使用BeautifulSoup4/lxml解析 DOM 结构,或借助Scrapy分布式框架完成工业级抓取管道。
import asyncio
from playwright.async_api import async_playwright

async def verify_service_status(target_url: str):
    async with async_playwright() as p:
        browser = await p.chromium.launch(headless=True)
        context = await browser.new_context()
        page = await context.new_page()

        # 访问目标控制台页面并断言关键元素
        response = await page.goto(target_url, timeout=10000)
        assert response.status == 200, f"HTTP响应异常: {response.status}"

        # 检查健康检查节点文本
        status_element = await page.wait_for_selector("#system-health", timeout=5000)
        content = await status_element.text_content()
        assert "OK" in content, f"服务巡检未通过: {content}"

        await browser.close()
        return "巡检合格"

# 执行示例:asyncio.run(verify_service_status("https://example.internal/health"))
二、发展方向选型与决策依据
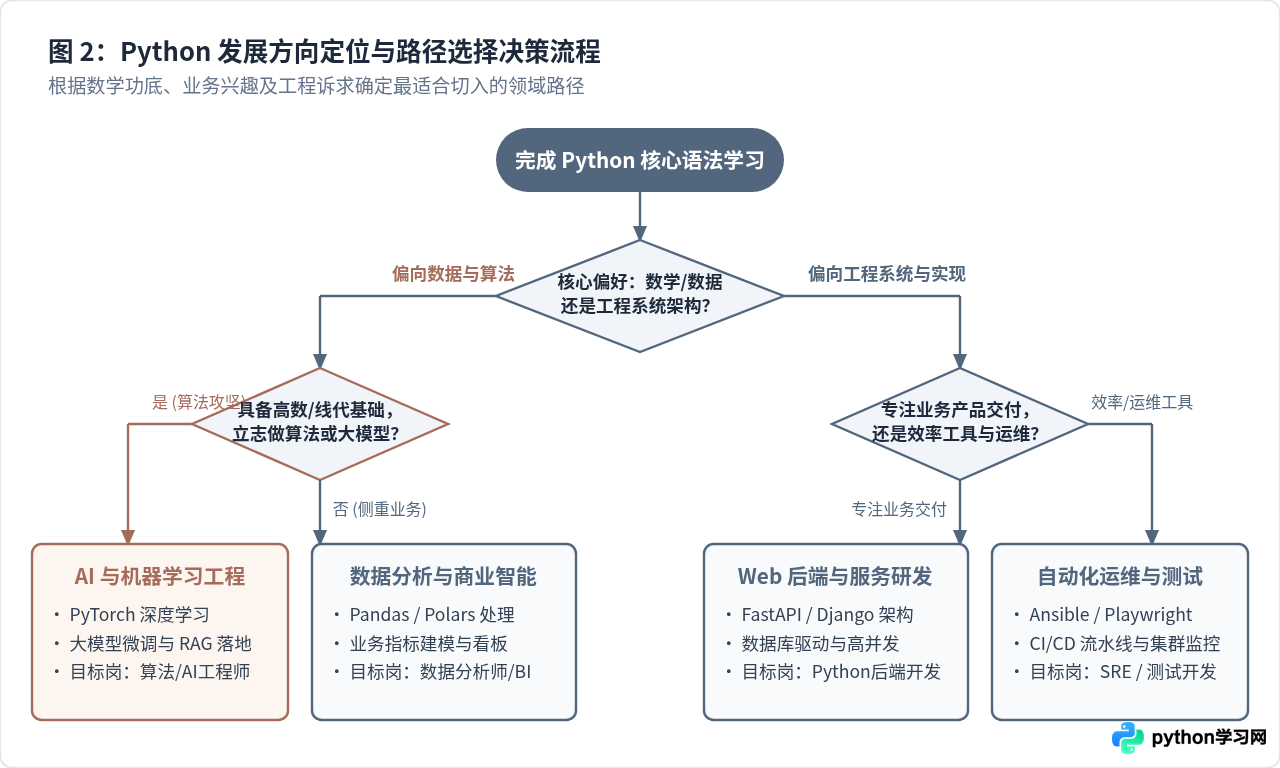
面对多个方向,初学者与转型开发者往往容易陷入“什么都想学却难以达到企业级用人标准”的困境。选择发展方向时,应明确区分脚本编写能力与生产工程能力,并结合自身能力背景进行权衡:
- 数学与统计功底的依赖度:
AI 算法研发(尤其是模型训练与底层调优)要求扎实的线性代数、多变量微积分、概率论与凸优化理论基础。若无深厚数学背景,直接从事算法模型设计将面临极大瓶颈;但若目标是从事 AI 工程化(如大模型 API 调用、RAG 向量检索系统搭建、Agent 工具编写),核心能力则转变为工程架构与业务拆解,门槛相对平缓。
- 系统并发与工程架构的偏好:
Web 后端与分布式爬虫需要深入理解操作系统网络协议、进程线程协程调度、数据库事务隔离级别(ACID)、缓存击穿/雪崩对策与微服务网关。如果对软件架构设计、数据库调优与接口吞吐优化感兴趣,Web 后端是极佳的长期主线。
- 见效周期与业务反馈:
自动化运维、测试开发与基础数据报表分析是正向反馈最快的领域。只需掌握 Python 基础语法与核心库(如
pytest、pandas),即可在实际日常工作中解决痛点、降低重复劳动。
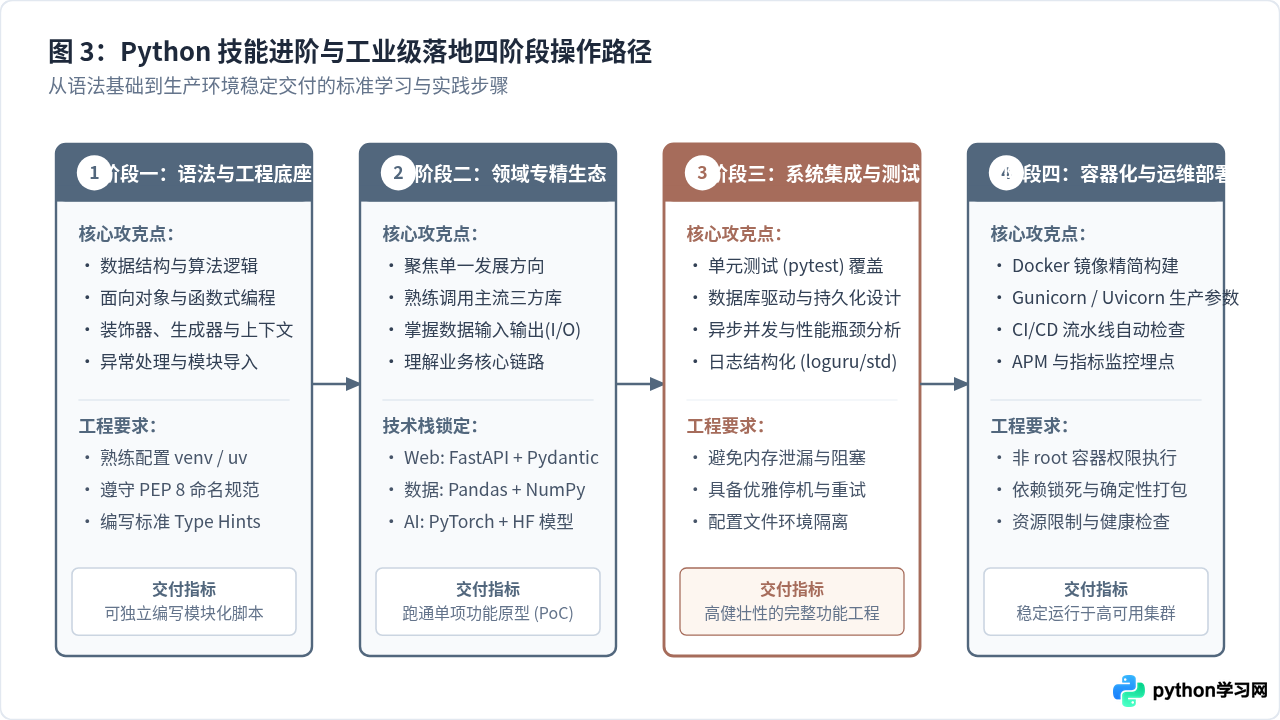
三、从代码原型到生产落地的四个进阶阶段
无论选择哪一方向,在工业界真正具备竞争力的 Python 工程师,都必须经历从“能跑通代码”到“系统健壮可维护”的进阶路径。具体步骤与要求如下:
-
第一阶段:扎实掌握核心语法与现代工程规范
深入理解 Python 对象内存模型、引用计数与垃圾回收机制、生成器(
yield)与上下文管理器(with)。必须遵循 PEP 8 命名与格式化标准,全程引入强类型注解(Type Hints),并使用mypy或ruff开展静态代码检查,杜绝动态类型随意性导致的低级隐患。 -
第二阶段:深耕单一方向的主流生产框架
严禁多个方向并行浅尝。选定方向后,至少完整读完核心框架(如 FastAPI 或 PyTorch)的官方指导文档,理解框架的核心生命周期(如中间件流程、模型前向传播钩子),能够独立从零构建最小可行原型(PoC)。
-
第三阶段:补齐测试体系与异常防御
将
pytest作为日常开发必备工具,编写涵盖正常路径与极端边界条件的单元测试与集成测试。加入结构化日志记录(包含请求 TraceID、上下文关键参数),处理好连接超时、指数退避重试与异常兜底,杜绝生产环境中因未捕获异常导致主进程崩溃。 -
第四阶段:容器化、CI/CD 与监控交付
学习编写多阶段构建的
Dockerfile,剥离编译依赖以精简镜像体积;使用非 root 专用用户运行进程;通过 GitHub Actions 或 GitLab CI 配置自动化流水线;在生产端配置 Prometheus 指标暴露与健康检查端点。
CPython 的全局解释器锁(GIL)决定了纯 Python 线程在 CPU 密集型计算任务下无法利用多核性能。遇到密集矩阵运算或图像处理时,应使用底层的 C/C++ 扩展(如 NumPy 或 OpenCV)释放 GIL;在
asyncio 异步事件循环中,严禁调用阻塞式 I/O 函数(如标准库 time.sleep() 或同步 requests.get()),否则会导致整个事件循环假死,所有并发请求积压挂起。
四、主流方向深度对比与总结
为了帮助读者清晰定位各方向的技术要求与职业特征,下表将核心方向的门槛、要求、交付物及代表技术栈进行综合对比:
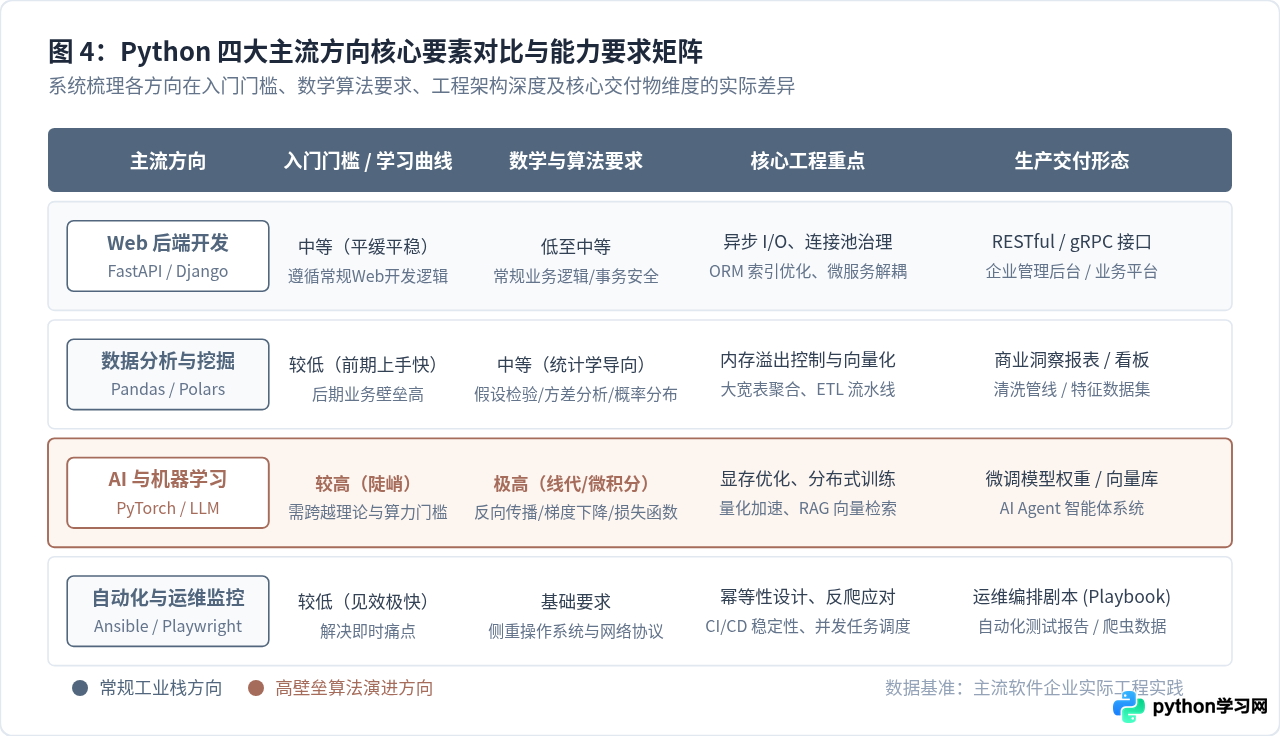
| 主流方向 | 典型岗位 | 主力技术栈 | 核心衡量指标 | 适用发展建议 |
|---|---|---|---|---|
| Web 后端开发 | Python 后端工程师、API 研发架构师 | FastAPI, Django, PostgreSQL, Redis, Celery | QPS/吞吐量、P99 延迟、系统高可用性、数据事务一致性 | 适合喜欢构建完整业务产品、注重工程架构与系统设计的工程师。 |
| 数据分析与挖掘 | 数据分析师、BI 开发工程师、数据运营专家 | Pandas, Polars, SQL, Seaborn, Tableau | 指标解释度、业务转化归因准确率、报表及时率 | 适合具备良好商业敏感度、热衷从指标中发现业务增长点的从业者。 |
| AI 与机器学习 | 算法工程师、深度学习研究员、LLM 应用架构师 | PyTorch, Hugging Face, LangChain, vLLM, ONNX | 模型准确率/召回率、推理显存占用、首字延迟(TTFT) | 算法岗位需要坚实的数学理论支持;大模型工程方向则看重上下文拆解与 Agent 落地能力。 |
| 自动化运维与测试 | SRE 运维工程师、测试开发工程师、抓取架构师 | Ansible, pytest, Playwright, Scrapy, Docker | 测试自动化覆盖率、流水线构建耗时、故障平均修复时间(MTTR) | 适合希望快速获得效率产出、对底层操作系统和网络协议敏感的开发者。 |
综上所述,Python 的主流方向覆盖了从底层自动化效率到高层商业智能与前沿算法的广泛领域。读者在规划发展路径时,应以“扎实语法底座 + 垂直领域深耕 + 严格工程交付”为导向,避免走马观花式的浅层学习,才能在实际工业研发中构建起坚实的专业壁垒。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















