


Python实现12306车次信息抓取与解析

发布时间:2026-10-14 |
5人浏览过
本文详解使用Python抓取12306车次信息的完整流程。重点解决动态加载数据的定位问题,通过配置User-Agent和Cookie规避反爬机制,处理UTF-8编码乱码,并解析JSON数据提取有效车次。包含代码实现、站点字典转换及运行结果展示,适合Python初学者参考。
Python抓取12306车次核心代码
具体实现逻辑与完整代码见下文。
若请求被服务器识别为爬虫,需补充Cookie字段;若未被拦截,仅需设置User-Agent即可。遇到乱码时,应将编码格式强制指定为utf-8。
动态数据定位与站点字典处理
#静态的数据一般在elements中(复制文字到sources按ctrl+f搜索。找到的为静态),而动态去network中去寻找相关的信息
import requests
import re
def send_request():
  headers = {'user-agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/74.0.3729.131 Safari/537.36'
        ,'Cookie':'_uab_collina=159618052151589201474313; JSESSIONID=D33C89D8BEC6A692C79CFA69FC0B0D29; BIGipServerotn=233832970.24610.0000; BIGipServerpool_passport=216859146.50215.0000; RAIL_EXPIRATION=1596443951465; RAIL_DEVICEID=nMo94O2Z21cXLblW7otLoxUZ_LP9Q01PYj_I89OqU6MqjxyX9814Jc3CH5TNwgBVJqnBaBG8OGiBWo2QtNcu5wVu-asNk6YLa49g0fMwVp03XFJQ-GkhHYHcqIgUd-nqQB_VEdWH1Om_D2yAgIu8QcEavt02pmH5; route=c5c62a339e7744272a54643b3be5bf64; _jc_save_fromStation=%u5317%u4EAC%2CBJP; _jc_save_toStation=%u5929%u6D25%2CTJP; _jc_save_fromDate=2020-07-31; _jc_save_toDate=2020-07-31; _jc_save_wfdc_flag=dc'}#创建头部信息
  url='https://kyfw.12306.cn/otn/leftTicket/query?leftTicketDTO.train_date=2020-07-31&leftTicketDTO.from_station=BJP&leftTicketDTO.to_station=TJP&purpose_codes=ADULT'
  #设置编码格式。防止乱码
  resp=requests.get(url,headers=headers)
  resp.encoding='utf-8'
  return resp

#解析数据
#{}是字典。根据key获取值。
def parse_json(resp,city):
  json_ticket=resp.json()#将相应的数据转换为json
  data_list=json_ticket['data']['result']#得到车次的列表
  lst=[]#列表
  for item in data_list:
    #遍历车次信息进行分割
    d=item.split('|')
    lst.append([d[3],city[d[6]],city[d[7]],d[31],d[30],d[13]])
  return lst
'''
d[3]从列表中获取索引为3的表示车次
d[6]查询起始站
d[7]查询到达站
d[31]一等座
d[30]表示二等座
d[13]表示出行时间'''
#获得station_name的信息
def get_city():
  url='https://kyfw.12306.cn/otn/resources/js/framework/station_name.js?station_version=1.9151'
  headers = {'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/74.0.3729.131 Safari/537.36'}
  resp=requests.get(url,headers=headers)
  resp.encoding='utf-8'
  #进行数据的提取(只要一部分)
  stations=re.findall('([\u4e00-\u9fa5]+)\|([A-Z]+)',resp.text)
  #将列表进行转换为字典
  stations_data=dict(stations)
  #key与value进行互换
  station_d={}#空字典。用于完成上述操作
  for item in stations_data:
    station_d[stations_data[item]]=item
  #print(station_d)
  return station_d

def start():
  lst=parse_json(send_request(),get_city())
  #进行数据的筛选(得到有效的数据)
  for i in lst:
    if i[3]!='无' and i[3]!='':
      print(i)
if __name__=='__main__':
  start() #开始
运行结果展示与总结
程序运行效果截图如下:
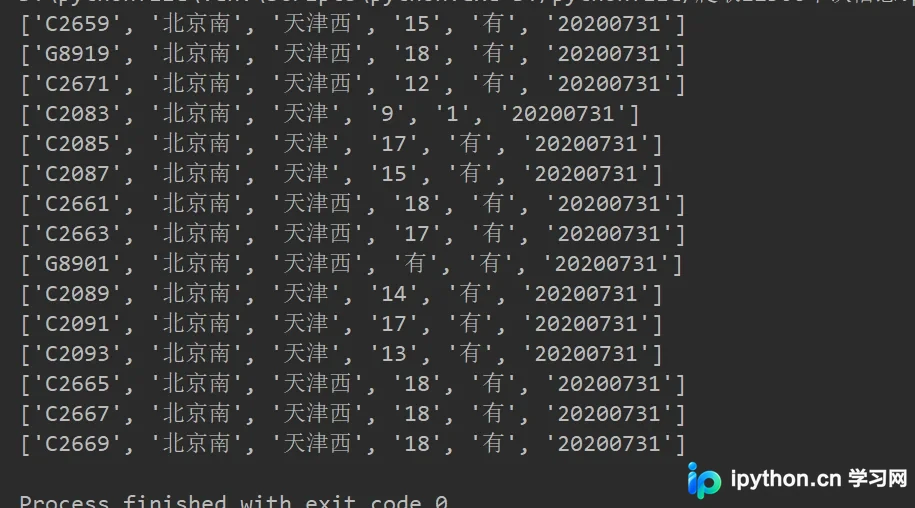
以上内容为本文全部分享,旨在辅助读者学习相关技术。欢迎收藏支持本站,获取更多技术资源。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















