


Python爬取51CTO博客数据并存储至MySQL及打包exe实战

本文详解使用Python爬取51CTO博客数据并存储至MySQL数据库的完整流程。从环境配置、模块安装到代码编写,逐步展示如何解析网页结构、处理数据类型及入库操作。此外,文章进一步介绍利用PyInstaller将Python脚本打包为独立exe文件的技巧,便于非技术人员直接运行,实现数据抓取工具的便捷分发与使用。
实验环境与模块安装
实验环境
首先,确保系统中已安装Python 3.7版本。
接着,需要安装requests、bs4(BeautifulSoup)以及pymysql这三个核心模块,用于网络请求、HTML解析和数据库连接。
实验步骤1.安装环境及模块
若对模块安装过程不熟悉,可参考https://www.jb51.net/article/194104.htm获取详细指导。
Python爬虫代码实现
2.编写代码
# 51cto 博客页面数据插入mysql数据库
# 导入模块
import re
import bs4
import pymysql
import requests

# 连接数据库账号密码
db = pymysql.connect(host='172.171.13.229',
           user='root', passwd='abc123',
           db='test', port=3306,
           charset='utf8')
# 获取游标
cursor = db.cursor()

def open_url(url):
  # 连接模拟网页访问
  headers = {
    'user-agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) '
           'Chrome/57.0.2987.98 Safari/537.36'}
  res = requests.get(url, headers=headers)
  return res

# 爬取网页内容
def find_text(res):
  soup = bs4.BeautifulSoup(res.text, 'html.parser')

  # 博客名
  titles = []
  targets = soup.find_all("a", class_="tit")
  for each in targets:
    each = each.text.strip()
    if "置顶" in each:
      each = each.split(' ')[0]
    titles.append(each)

  # 阅读量
  reads = []
  read1 = soup.find_all("p", class_="read fl on")
  read2 = soup.find_all("p", class_="read fl")
  for each in read1:
    reads.append(each.text)
  for each in read2:
    reads.append(each.text)

  # 评论数
  comment = []
  targets = soup.find_all("p", class_='comment fl')
  for each in targets:
    comment.append(each.text)

  # 收藏
  collects = []
  targets = soup.find_all("p", class_='collect fl')
  for each in targets:
    collects.append(each.text)

   # 发布时间
  dates=[]
  targets = soup.find_all("a", class_='time fl')
  for each in targets:
    each = each.text.split(':')[1]
    dates.append(each)

  # 插入sql 语句
  sql = """insert into blog (blog_title,read_number,comment_number, collect, dates)
  values( '%s', '%s', '%s', '%s', '%s');"""
  # 替换页面 \xa0
  for titles, reads, comment, collects, dates in zip(titles, reads, comment, collects, dates):
    reads = re.sub('\s', '', reads)
    comment = re.sub('\s', '', comment)
    collects = re.sub('\s', '', collects)
    cursor.execute(sql % (titles, reads, comment, collects,dates))
    db.commit()
    pass

# 统计总页数
def find_depth(res):
  soup = bs4.BeautifulSoup(res.text, 'html.parser')
  depth = soup.find('li', class_='next').previous_sibling.previous_sibling.text
  return int(depth)

# 主函数
def main():
  host = "https://blog.51cto.com/13760351"
  res = open_url(host) # 打开首页链接
  depth = find_depth(res) # 获取总页数

  # 爬取其他页面信息
  for i in range(1, depth + 1):
    url = host + '/p' + str(i) # 完整链接
    res = open_url(url) # 打开其他链接
    find_text(res) # 爬取数据

  # 关闭游标
  cursor.close()
  # 关闭数据库连接
  db.close()

if __name__ == '__main__':
  main()
3.在MySQL数据库中创建对应的表结构,以存储抓取到的数据。
CREATE TABLE `blog` (
 `row_id` int(11) NOT NULL AUTO_INCREMENT COMMENT '主键',
 `blog_title` varchar(52) DEFAULT NULL COMMENT '博客标题',
 `read_number` varchar(26) DEFAULT NULL COMMENT '阅读数量',
 `comment_number` varchar(16) DEFAULT NULL COMMENT '评论数量',
 `collect` varchar(16) DEFAULT NULL COMMENT '收藏数量',
 `dates` varchar(16) DEFAULT NULL COMMENT '发布日期',
 PRIMARY KEY (`row_id`)
) ENGINE=InnoDB AUTO_INCREMENT=1 DEFAULT CHARSET=utf8;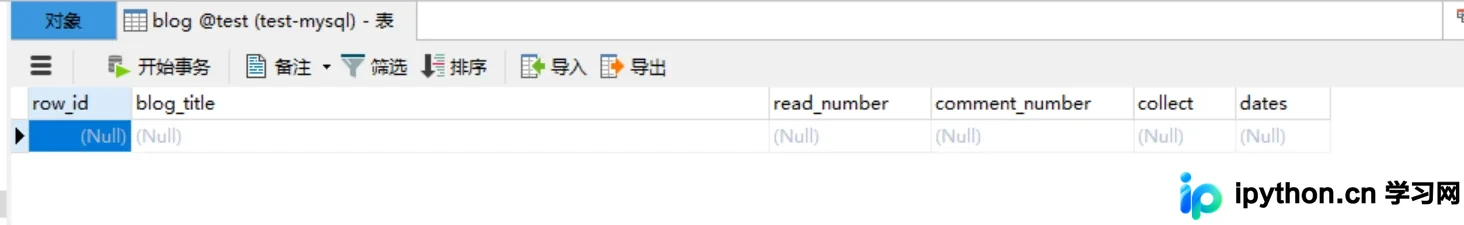
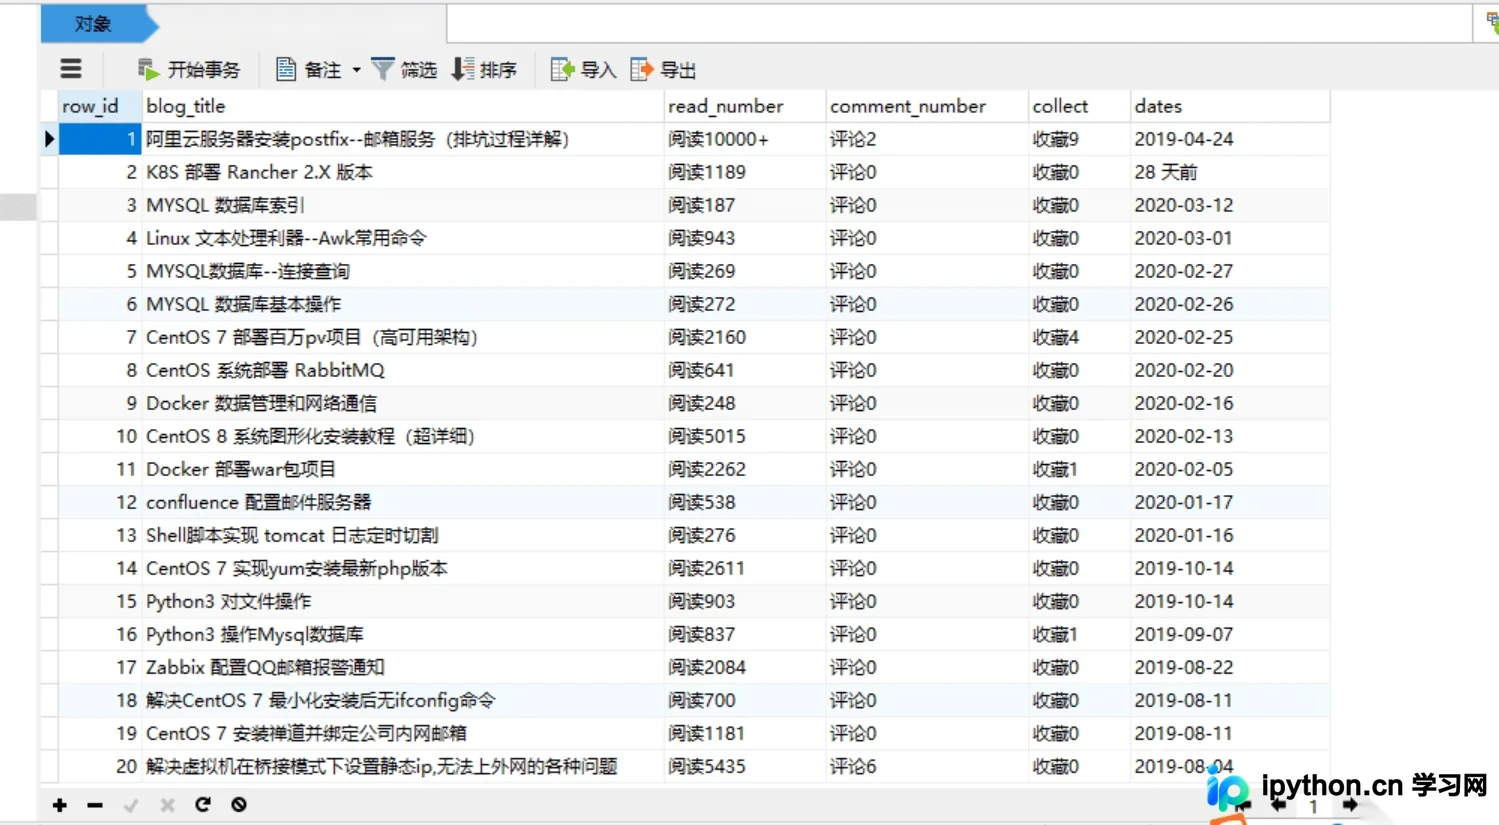
4.运行代码,查看效果:
数据入库优化与验证
改进版:
改进内容:
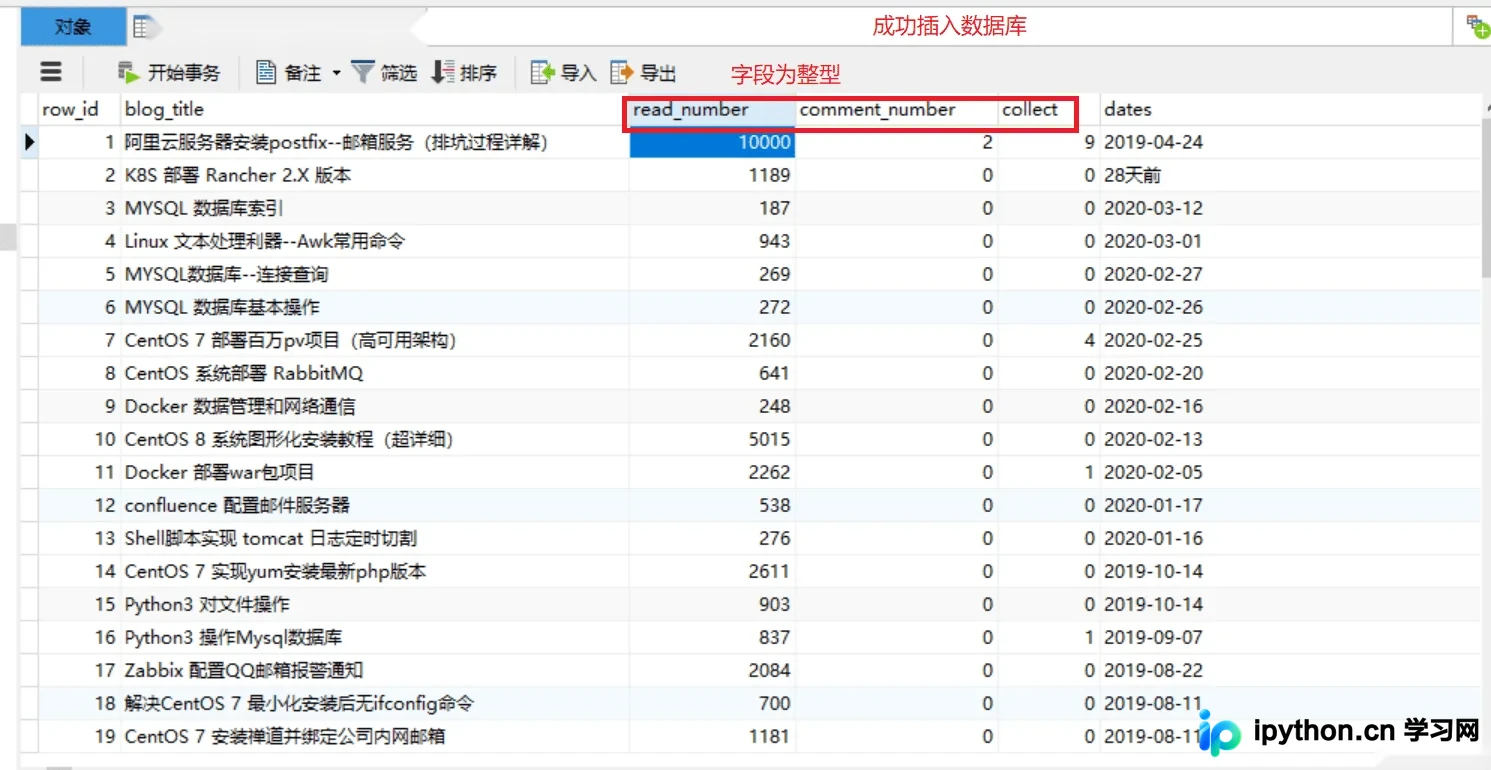
1.数据库中的某些字段仅需保留数字部分,需对抓取内容进行清洗。
2.默认情况下,爬取的内容均为字符串格式。为了便于后续的数据库操作和计算,建议将存储数值型数据的字段类型转换为整型(int)。
1.代码如下:
import re
import bs4
import pymysql
import requests

# 连接数据库
db = pymysql.connect(host='172.171.13.229',
           user='root', passwd='abc123',
           db='test', port=3306,
           charset='utf8')
# 获取游标
cursor = db.cursor()

def open_url(url):
  # 连接模拟网页访问
  headers = {
    'user-agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) '
           'Chrome/57.0.2987.98 Safari/537.36'}
  res = requests.get(url, headers=headers)
  return res

# 爬取网页内容
def find_text(res):
  soup = bs4.BeautifulSoup(res.text, 'html.parser')

  # 博客标题
  titles = []
  targets = soup.find_all("a", class_="tit")
  for each in targets:
    each = each.text.strip()
    if "置顶" in each:
      each = each.split(' ')[0]
    titles.append(each)

  # 阅读量
  reads = []
  read1 = soup.find_all("p", class_="read fl on")
  read2 = soup.find_all("p", class_="read fl")
  for each in read1:
    reads.append(each.text)
  for each in read2:
    reads.append(each.text)

  # 评论数
  comment = []
  targets = soup.find_all("p", class_='comment fl')
  for each in targets:
    comment.append(each.text)

  # 收藏
  collects = []
  targets = soup.find_all("p", class_='collect fl')
  for each in targets:
    collects.append(each.text)

  # 发布时间
  dates=[]
  targets = soup.find_all("a", class_='time fl')
  for each in targets:
    each = each.text.split(':')[1]
    dates.append(each)

  # 插入sql 语句
  sql = """insert into blogs (blog_title,read_number,comment_number, collect, dates)
  values( '%s', '%s', '%s', '%s', '%s');"""
  # 替换页面 \xa0
  for titles, reads, comment, collects, dates in zip(titles, reads, comment, collects, dates):
    reads = re.sub('\s', '', reads)
    reads=int(re.sub('\D', "", reads)) #匹配数字,转换为整型
    comment = re.sub('\s', '', comment)
    comment = int(re.sub('\D', "", comment)) #匹配数字,转换为整型
    collects = re.sub('\s', '', collects)
    collects = int(re.sub('\D', "", collects)) #匹配数字,转换为整型
    dates = re.sub('\s', '', dates)
    cursor.execute(sql % (titles, reads, comment, collects,dates))
    db.commit()
    pass

# 统计总页数
def find_depth(res):
  soup = bs4.BeautifulSoup(res.text, 'html.parser')
  depth = soup.find('li', class_='next').previous_sibling.previous_sibling.text
  return int(depth)

# 主函数
def main():
  host = "https://blog.51cto.com/13760351"
  res = open_url(host) # 打开首页链接
  depth = find_depth(res) # 获取总页数

  # 爬取其他页面信息
  for i in range(1, depth + 1):
    url = host + '/p' + str(i) # 完整链接
    res = open_url(url) # 打开其他链接
    find_text(res) # 爬取数据

  # 关闭游标
  cursor.close()
  # 关闭数据库连接
  db.close()

#主程序入口
if __name__ == '__main__':
  main()
2.创建对应表
CREATE TABLE `blogs` (
 `row_id` int(11) NOT NULL AUTO_INCREMENT COMMENT '主键',
 `blog_title` varchar(52) DEFAULT NULL COMMENT '博客标题',
 `read_number` int(26) DEFAULT NULL COMMENT '阅读数量',
 `comment_number` int(16) DEFAULT NULL COMMENT '评论数量',
 `collect` int(16) DEFAULT NULL COMMENT '收藏数量',
 `dates` varchar(16) DEFAULT NULL COMMENT '发布日期',
 PRIMARY KEY (`row_id`)
) ENGINE=InnoDB AUTO_INCREMENT=1 DEFAULT CHARSET=utf8;
3.运行代码,验证
程序打包为EXE文件
升级版
为了让初学者也能轻松使用此程序,可以将该项目打包成exe格式的可执行文件。这样,其他用户无需安装Python环境,只需在电脑上双击运行即可使用,极大提升了便利性。
1.改进代码:
#末尾修改为:
if __name__ == '__main__':
  main()
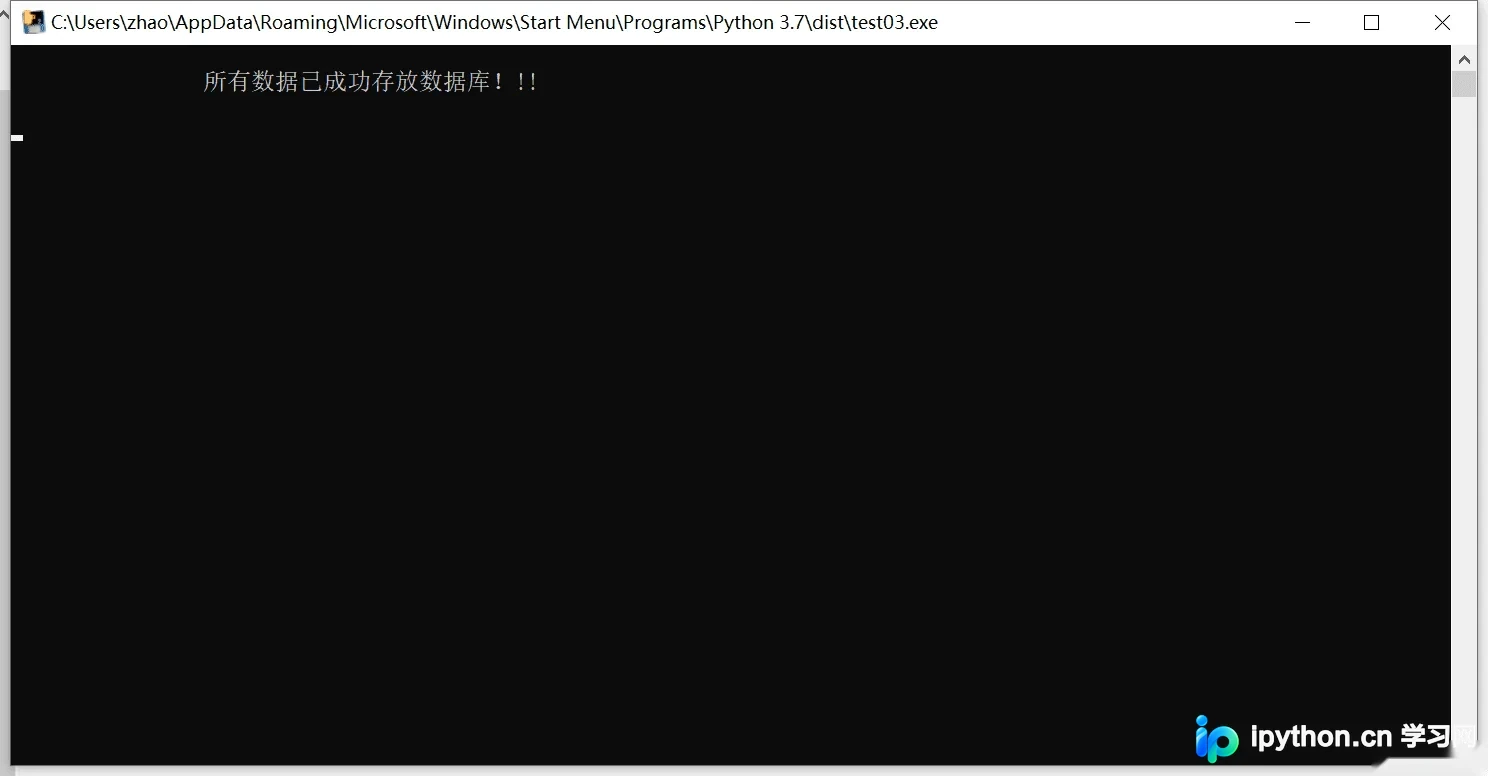
  print("\n\t\t所有数据已成功存放数据库!!! \n")
  time.sleep(5)
2.安装打包模块pyinstaller(通过cmd命令行安装)。
pip install pyinstaller -i https://pypi.tuna.tsinghua.edu.cn/simple/
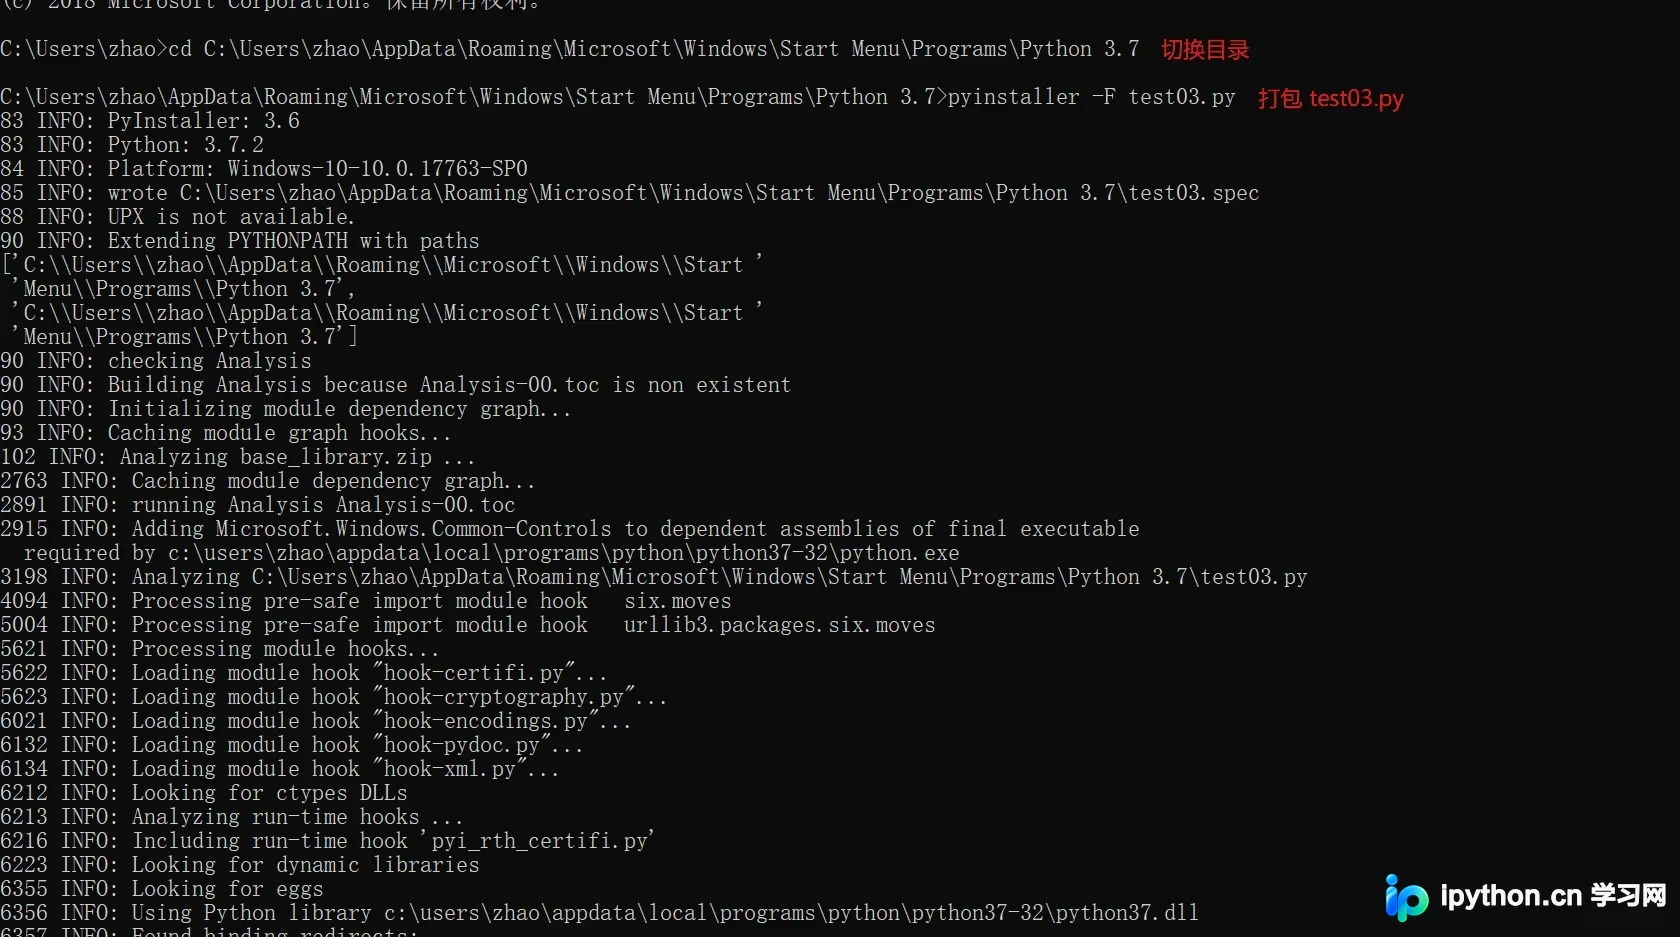
3.Python代码打包
1.切换到包含待打包Python代码的目录路径下。
2.在cmd窗口中运行命令:pyinstaller -F test03.py(其中test03为项目名称,需替换为实际文件名)。
4.查看exe包
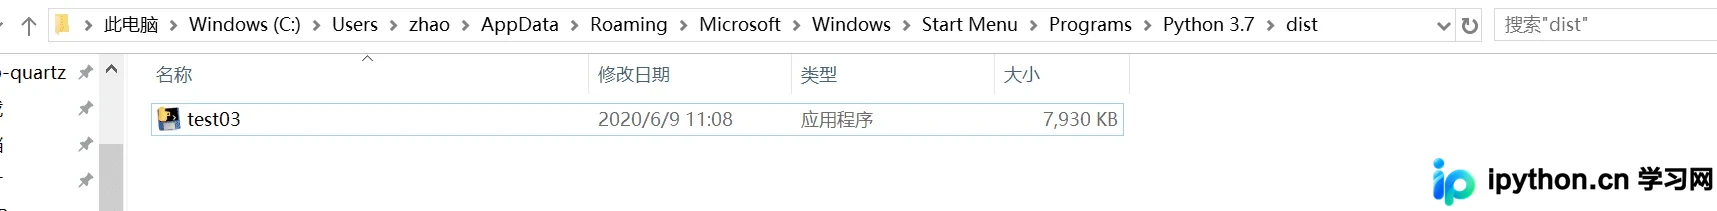
打包完成后,会在当前目录下生成一个dist文件夹,生成的exe文件即位于该目录内。
5.运行exe包,查看效果
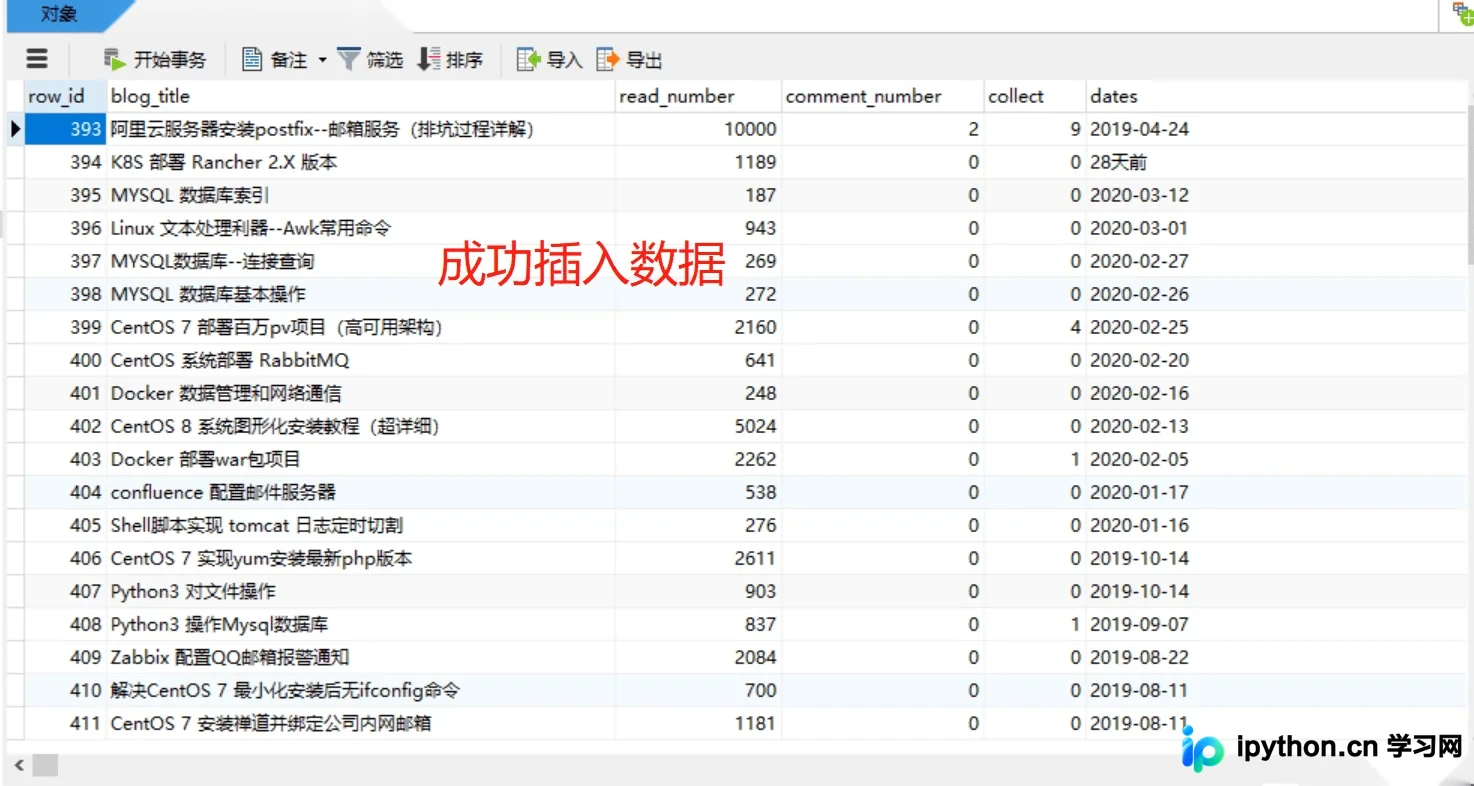
检查数据库
总结
总结:
1.本博客是在上一篇基础上的改进版,整体步骤为先爬取首页信息,再遍历其他页面数据,最后优化细节并将程序打包为exe文件。
2.在网页数据抓取场景中,将数据持久化存储到数据库是最常见且实用的做法。
3.基于此博客的内容仍有进一步优化的空间,但掌握核心方法才是关键。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















