


Python3.7使用openpyxl向Excel单元格写入数据的完整示例

本文介绍在Python3.7环境下,如何利用openpyxl库将矩阵运算后的labels和features数据写入Excel文件。通过实例演示了如何创建Workbook、使用ws.append()逐行或逐列写入数据,并对比了xlrd的局限性。文章还探讨了insert_cols的使用限制及从Excel读取数据的完整流程,旨在为数据集扩展处理提供实用的代码参考。
问题背景与解决方案概述
此前曾尝试在Excel中选中多个单元格并复制至同一Sheet的其他位置,查阅大量资料后未找到直接方法,目前仅掌握以下解决方案。若各位专家有更佳方案,欢迎交流指正。
# encoding:utf-8
import pandas as pd
import openpyxl
xl = pd.read_excel(r"E:\55\CRM经营分析表-10001741-1570416265044.xls")
xl.to_excel(r"E:\55\crms.xlsx")
wk = openpyxl.load_workbook(r"E:\55\crms.xlsx") #加载已经存在的excel
wk_name = wk.sheetnames
wk_sheet = wk[wk_name[0]]

wk_sheet.cell(row=2,column=2,value='大区') #在第二行,第二列下入“大区”数值
wk_sheet.cell(row=2,column=3,value='小区')
wk_sheet.cell(row=2,column=4,value='店铺编码')
wk_sheet.cell(row=2,column=5,value='店铺名称')

wk.save(r"E:\55\s.xlsx")
补充知识点:【openpyxl】Python对Excel进行写入操作,包括写入单列或单行的方法,以及从Excel读取label和feature对应格式并插入一行或一列的实现方式。
环境准备与库选择
前言
近期在进行数据集扩展(expansion of dataset)工作,因此需要将扩展后的数据集写入Excel文件中。
目前的矩阵运算已全部完成,最终输出结果为两组数据:labels和features。
整理后的数据格式如下所示。
label = [[0],
     [1],
     [2],
     [3]
     ]
feature = [
      [0.1, 0.2, 0.3, 0.4, 0.5],
      [0.11, 0.21, 0.31, 0.41, 0.51],
      [0.6, 0.7, 0.8, 0.9, 1.00],
      [1.1, 1.2, 1.3, 1.4, 1.5],
      ]
解决方案
最初尝试使用Python自带的xlrd等库进行操作,但发现效果不佳,难以满足需求。
因此转换思路,改用第三方库openpyxl来处理Excel文件。
安装命令:pip install openpyxl
官方文档地址如下。
https://openpyxl.readthedocs.io/en/stable/index.html
数据写入代码实现
代码实现
直接展示核心代码。
# coding=utf-8
from openpyxl import Workbook
import numpy as np

wb = Workbook()

ws = wb.create_sheet("che")
label = [[0],
     [1],
     [2],
     [3]
     ]
feature = [
      [0.1, 0.2, 0.3, 0.4, 0.5],
      [0.11, 0.21, 0.31, 0.41, 0.51],
      [0.6, 0.7, 0.8, 0.9, 1.00],
      [1.1, 1.2, 1.3, 1.4, 1.5],
      ]
#这个地方之所以 变成numpy格式是因为在很多时候我们都是在numpy格式下计算的,模拟一下预处理
label = np.array(label)
feature = np.array(feature)

label_input = []
for l in range(len(label)):
  label_input.append(label[l][0])

ws.append(label_input)
for f in range(len(feature[0])):

  ws.append(feature[:, f].tolist())
wb.save("chehongshu.xlsx")
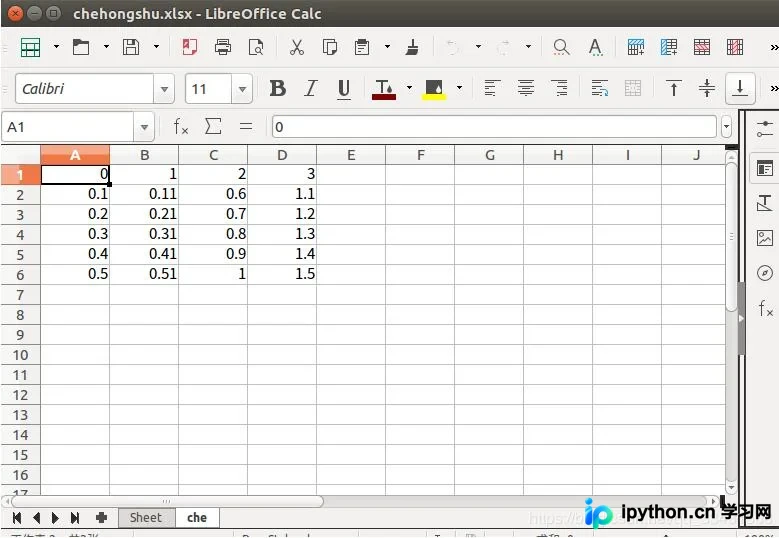
运行代码后生成Excel文件,最终结果如下图所示。
写入机制与Insert限制分析
总结
openpyxl库的使用非常便捷。对于写入操作,只需建立一个列表(LIST)并使用append方法即可。如果Excel文件为空,append操作会从第一行开始递增写入;可以理解为ws.append()操作等同于写入一行。如果Excel中已有数据,写入操作将从没有数据的下一行开始。此外,关于insert方法,需要注意其前提条件:例如要在第7行之前插入一行(即插入到现有第7行之前),要求当前数据行数必须大于要插入的行数或列数。这意味着insert只能插入到数据内部,而不能在边缘位置插入。
行列插入与数据读取示例
插入核心参考代码
for col in range(len(label)):

  print col
  ws.insert_cols(col+1)

  for index, row in enumerate(ws.rows):
    #print row

     if index == 0:
      #row[col+1].value = label[col][0]
      print "label"
      print label[col]
    else:
      print "feature"
      print feature[col][index-1]
      #row[col+1].value = feature[col][index-1]
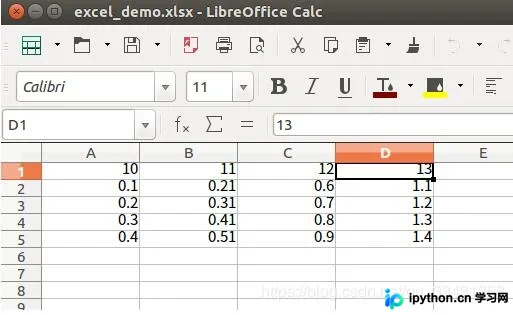
读取代码示例
def create_data_expansion(path, sheet):
  data_init = pd.read_excel(path, sheet)
  # print data_init
  data_df = pd.DataFrame(data_init)
  print data_df
  data_df_transponse = data_df.T
  label_expansion = np.array(data_df_transponse.index)
  label_expansion_l = []
  for l in range(len(label_expansion)):
    label_expansion_l.append([l])
  feature_expansion = np.array(data_df_transponse)
  label_expansion = np.array(label_expansion_l)

  return label_expansion, feature_expansion

if __name__ == "__main__":
  path_name = "excel_demo.xlsx"
  sheet_name = "11"
  label, feature = create_data_expansion(path_name, sheet_name)
  print label
  print feature
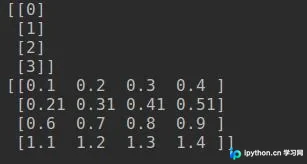
运行结果:
以上关于Python3.7使用openpyxl在Excel单元格中写入数据的实例分享完毕,希望能对大家有所帮助,欢迎支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















